
大模型应用开发 / 系统课时
排查响应过慢
排查响应过慢
响应慢需要先回答“时间耗在哪里”,而不是直接更换模型。把一次请求拆成排队、检索、工具调用、模型首字延迟和生成阶段,分别记录耗时后,才能判断应该缩短上下文、优化外部服务,还是处理并发与限流。
学习目标
- 将端到端延迟拆成可观测的请求阶段
- 根据耗时数据定位模型、检索、工具、上下文或并发瓶颈
- 使用分位数和流式指标验证优化效果
先拆开端到端延迟
只记录“请求总共用了 3 秒”几乎无法定位问题。至少应区分排队时间、检索时间、外部工具时间、模型首字时间以及持续生成时间。启用流式响应时,还要把首字延迟与完整响应时间分开,因为两者影响的用户体验并不相同。
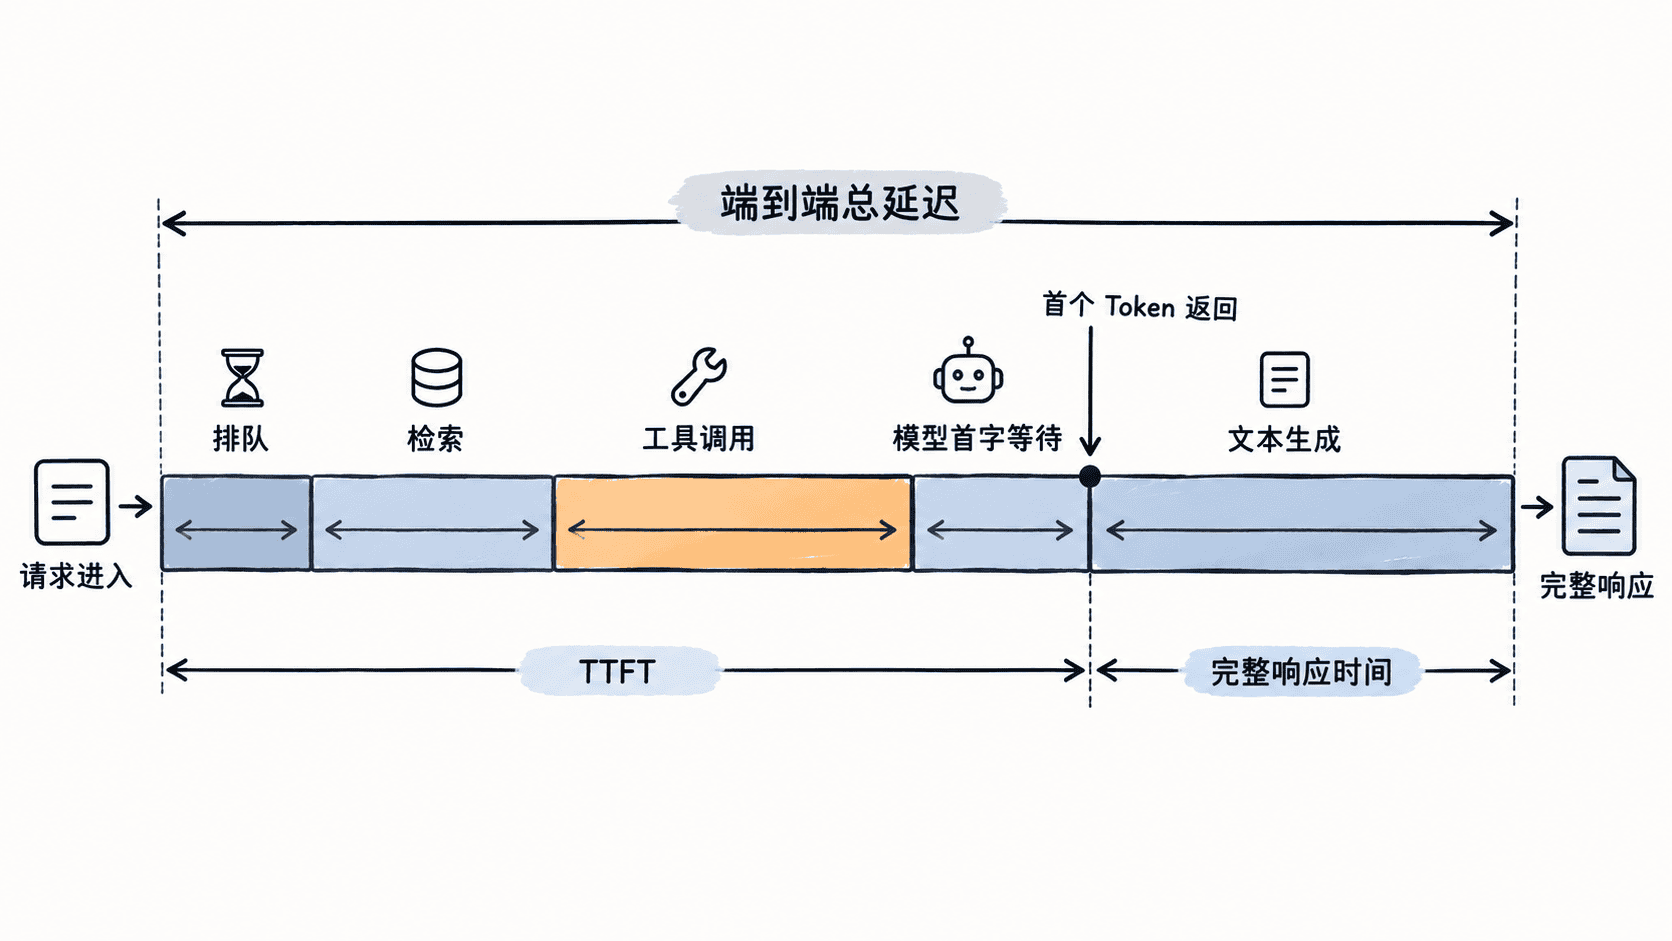
端到端耗时可以近似看成各串行阶段耗时之和。如果工具之间可以安全并行,总耗时则更接近最长并行分支加上前后串行阶段,因此排查时还要确认调用关系,不能简单把所有子请求耗时机械相加。
用阶段计时找到最大瓶颈
下面的可运行示例分析一次已经采集好的请求耗时。真实应用可在网关、检索器、工具执行器和模型客户端周围记录同类时间戳,再把数据送入日志或链路追踪系统。
stages_ms = {
    "queue": 40,
    "retrieval": 180,
    "tool": 850,
    "model_ttft": 420,
    "generation": 620,
}

total = sum(stages_ms.values())
bottleneck = max(stages_ms, key=stages_ms.get)
share = stages_ms[bottleneck] / total * 100

print(f"总耗时: {total} ms")
print(f"最大阶段: {bottleneck}")
print(f"阶段耗时: {stages_ms[bottleneck]} ms")
print(f"占比: {share:.1f}%")
预期输出
总耗时: 2110 ms
最大阶段: tool
阶段耗时: 850 ms
占比: 40.3%
这个结果说明当前请求首先应该检查工具服务,而不是贸然缩短模型输出。若工具调用依赖外部 HTTP 服务,应继续拆分连接、服务端处理、重试和超时等待,直到能指出具体慢点。
根据慢点选择处理方式
模型阶段慢时,先区分首字慢还是生成慢。首字延迟通常要结合输入长度、模型负载和排队情况检查;生成阶段持续时间则同时受输出长度和生成速度影响。用户不需要完整长答案时,限制无效输出往往比单纯更换模型更直接。
检索阶段慢时,查看向量检索、关键词检索、元数据过滤和重排各自的耗时。不要一开始就删除检索步骤,可以先减少不必要的候选量、合并批量请求,并确认数据库连接和跨区域网络是否成为主要成本。
工具调用慢时,需要分别记录每个工具的耗时、超时与重试次数。没有依赖关系的调用可以考虑并行;存在先后依赖的工具不能为了降低数字而强行并发,否则可能用未完成的数据发起后续请求。
上下文过长会增加需要处理的输入量,也容易把检索和模型阶段同时拖慢。优先删除重复片段、无关历史消息和不再需要的工具结果,并保留当前任务真正需要的约束与证据。
排队时间明显增加时,应检查应用工作线程、连接池、任务队列以及模型服务的并发或速率限制。此时单个请求本身可能很快,但高峰期仍会因为等待执行资格而表现为整体变慢。
用分位数验证而不是看单次请求
优化前后应在相同负载下比较端到端耗时以及各阶段的 p50、p95 等分位数。平均值容易掩盖少量极慢请求,而线上体验通常更容易被尾部延迟影响。流式接口还应单独记录首字延迟和完整生成时间。
当阶段耗时能够被持续记录,并且在目标并发下 p95 的主要瓶颈已经下降,同时准确性和业务结果没有退化,这次性能优化才算完成;单次请求偶然变快不能作为验收依据。