
大模型应用开发 / 系统课时
处理文档页面
处理文档页面
复杂文档处理的关键,不是把 PDF 一次性“读成文本”,而是按页同时保留解析文本与页面图像:文本负责精确内容,图像负责版式、表格和视觉关系。这样才能稳定处理扫描件、多栏排版和复杂表格,并保留可核验的页码来源。
学习目标
- 判断一页应使用纯文本、页面图像,还是两者联合处理
- 建立页级输入结构,避免表格、阅读顺序和扫描页信息丢失
- 用可验证的规则检查页级结果是否可信
页面处理为什么需要两种输入
解析文本擅长保留字符、段落和可搜索内容,但它常把多栏页面串成错误顺序,也可能丢失合并单元格、图注与页眉之间的空间关系。页面图像恰好相反:它能保留二维布局,却不适合直接承担精确字符检索。
因此,稳定做法是把“文本证据”和“视觉证据”放在同一个页级任务里。文本层可靠时,不要重复 OCR;出现扫描页、复杂表格、公式、图表或多栏版式时,再让页面图像参与判断。
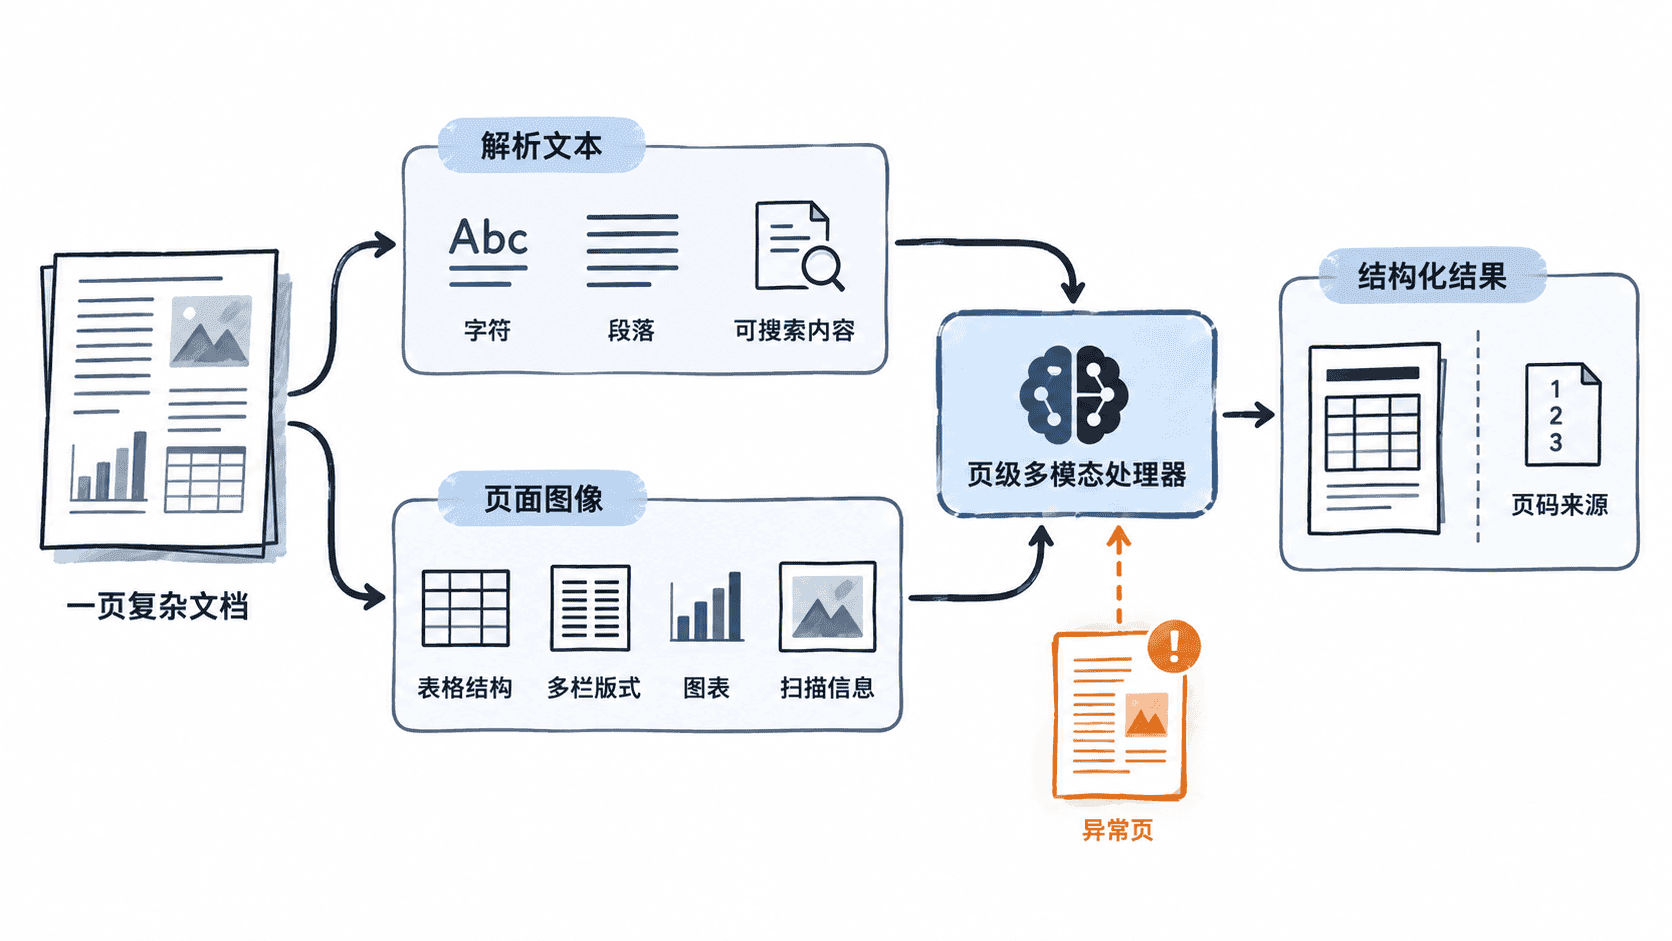
建立页级处理单元
不要把整份文档直接拼成一个超长输入。更稳妥的单位是一页:记录页码、解析文本、页面图像引用,以及少量用于路由的质量信号。这样既方便并行处理,也能在结果异常时回到原页复核。
下面的最小示例演示如何根据文本覆盖率、表格和图片信号选择处理模式。它不负责解析 PDF,而是负责“解析完成之后如何决定这一页走哪条路径”。
from dataclasses import dataclass

@dataclass
class PageInput:
    page_no: int
    text: str
    text_coverage: float
    has_table: bool
    has_image: bool

def choose_mode(page: PageInput) -> str:
    # 文本覆盖率很低时,优先按扫描页处理并补 OCR。
    if page.text_coverage < 0.15:
        return "image+ocr"
    # 版式或视觉对象可能影响语义时,同时保留文本与页面图像。
    if page.has_table or page.has_image:
        return "text+image"
    return "text"

pages = [
    PageInput(1, "项目概览与结论", 0.92, False, False),
    PageInput(2, "季度收入", 0.88, True, False),
    PageInput(3, "", 0.03, False, True),
]

for page in pages:
    print(f"page={page.page_no} mode={choose_mode(page)}")
预期输出:
page=1 mode=text
page=2 mode=text+image
page=3 mode=image+ocr
真实文档中的覆盖率阈值需要用样本校准;这里的 0.15 只是路由示例,不应直接当成生产默认值。
让文本与页面图像各司其职
联合处理时,先明确两种输入的职责。正文字符、数字和可复制文本优先相信解析文本;表格跨列关系、页内阅读顺序、图表对应关系和扫描内容则由页面图像补充。模型若发现二者冲突,应把冲突位置连同页码返回,而不是自行猜测。
复杂表格尤其要避免只把文本按换行拼接。正确结果至少要保住行列关系、表头层级和单位;若解析器已经给出单元格坐标,可以把结构化单元格与页面图像一起交给后续步骤,让图像只承担“校验布局”的职责。
扫描件则相反:页面图像是主输入,OCR 文本只是候选证据。对低质量扫描、倾斜页面或手写批注,应保留“无法确认”的状态,不要为了生成完整文本而补写不存在的内容。
验收页级结果
页级处理至少检查四件事:文本是否忠于原页、阅读顺序是否正确、表格拓扑是否保留、每条结果能否追溯到页码。对数字、金额、日期和表格汇总值,还应抽样回看页面图像。
最终输出最好仍按页保存结构化结果,再在文档级阶段做跨页合并。这样既能利用多模态能力,也不会失去定位错误和重新处理单页的能力。