
大模型应用开发 / 系统课时
组合混合检索
组合混合检索
单纯向量检索擅长语义相近问题,却可能忽略精确术语、错误码和专有名称;关键词检索正好相反。混合检索把关键词、向量和元数据过滤组合起来,再统一融合候选结果,使复杂查询获得更稳定的召回。
学习目标
- 判断关键词检索与向量检索各自能够补充什么候选
- 将元数据过滤、双路召回和结果融合组成完整检索链路
- 使用排名融合避免直接比较不同检索器的原始分数
为什么需要多路召回
用户问题经常同时包含精确词和语义意图。例如“订单超时怎么补偿”中的“订单”“超时”适合关键词匹配,而“异常恢复”“补偿策略”等近义表达更容易被向量检索发现。只使用其中一路,就可能漏掉另一种表达方式。
元数据过滤解决的是第三个维度:即使文本高度相关,也可能来自错误产品、租户或文档版本。一个常见链路是先确定允许检索的业务范围,再并行执行关键词与向量召回,最后合并两个候选集合。
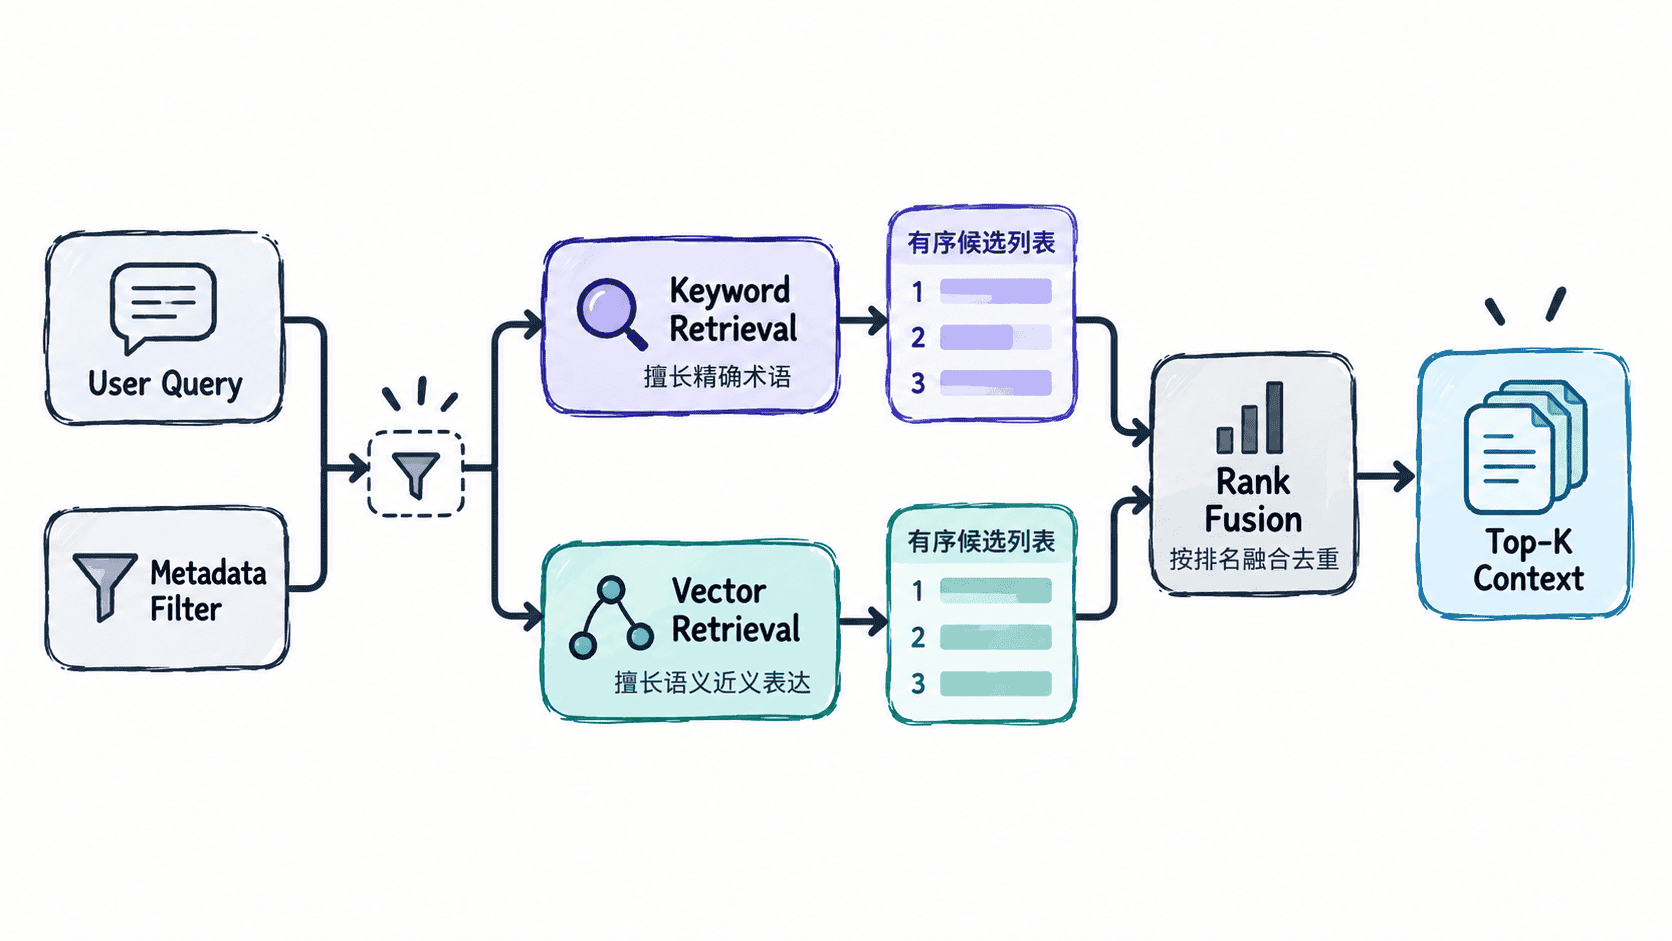
用排名融合组合两种结果
不同检索器的分数通常不能直接相加。例如关键词检索可能输出 BM25 分数,而向量检索可能输出余弦相似度。更稳妥的基础做法之一是按各自排名进行融合。下面使用加权 Reciprocal Rank Fusion:每条结果根据它在各路列表中的名次累计 weight / (k + rank)。
from math import sqrt


def cosine_similarity(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    norm_a = sqrt(sum(x * x for x in a))
    norm_b = sqrt(sum(x * x for x in b))
    return dot / (norm_a * norm_b)


docs = [
    {"id": "d1", "text": "订单支付超时后的补偿处理", "vector": [0.6, 0.8], "product": "payment"},
    {"id": "d2", "text": "支付交易异常恢复策略", "vector": [1.0, 0.0], "product": "payment"},
    {"id": "d3", "text": "库存扣减失败回滚", "vector": [0.0, 1.0], "product": "inventory"},
    {"id": "d4", "text": "订单状态查询接口", "vector": [0.8, 0.2], "product": "payment"},
]
query_terms = ["订单", "超时", "补偿"]
query_vector = [1.0, 0.0]

# 先限定产品范围,避免无关业务文档参加两路召回。
filtered = [doc for doc in docs if doc["product"] == "payment"]

keyword_hits = sorted(
    [doc for doc in filtered if any(term in doc["text"] for term in query_terms)],
    key=lambda doc: sum(term in doc["text"] for term in query_terms),
    reverse=True,
)
vector_hits = sorted(
    filtered,
    key=lambda doc: cosine_similarity(query_vector, doc["vector"]),
    reverse=True,
)


def weighted_rrf(rankings, weights, k=60):
    scores = {}
    by_id = {doc["id"]: doc for doc in filtered}
    # 只使用名次参与融合,不直接比较两种检索器的原始分数。
    for hits, weight in zip(rankings, weights):
        for rank, doc in enumerate(hits, start=1):
            scores[doc["id"]] = scores.get(doc["id"], 0.0) + weight / (k + rank)
    return sorted(
        [(score, by_id[doc_id]) for doc_id, score in scores.items()],
        reverse=True,
        key=lambda item: item[0],
    )


results = weighted_rrf([keyword_hits, vector_hits], [0.6, 0.4])
for score, doc in results[:3]:
    print(doc["id"], f"{score:.5f}", doc["text"])
预期输出
d1 0.01619 订单支付超时后的补偿处理
d4 0.01613 订单状态查询接口
d2 0.00656 支付交易异常恢复策略
d1 在关键词路线中排名最高,因此融合后仍位于首位;d2 没有命中“订单、超时、补偿”这些字面词,却因为向量路线排名第一而进入最终候选。d3 在元数据过滤阶段就因属于 inventory 被排除。
调整召回与融合策略
混合检索的重点不是固定采用某个权重,而是根据查询类型调整候选来源。包含错误码、类名、产品型号等精确标识时,可以提高关键词路线的重要性;自然语言描述较长、同义表达较多时,则可以让向量路线承担更多召回任务。
两路检索的候选数量也应独立设置。若每一路只取极少结果,融合算法无法恢复已经漏掉的文档;若每一路取得过多,则会增加去重、重排和后续模型上下文筛选的成本。
判断是否真的提高了召回
验证混合检索不能只看某一次查询的第一名。应准备一组带正确文档标注的真实问题,分别运行关键词检索、向量检索和混合检索,再比较正确文档是否进入 Top-K,同时记录错误业务范围、重复片段和明显无关结果。
如果混合检索只是把两路结果机械堆在一起,却没有提升正确文档进入候选集的比例,就应继续调整元数据过滤、各路候选数量和融合权重。真正有效的混合检索,是让不同召回方式互补,而不是简单增加返回条数。