
大模型应用开发 / 系统课时
切分文档内容
切分文档内容
知识库检索效果往往先受分块质量影响。本节把一份长文档拆成可检索、可回溯的片段:先尊重标题与段落等语义边界,再用模型可接受的长度收口,并用少量重叠避免关键信息刚好被切断。
学习目标
- 能根据检索粒度和模型输入限制确定分块预算
- 能按结构边界优先、长度约束兜底的顺序切分文档
- 能判断重叠范围是否在补上下文,而不是制造重复噪声
先确定分块预算
分块不是“越小越准”或“越大越完整”。块太大时,一个向量会混入多个主题,检索命中后也会浪费生成模型的上下文;块太小时,定义、条件和结论容易被拆散,单个片段失去独立含义。
长度预算至少同时受两个上限约束:向量模型一次能编码多少文本,以及问答阶段愿意给检索结果保留多少上下文。生产系统应使用目标模型对应的 tokenizer 计数,并给标题、来源、页码等元数据预留空间,而不是把模型窗口全部塞给正文。
先按结构切,再按长度收口
结构信息本身就是语义边界。Markdown 标题、自然段、列表项、表格行和代码块都比固定字符位置更适合作为第一层切分点。只有某个结构单元仍然超过预算时,再在句号、问号等句子边界继续拆分。
重叠用于补偿边界信息,例如上一段最后一个定义会被下一段继续引用。重叠过大则会让相邻块高度重复,使向量库返回一组几乎相同的结果。更稳妥的做法是优先复用上一块最后一个语义单元,而不是机械复制固定字符数。
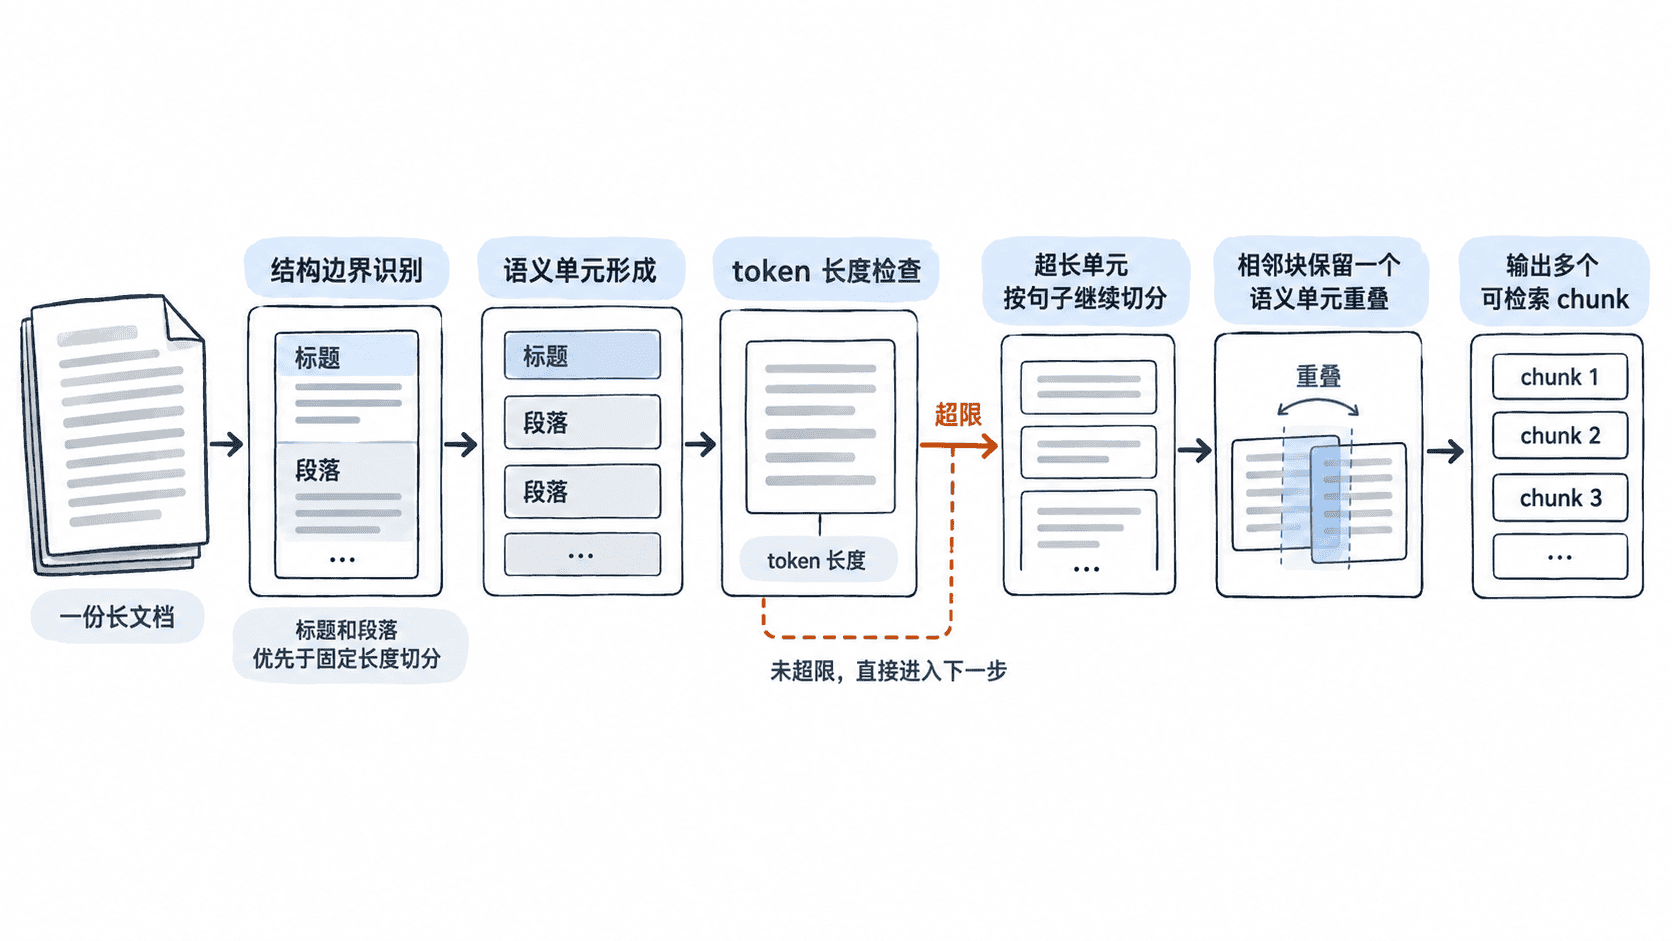
用可运行示例验证边界
下面的最小分块器不依赖第三方库,便于直接观察算法行为。rough_tokens 只是演示用近似计数器;接入真实向量模型时,应替换成该模型的 tokenizer,否则中文、标点和特殊词的实际 token 数可能不同。
import re

def rough_tokens(text: str) -> int:
    pattern = r"[\u4e00-\u9fff]|[A-Za-z0-9_]+|[^\s]"
    return len(re.findall(pattern, text))

def semantic_units(text: str, unit_limit: int) -> list[str]:
    blocks = [b.strip() for b in re.split(r"\n\s*\n", text) if b.strip()]
    units: list[str] = []
    for block in blocks:
        if rough_tokens(block) <= unit_limit:
            units.append(block)
            continue
        # 结构块过长时再按句子边界拆,避免直接从句子中间截断。
        sentences = [s for s in re.split(r"(?<=[。!?!?])", block) if s]
        current: list[str] = []
        for sentence in sentences:
            candidate = "".join(current + [sentence])
            if current and rough_tokens(candidate) > unit_limit:
                units.append("".join(current).strip())
                current = [sentence]
            else:
                current.append(sentence)
        if current:
            units.append("".join(current).strip())
    return units

def chunk_document(text: str, max_tokens: int = 45, overlap_units: int = 1) -> list[str]:
    units = semantic_units(text, unit_limit=max_tokens)
    chunks: list[str] = []
    start = 0
    while start < len(units):
        total = 0
        end = start
        while end < len(units):
            size = rough_tokens(units[end])
            if end > start and total + size > max_tokens:
                break
            total += size
            end += 1
        chunks.append("\n\n".join(units[start:end]))
        if end == len(units):
            break
        # 复用上一个 chunk 的最后一个语义单元作为上下文重叠。
        start = max(start + 1, end - overlap_units)
    return chunks

document = """# 退款规则

退款申请需在订单完成后7天内提交。超过时限不再受理。

## 特殊商品

数字商品激活后不可退款。未激活的数字商品可在24小时内申请。

## 审核

客服会核对订单状态与支付记录,通过后原路退回。"""

for i, chunk in enumerate(chunk_document(document), 1):
    print(f"[chunk {i}] tokens={rough_tokens(chunk)}")
    print(chunk.replace("\n", " / "))
预期输出
[chunk 1] tokens=37
# 退款规则 /  / 退款申请需在订单完成后7天内提交。超过时限不再受理。 /  / ## 特殊商品
[chunk 2] tokens=39
## 特殊商品 /  / 数字商品激活后不可退款。未激活的数字商品可在24小时内申请。 /  / ## 审核
[chunk 3] tokens=27
## 审核 /  / 客服会核对订单状态与支付记录,通过后原路退回。
用检索效果反推分块参数
调参时不要只看平均块长。若返回结果经常缺少定义前提,说明块过小或重叠不足;若前几名结果内容高度重复,说明重叠过大;若一个命中块同时讨论多个无关主题,说明结构切分不够细。
最终应保存 chunk_id、原文来源、标题路径、页码或段落位置等可追溯元数据。这样检索命中后不仅能把正文交给模型,还能定位到原始文档,便于引用、排错和后续重新切分。