
大模型应用开发 / 系统课时
拆分任务步骤
拆分任务步骤
复杂目标一旦交给模型“一次完成”,错误通常会被隐藏在中间过程里。本节把智能工作流拆成输入处理、决策、执行、校验和输出五类步骤,让每一步都有明确输入、结果和失败处理,从而更容易调试、重试与扩展。
学习目标
- 将模糊目标拆成职责单一、可观察的工作流步骤
- 为每一步定义输入、输出和失败边界,避免上下文在步骤间失控
- 判断哪些步骤应由模型完成,哪些应交给确定性代码或外部工具
先按职责拆而不是按代码行拆
拆分的目标不是把流程切得越细越好,而是让每个步骤只承担一种主要职责。一个常见的最小链路是:输入处理 → 决策 → 执行 → 校验 → 输出。
输入处理负责清洗、补全和结构化用户请求;决策负责选择动作或工具;执行负责真正调用外部能力;校验负责检查结果是否满足约束;输出负责把结构化结果转换成用户可理解的答案。这样即使执行失败,也不需要从最开始重新推理。
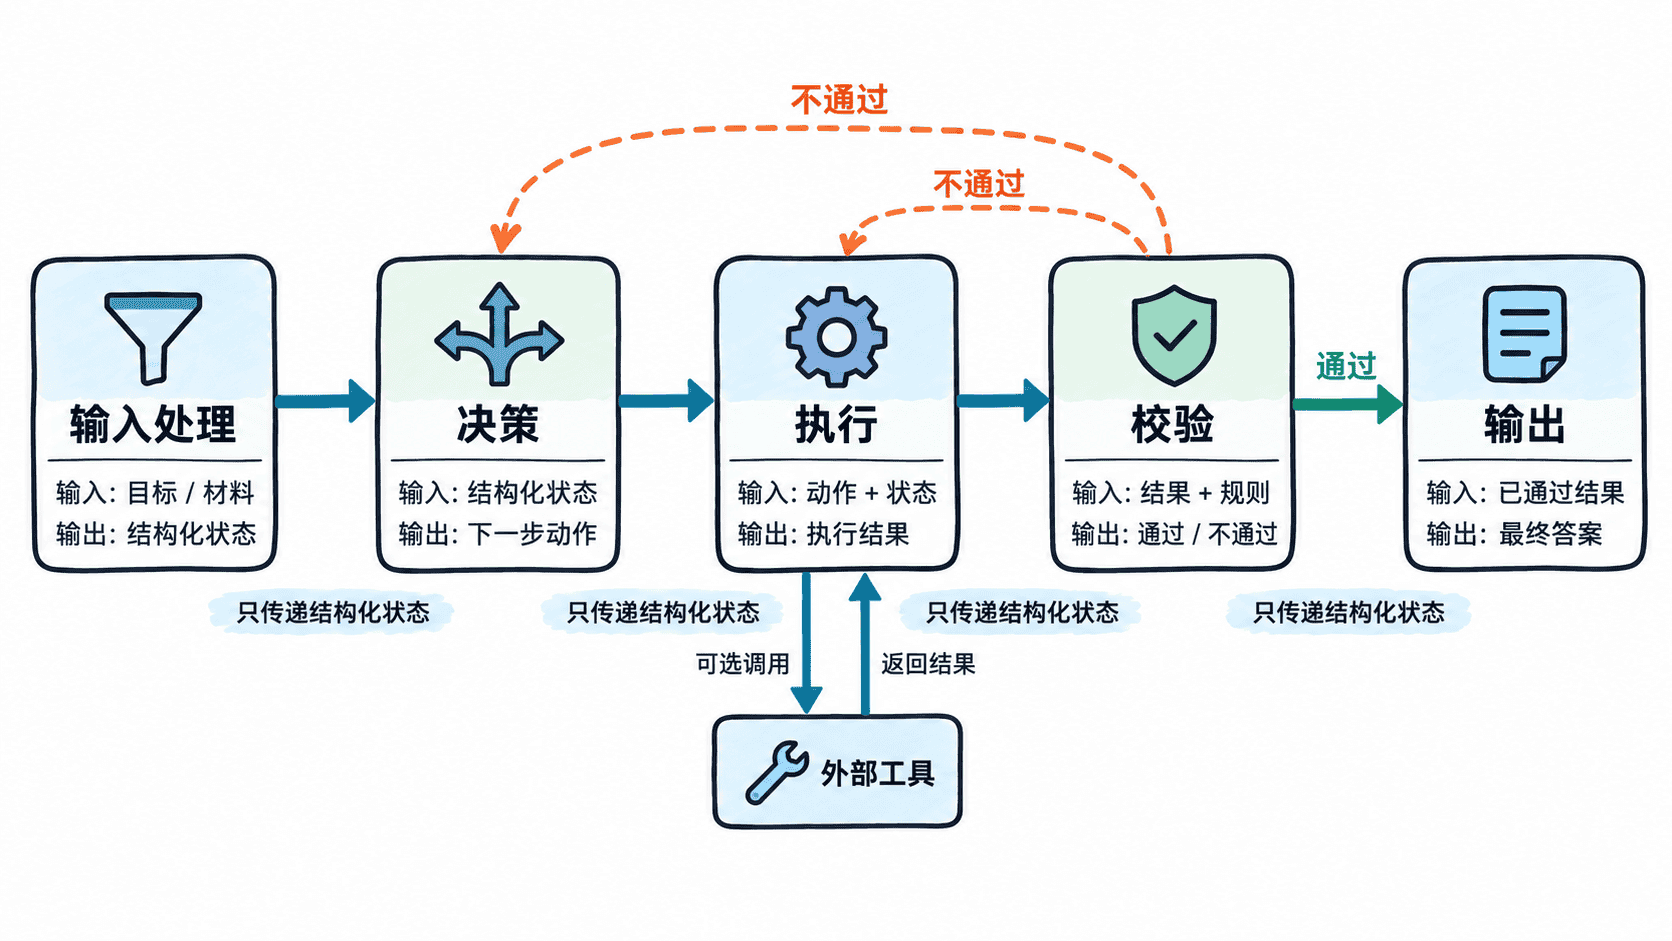
一个步骤值得独立出来,通常因为它满足至少一项条件:需要单独重试、需要不同权限、需要调用外部系统、需要持久化状态,或它的失败处理与上下游不同。反过来,如果两个步骤永远同时执行、共享同一输入输出且没有独立失败语义,拆开反而只会增加编排成本。
为步骤定义可验证的契约
每一步都应有明确契约:接受什么字段、返回什么字段、什么情况算成功、什么情况允许重试。下面用一个“查询订单并判断是否需要人工处理”的最小 Python 工作流示例说明这种边界。
def normalize_input(raw: dict) -> dict:
    order_id = raw.get("order_id", "").strip()
    if not order_id:
        raise ValueError("order_id required")
    return {"order_id": order_id}

def decide_action(state: dict) -> dict:
    state["action"] = "lookup_order"
    return state

def execute_action(state: dict) -> dict:
    # 示例中用固定数据代替真实订单系统,便于独立运行。
    state["order"] = {"id": state["order_id"], "status": "PAID"}
    return state

def validate_result(state: dict) -> dict:
    state["valid"] = state["order"]["id"] == state["order_id"]
    return state

def format_output(state: dict) -> str:
    if not state["valid"]:
        return "订单结果校验失败"
    return f"订单 {state['order_id']} 状态:{state['order']['status']}"

state = normalize_input({"order_id": "A-1001"})
state = decide_action(state)
state = execute_action(state)
state = validate_result(state)
print(format_output(state))
预期输出:
订单 A-1001 状态:PAID这个示例的关键不是函数数量,而是每个函数都有单一职责和稳定状态字段。真实工作流可以把 state 持久化,从失败步骤继续,而不是把整个对话重新执行一遍。
把模型放在最需要判断的位置
模型适合处理模糊输入、分类、计划和文本生成;确定性代码适合做格式校验、金额计算、权限判断和状态转换;外部工具负责查询数据库、调用 API 或执行实际动作。不要因为“这是 Agent”就让每一步都经过模型。
例如,用户说“把这笔订单处理一下”时,模型可以判断缺少具体动作并追问;一旦动作被明确为“退款 100 元”,金额上限、账户权限和幂等检查应由后端代码完成。这样工作流的关键约束不会依赖模型临场发挥。
设计有限重试而不是无限循环
校验失败后可以回到决策或执行,但必须限定次数和可重试条件。网络超时适合重试;参数缺失应回到输入处理;权限不足应直接停止;业务结果不一致则应进入人工处理或补偿流程。
拆分后的工作流应做到三件事:每一步有明确职责,每一步输出可被下一步验证,每一种失败都有确定去向。满足这三点后,复杂任务才从“一次性提示词”变成可测试、可恢复的工程流程。