
大模型应用开发 / 系统课时
重排检索结果
重排检索结果
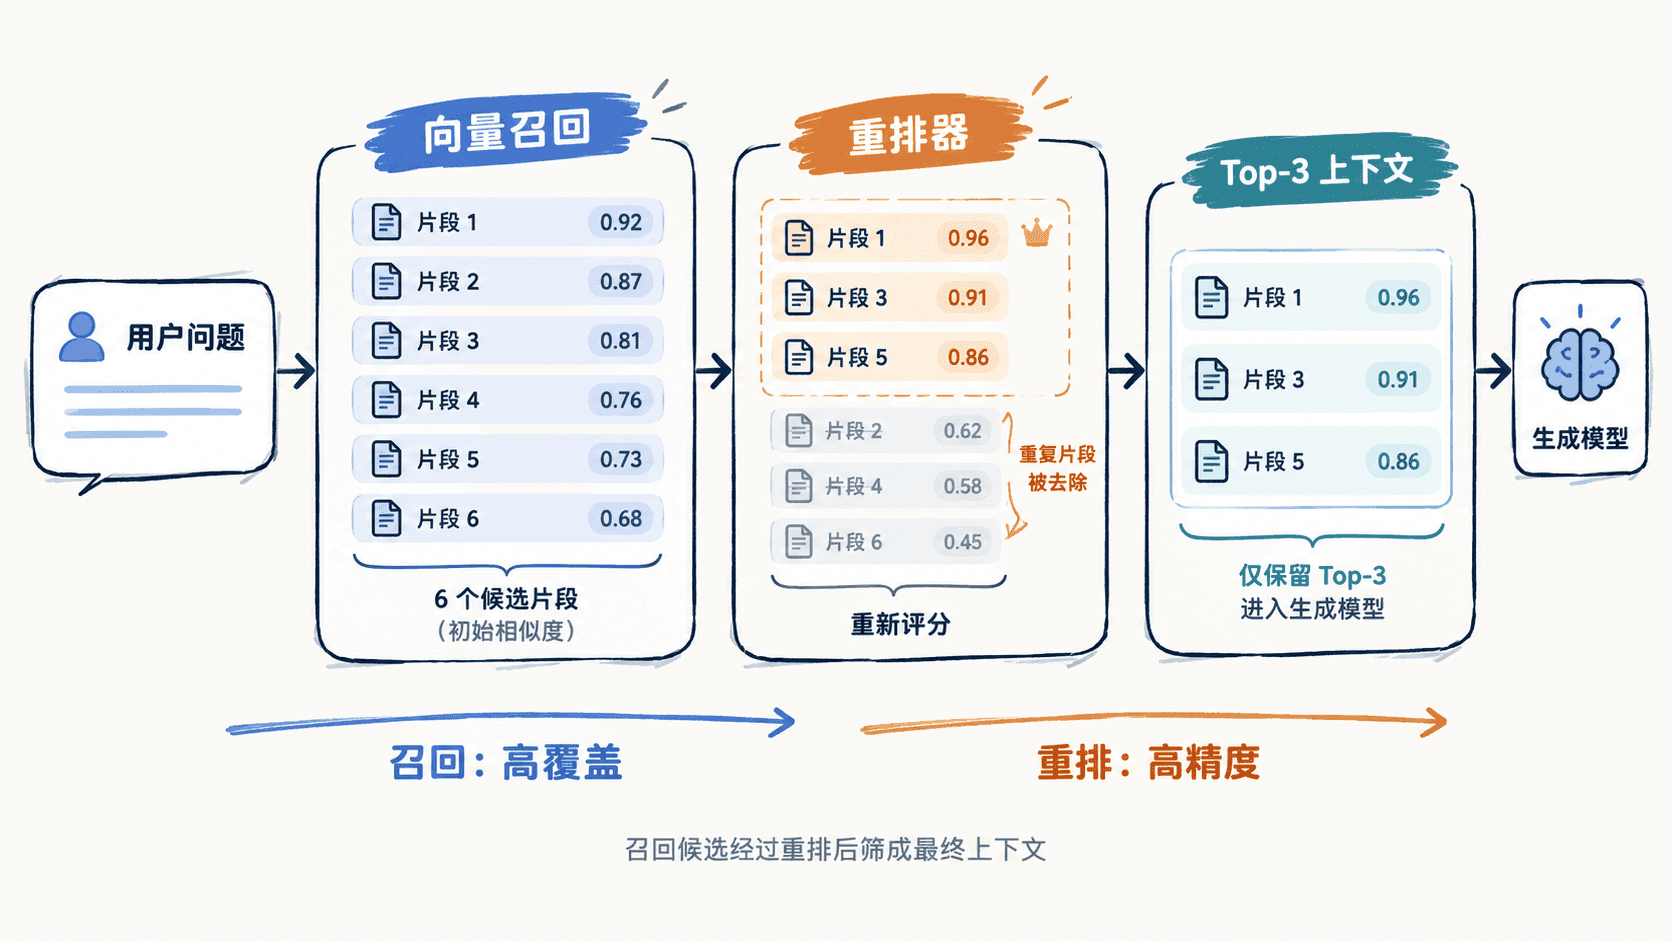
向量召回通常擅长“找得多”,却不保证前几条就是最适合回答的问题。本节把候选片段再次评分、去重并截断,只把高相关且信息互补的上下文交给生成模型。
学习目标
- 说明召回排序与重排的职责差异
- 用规则实现一个可运行的候选片段重排器
- 根据分数、去重和 Top-K 控制最终上下文
为什么召回后还要重排
检索阶段常用向量相似度从大规模知识库中快速召回候选。它优先保证“别漏掉相关内容”,因此前十条里可能混入语义接近但不能直接回答的问题、重复片段,或只在局部关键词上匹配的内容。
重排只处理已经召回的少量候选,可以使用更精细的相关性判断。常见方案包括交叉编码器、LLM 评分和业务规则。它不会替代召回,而是把“高覆盖候选”压缩成“高精度上下文”。
用规则完成一次重排
下面的示例同时考虑查询词覆盖率和原始召回分数,并在排序后去掉完全重复的片段。真实系统可以把 rerank_score 替换成交叉编码器或 LLM 的相关性分数,后续排序、去重和截断逻辑仍然适用。
from dataclasses import dataclass
import re

@dataclass
class Chunk:
    chunk_id: str
    text: str
    recall_score: float

def tokenize(text: str) -> set[str]:
    return set(re.findall(r"[A-Za-z0-9_]+|[\u4e00-\u9fff]", text.lower()))

def rerank_score(query: str, chunk: Chunk) -> float:
    query_tokens = tokenize(query)
    chunk_tokens = tokenize(chunk.text)
    coverage = len(query_tokens & chunk_tokens) / max(len(query_tokens), 1)
    # 保留召回分数作为弱信号,避免规则完全推翻语义召回结果。
    return 0.7 * coverage + 0.3 * chunk.recall_score

def rerank(query: str, chunks: list[Chunk], top_k: int = 2) -> list[tuple[Chunk, float]]:
    ranked = sorted(
        ((chunk, rerank_score(query, chunk)) for chunk in chunks),
        key=lambda item: item[1],
        reverse=True,
    )
    selected: list[tuple[Chunk, float]] = []
    seen_text: set[str] = set()
    for chunk, score in ranked:
        normalized = " ".join(chunk.text.split())
        if normalized in seen_text:
            continue
        seen_text.add(normalized)
        selected.append((chunk, score))
        if len(selected) == top_k:
            break
    return selected

def main() -> None:
    query = "如何减少 RAG 上下文中的重复片段"
    chunks = [
        Chunk("c1", "RAG 重排可以在召回后重新评分候选片段。", 0.91),
        Chunk("c2", "对候选片段去重后再选择 Top-K,可以减少上下文重复。", 0.84),
        Chunk("c3", "向量数据库通过相似度完成第一阶段召回。", 0.93),
        Chunk("c4", "对候选片段去重后再选择 Top-K,可以减少上下文重复。", 0.81),
    ]
    for chunk, score in rerank(query, chunks):
        print(f"{chunk.chunk_id} | {score:.3f} | {chunk.text}")

if __name__ == "__main__":
    main()
预期输出
c2 | 0.702 | 对候选片段去重后再选择 Top-K,可以减少上下文重复。
c1 | 0.473 | RAG 重排可以在召回后重新评分候选片段。
结果中 c4 虽然分数接近 c2,但因正文完全重复被过滤;c3 的原始召回分数最高,却因与问题的直接词项覆盖较低而落到后面。这正是第二阶段重排需要解决的问题。
把规则分数换成模型分数
模型重排通常把“查询 + 单个候选片段”成对输入相关性模型,直接预测候选能否支持问题。由于只对几十条候选执行,它可以比向量召回更精细,但也会增加推理延迟和成本。
工程上应固定三个边界:recall_k 决定重排器要处理多少候选,top_k 决定最终送入生成模型多少片段,最低相关性阈值决定低质量候选是否全部丢弃。应使用离线问答集观察正确片段是否进入最终 Top-K,而不是只看单次分数大小。
防止重排把上下文变差
不要只按单一相关性分数机械取前几名。连续文档切片很容易高度重复,某些片段虽然相关,却缺少回答所需的完整条件。可以在排序后增加来源去重、相邻片段合并、每个文档的最大配额和最低阈值。
一个可用的重排流程应同时满足两点:相关片段上升到前列,并且最终上下文比原始候选更短、更少重复。达到这两个条件后,再把结果交给生成模型。