
计算机视觉 / 系统课时
建立模型迭代闭环
建立模型迭代闭环
本课把“线上发现问题”变成一条可重复执行的改进链路:收集困难样本、重新标注、增量训练、回归评估,再以可回滚方式发布新模型。完成后,你将拥有一套不会只追求单次指标、而能持续稳定提升真实业务效果的迭代流程。
学习目标
- 建立从线上样本回流到模型发布的完整闭环
- 正确组织困难样本、回放样本和不可变数据版本
- 使用统一门槛完成增量训练、回归评估、灰度发布与回滚
闭环不是重复训练
一次有效迭代必须同时回答四个问题:线上哪里失败、数据如何修正、候选模型是否真的更好、发布后能否快速撤回。只重新训练而不做回归评估,可能修复了某类漏检,却让旧场景出现新的误检。
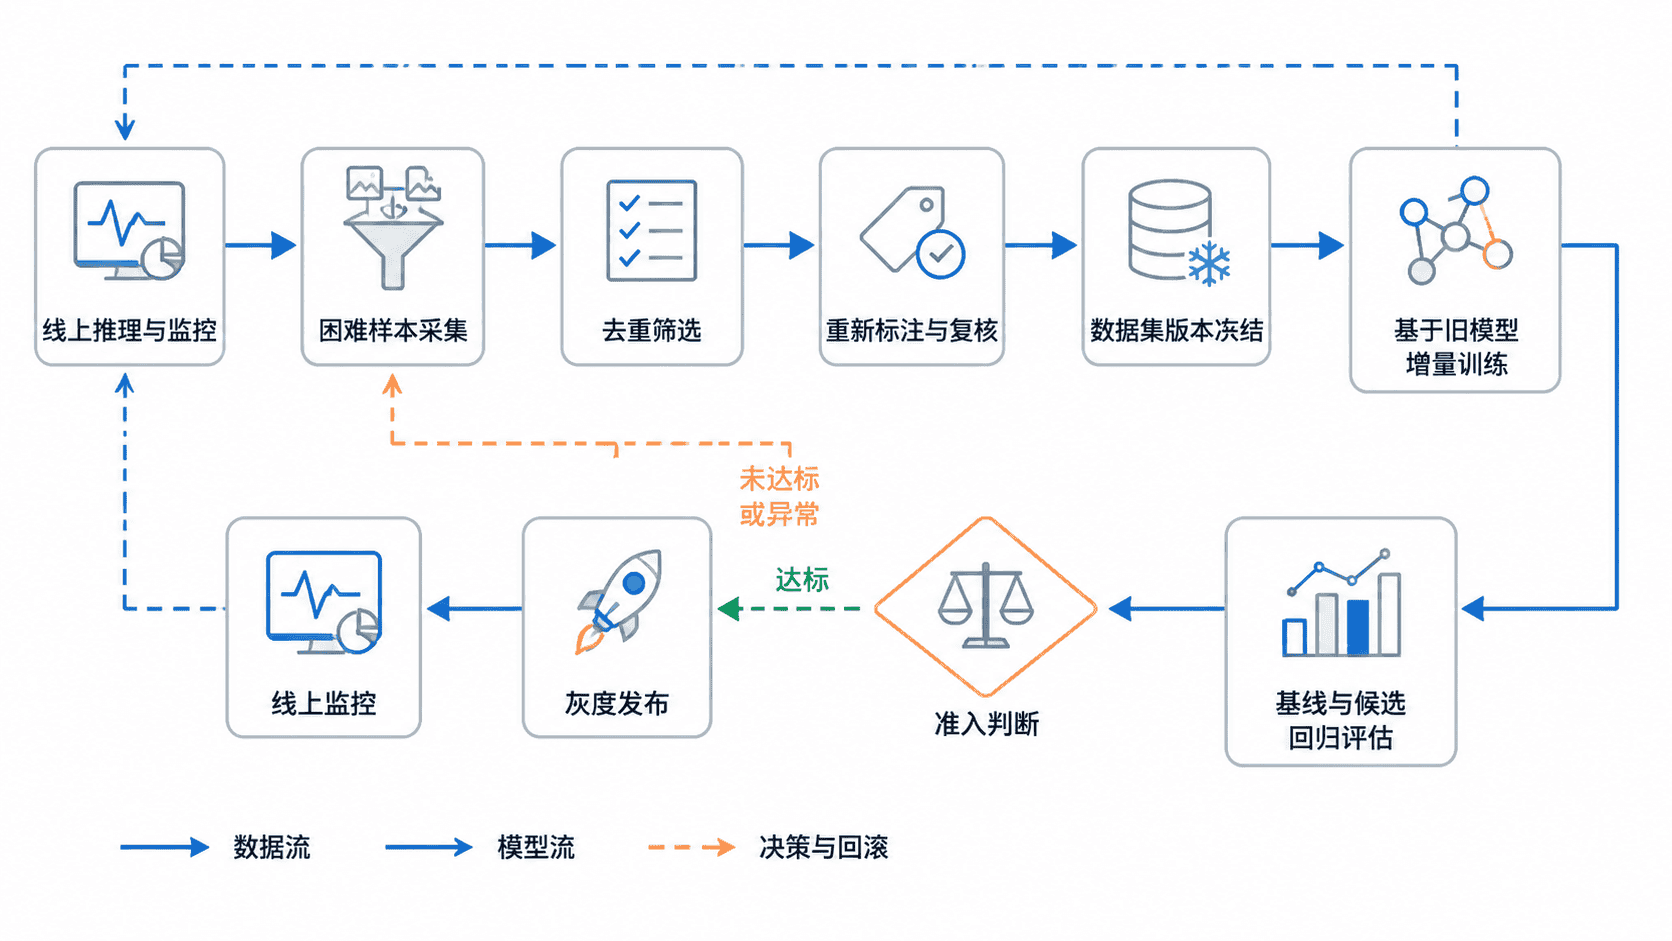
闭环中的每个产物都应可追溯:原始图片有来源和时间,标注有版本与复核记录,训练有参数和代码提交号,模型有评估报告,发布有流量范围和回滚目标。这样才能在指标异常时定位到具体环节。
收集并筛选线上困难样本
困难样本不是“所有线上图片”,而是模型表现不稳定且值得学习的样本。常见来源包括低置信度结果、业务人员纠错、误检与漏检告警、类别冲突、遮挡目标、小目标、逆光以及新设备或新场景。
样本回流时至少记录图片标识、推理模型版本、预测框、置信度、人工结论和采集场景。进入标注前先做脱敏、去重和质量筛选,避免重复图片放大某一场景权重,也不要把模糊到无法判断的图片强行标注。
筛选完成后,将样本分为三类:确定错误的困难样本、用于防止旧能力退化的历史回放样本、只用于最终验收的固定回归集。固定回归集不能参与训练,否则评估结果会因数据泄漏而失真。
重新标注并冻结数据版本
重新标注时应先统一类别边界和框选规则,再由第二位标注人员复核高风险样本。对于“目标被遮挡到什么程度仍需要标注”“相邻目标是否拆框”等问题,必须写入标注规范,不能依靠个人经验临时判断。
每次训练都创建不可变数据版本,例如 difficult-v2。版本中应同时包含新增困难样本和一定比例的历史回放样本,而不是只训练本轮新增数据。只使用困难样本容易让模型过度适配局部场景,并遗忘原来已经稳定的类别。
冻结版本后,检查图片与标签一一对应、类别编号合法、归一化坐标处于 0~1、训练集与验证集没有重复文件。任何标注修改都应生成新版本,不直接覆盖已经用于训练的数据。
执行增量训练与回归评估
下面的脚本应放在 YOLOv5 项目根目录执行。它以当前线上模型作为初始权重,训练候选模型,并在同一份固定回归集上分别评估基线模型和候选模型。运行前需准备 data/difficult-v2.yaml、当前模型权重以及可用的 Python 环境。
#!/usr/bin/env bash
set -euo pipefail

VERSION="${1:?用法: bash iterate.sh <version>}"
DATA_YAML="${DATA_YAML:-data/difficult-v2.yaml}"
BASE_WEIGHTS="${BASE_WEIGHTS:-runs/train/baseline/weights/best.pt}"
RUN_ROOT="${RUN_ROOT:-runs/iterate}"

test -f "$DATA_YAML" || { echo "缺少数据配置: $DATA_YAML" >&2; exit 1; }
test -f "$BASE_WEIGHTS" || { echo "缺少基线权重: $BASE_WEIGHTS" >&2; exit 1; }

python train.py \
  --weights "$BASE_WEIGHTS" \
  --data "$DATA_YAML" \
  --img 640 \
  --epochs 30 \
  --batch 16 \
  --project "$RUN_ROOT" \
  --name "$VERSION" \
  --exist-ok

CANDIDATE="$RUN_ROOT/$VERSION/weights/best.pt"

python val.py \
  --weights "$BASE_WEIGHTS" \
  --data "$DATA_YAML" \
  --img 640 \
  --task val \
  --project "$RUN_ROOT" \
  --name "${VERSION}-baseline" \
  --exist-ok

python val.py \
  --weights "$CANDIDATE" \
  --data "$DATA_YAML" \
  --img 640 \
  --task val \
  --project "$RUN_ROOT" \
  --name "${VERSION}-candidate" \
  --exist-ok

mkdir -p "model-registry/$VERSION"
cp "$CANDIDATE" "model-registry/$VERSION/best.pt"

printf '训练完成:%s\n' "$CANDIDATE"
printf '基线评估:%s\n' "$RUN_ROOT/${VERSION}-baseline"
printf '候选评估:%s\n' "$RUN_ROOT/${VERSION}-candidate"
printf '候选模型已归档:%s\n' "model-registry/$VERSION/best.pt"
预期结果如下。训练过程会包含动态损失、耗时和指标日志;脚本成功结束时至少应出现这些归档信息,其中 <VERSION> 为执行脚本时传入的版本号。
训练完成:runs/iterate/<VERSION>/weights/best.pt
基线评估:runs/iterate/<VERSION>-baseline
候选评估:runs/iterate/<VERSION>-candidate
候选模型已归档:model-registry/<VERSION>/best.pt
评估不能只看总体 mAP@0.5。候选模型还应在固定回归集上检查 mAP@0.5:0.95、各类别召回率、困难样本误检与漏检数量,以及目标设备上的推理延迟。下面是一组可按业务调整的准入示例。
| 检查项 | 示例准入规则 | 目的 |
|---|---|---|
| 总体精度 | mAP@0.5:0.95 不低于基线 |
防止整体能力退化 |
| 目标问题 | 困难样本漏检率明显下降 | 确认本轮问题被修复 |
| 关键类别 | 召回率不得低于业务底线 | 保护高风险类别 |
| 性能 | 同设备延迟增幅不超过约定阈值 | 避免精度提升导致不可部署 |
发布、灰度与回滚
通过准入门槛后,不要立即全量替换模型。先给候选模型分配独立版本号,并保存权重、数据版本、训练参数、代码提交号和评估报告。线上服务返回结果时也应记录模型版本,方便按版本比较错误率。
发布可先采用影子验证或小流量灰度。影子验证只让新模型旁路推理,不影响真实结果;灰度发布则让少量真实请求使用新模型。观察误检率、漏检反馈、推理耗时、显存占用和服务错误率,指标稳定后再逐步扩大流量。
回滚目标必须在发布前确定。若关键指标恶化、服务超时增加或业务纠错量异常上升,应立即切回上一稳定版本,而不是在线临时修改阈值掩盖问题。回滚后的异常样本继续进入下一轮困难样本池,闭环由此再次启动。
闭环验收清单
- 每个困难样本都能追溯到来源、模型版本和人工结论
- 每轮训练都有不可变数据版本、基线权重、候选权重和回归报告
- 发布采用灰度策略,并且可以在不重新构建服务的情况下切回上一版本
- 线上监控能按模型版本统计精度反馈、延迟和错误率
本课总结
- 模型迭代的核心是“样本回流、数据冻结、统一评估、可回滚发布”,而不是反复启动训练
- 增量训练必须混入历史回放样本,并使用独立固定回归集检查新旧能力
- 候选模型只有同时满足精度、关键场景和部署性能门槛,才适合进入灰度发布
下一课预告
完成迭代闭环后,可以把样本筛选、训练、评估和发布进一步接入自动化流水线,让每次模型升级都有统一记录、准入规则和审计结果。