
计算机视觉 / 系统课时
分析基线模型问题
分析基线模型问题
基线模型训练完成后,真正要解决的不是“分数够不够高”,而是哪些样本、类别和配置正在限制效果。本课将用固定评估、指标交叉判断和错误样本复核,把问题归因到数据、训练配置或模型能力。
学习目标
- 在一致条件下复现基线评估结果
- 根据精确率、召回率和分类别指标缩小问题范围
- 用误检、漏检和定位偏差样本验证根因
先固定评估条件
分析前必须锁定数据集版本、验证集划分、输入尺寸和权重文件。否则两次结果的差异可能来自评估条件变化,而不是模型真的变好或变差。
在 YOLOv5 项目根目录执行一次独立验证,并保存预测标签与置信度:
python val.py --weights runs/train/baseline/weights/best.pt --data data/project.yaml --img 640 --batch-size 16 --conf-thres 0.001 --iou-thres 0.6 --save-txt --save-conf --project runs/val --name baseline-audit预期输出:
Class     Images  Instances      P      R   mAP50  mAP50-95
all       <IMAGES> <INSTANCES>   <P>    <R> <MAP50> <MAP50_95>
Results saved to runs/val/baseline-audit<IMAGES>、<P> 等值会随数据集变化。后续实验必须复用同一条验证命令,才能进行公平对比。
从指标判断问题方向
单看总体 mAP 容易掩盖局部问题,应同时查看分类别指标、混淆矩阵、PR 曲线和训练曲线。
| 现象 | 优先怀疑 | 需要复核 |
|---|---|---|
| 精确率高、召回率低 | 漏检、困难样本不足、目标过小 | 低置信度预测与漏检样本 |
| 精确率低、召回率高 | 背景误检、相似类别混淆 | 高频误检场景与混淆矩阵 |
| 训练损失下降但验证指标停滞 | 过拟合或训练、验证分布不一致 | 数据重复、场景差异、增强强度 |
| 少数类别明显落后 | 类别不平衡、标注不一致 | 各类别样本量和标注边界 |
置信度阈值只改变最终保留哪些预测,不会修复训练阶段的数据或特征问题。分析基线时先用较低阈值保存候选框,再在业务验收阶段选择部署阈值。
用错误样本验证假设
将验证结果按误检、漏检、类别错误和定位偏差分组,每组抽取代表样本。指标负责提示方向,样本负责证明原因,二者缺一不可。
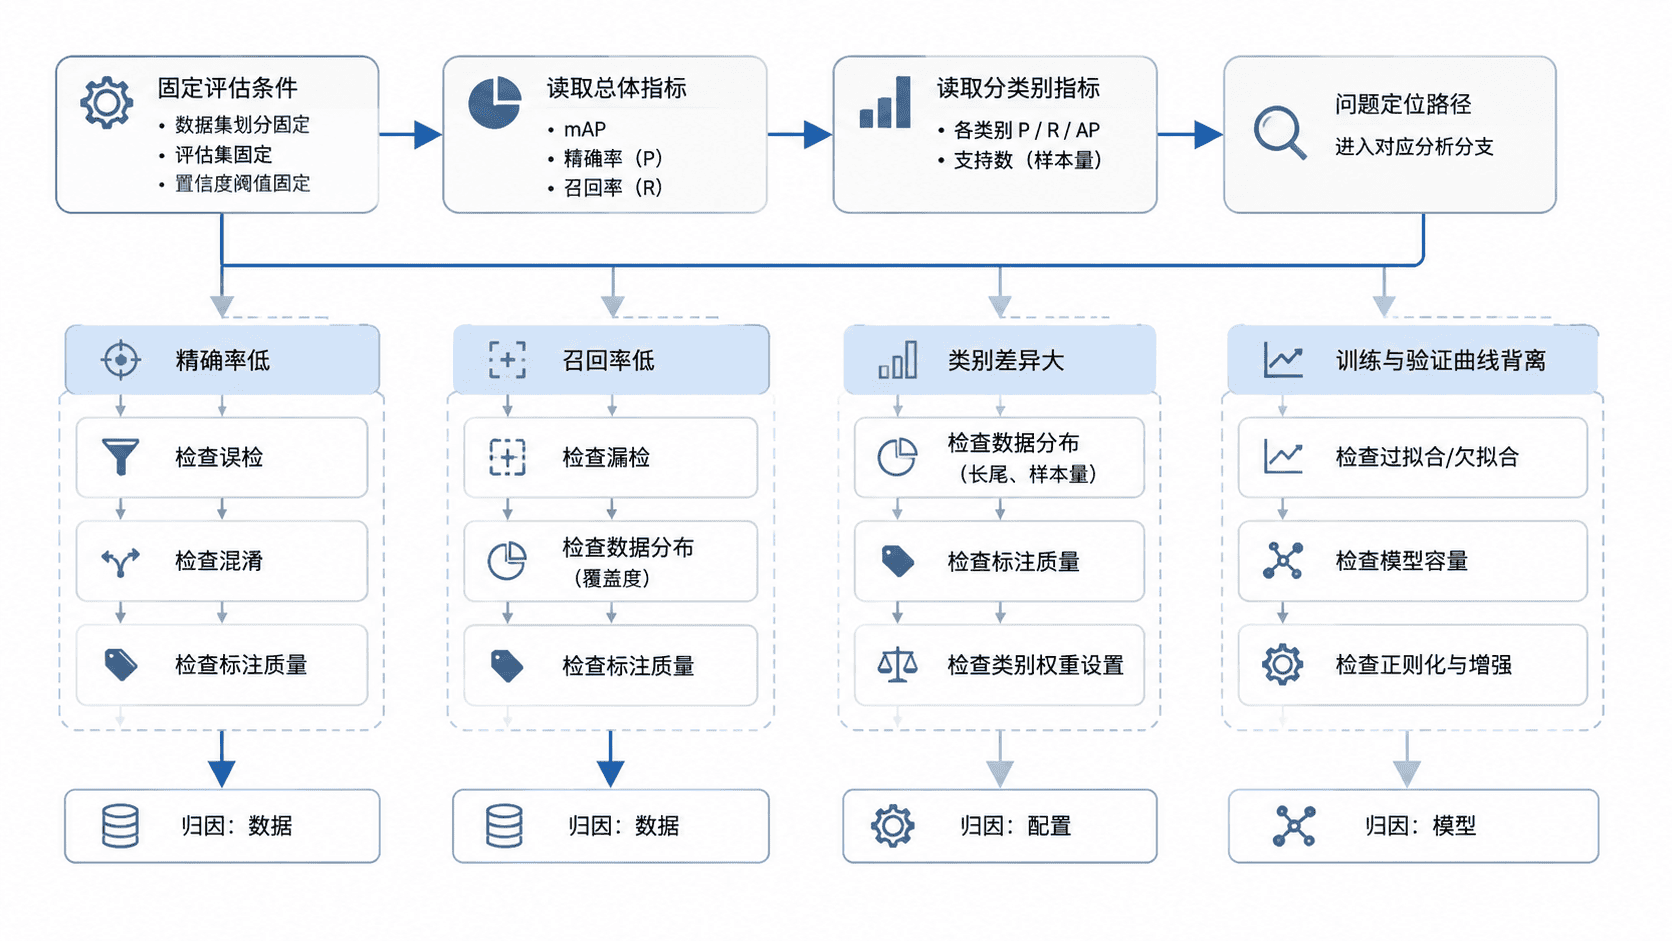
复核时先确认真值标注是否正确,再判断预测是否错误。若标注本身漏框、错类或边界松紧不一致,模型指标会被错误真值污染,不能直接据此调整网络结构。
区分数据、配置与模型问题
数据问题通常具有重复性,例如某种光照下持续漏检、某个类别经常错标、训练集与验证集出现重复图片。配置问题常表现为输入尺寸不适合小目标、训练轮次不足、增强过强或类别映射错误。
只有在数据质量、评估流程和训练配置都已确认后,才考虑模型容量不足。若大模型能稳定改善困难类别,而相同数据上的小模型持续欠拟合,模型规模才是可信的主要变量。
建立基线问题清单
把每个问题记录为“现象、证据、根因假设、修改动作、验收指标”。一次迭代只处理少量高优先级问题,并保留当前权重、数据版本和验证结果,避免修改后无法追溯。
本课总结
- 固定评估条件是所有基线分析的前提
- 指标用于缩小范围,错误样本用于验证根因
- 应先排查数据和配置,再判断是否需要更大模型
下一课预告
下一课将把问题清单转成可执行迭代,依次修正数据、调整训练策略,并用同一验证条件判断改动是否有效。