
计算机视觉 / 系统课时
训练项目基线模型
训练项目基线模型
本课使用固定的数据版本、预训练权重和基础超参数完成第一次可评估训练。目标不是立即追求最高精度,而是得到一套能够复现、能够比较、能够定位问题的基线结果,为后续调参与数据迭代建立参照。
学习目标
- 配置可复现的 YOLOv5 数据入口与基线参数
- 完成训练、验证并定位关键输出文件
- 建立后续实验必须保持一致的对比基准
明确基线实验边界
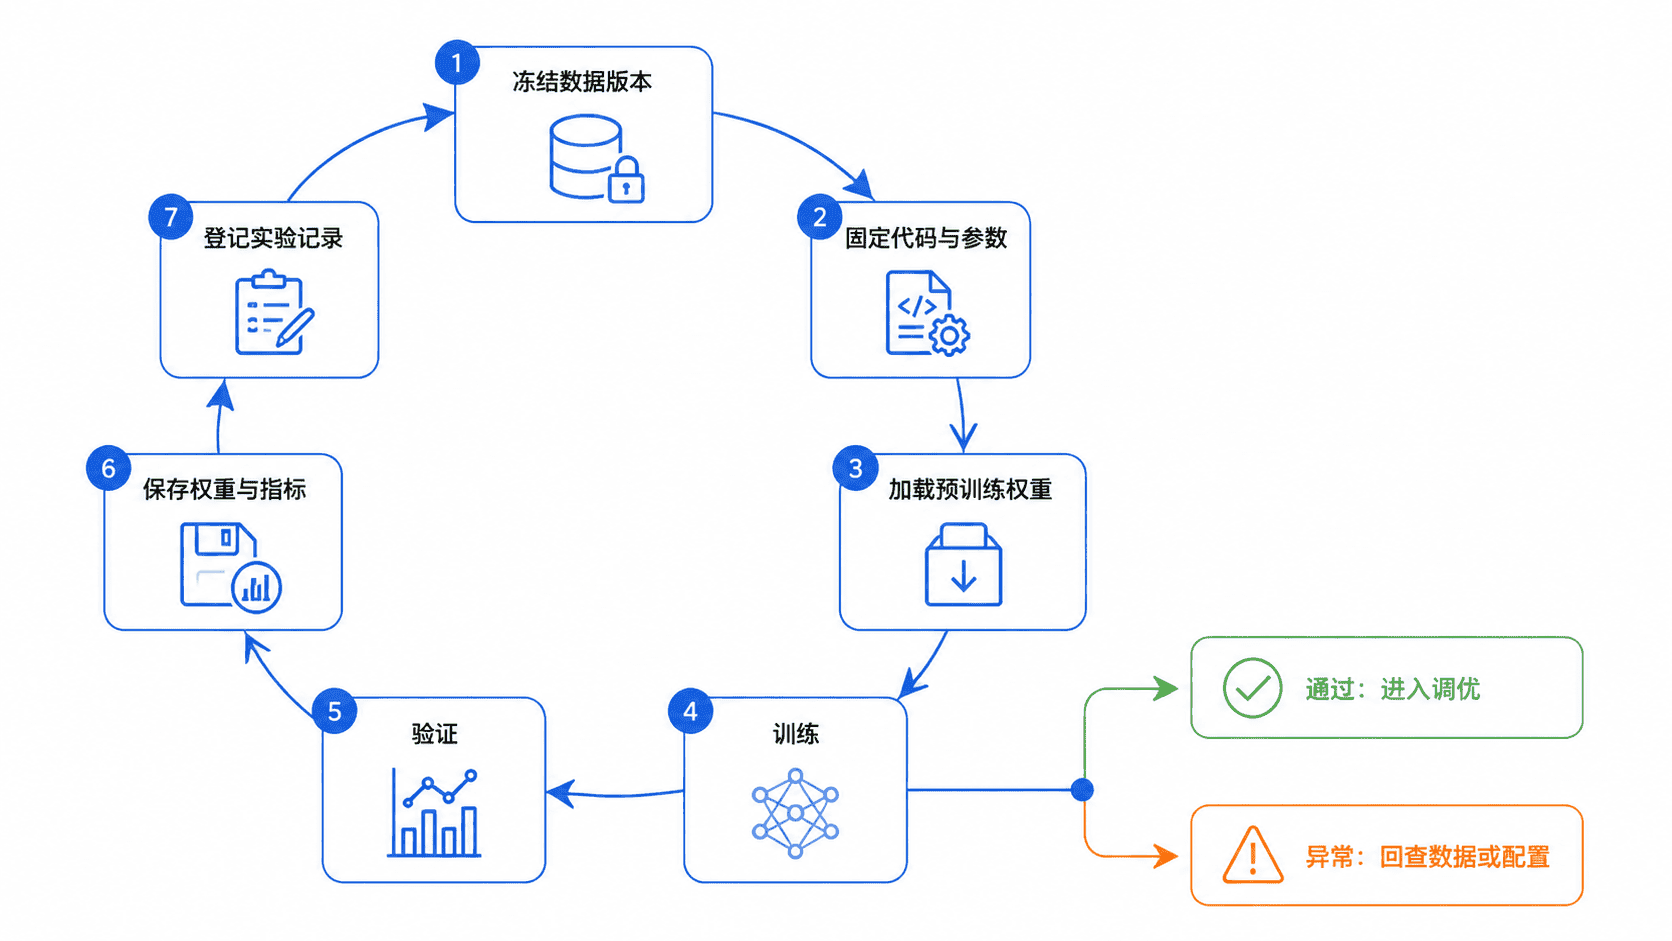
基线模型只回答一个问题:在当前数据质量和默认训练策略下,项目能达到什么水平。因此第一次训练应尽量减少变量,固定数据版本、训练代码版本、输入尺寸、预训练权重、训练轮数和随机种子。
本课采用 yolov5s.pt 作为起点,输入尺寸设为 640,训练 50 个 epoch。batch 需要按显存调整,但调整后必须记录实际值。不要在同一次实验中同时更换数据增强、模型规模和损失参数,否则结果变化无法归因。
准备数据配置
在 YOLOv5 仓库内新建 data/warehouse-ppe.yaml。path 指向数据集根目录,train、val 和 test 都相对该根目录解析;names 的顺序必须与标签中的类别编号完全一致。
path: ../datasets/warehouse-ppe
train: images/train
val: images/val
test: images/test

names:
  0: person
  1: helmet
  2: vest
该配置不是独立程序,生效方式是通过训练命令的 --data data/warehouse-ppe.yaml 参数加载。验证时重点确认三个目录存在、图片可读、标签文件同名配对,并确保类别编号范围为 0~2。
执行训练前检查
在 YOLOv5 仓库根目录运行以下命令。它会显示 Python、PyTorch 与 CUDA 状态,并检查数据配置和预训练权重是否存在。
python --version
python -c "import torch; print('torch=', torch.__version__); print('cuda=', torch.cuda.is_available())"
test -f data/warehouse-ppe.yaml && echo "data config: OK"
test -f yolov5s.pt && echo "weights: OK"
预期输出如下,版本号和 CUDA 状态以当前环境为准:
Python <VERSION>
torch= <VERSION>
cuda= True
data config: OK
weights: OK
若 cuda=False,训练仍可在 CPU 上运行,但速度通常明显降低。若文件检查没有输出,应先修正当前目录、配置路径或权重文件位置,再开始长时间训练。
启动基线训练
下面的命令固定输入尺寸、训练轮数、模型权重、实验名称和随机种子。--exist-ok 允许重复使用同一输出目录,正式实验更建议修改名称,避免覆盖已有结果。
python train.py \
  --img 640 \
  --batch 16 \
  --epochs 50 \
  --data data/warehouse-ppe.yaml \
  --weights yolov5s.pt \
  --seed 42 \
  --project runs/train \
  --name baseline-v1 \
  --exist-ok
预期结果是终端逐轮输出训练与验证指标,并在结束时给出结果目录。数值和耗时会随硬件、代码版本与数据量变化:
Epoch   GPU_mem   box_loss   obj_loss   cls_loss   Instances   Size
...
50 epochs completed in <TIME>.
Results saved to runs/train/baseline-v1
显存不足时,先把 --batch 16 下调为 8、4 或 2。为了保证对比公平,后续实验应沿用最终可运行的 batch,或者在实验记录中明确标记变化。
检查训练产物与验证结果
训练目录通常包含最佳权重、最后一轮权重、指标曲线、混淆矩阵和批次可视化。先检查关键文件是否生成:
test -f runs/train/baseline-v1/weights/best.pt && echo "best.pt: OK"
test -f runs/train/baseline-v1/weights/last.pt && echo "last.pt: OK"
test -f runs/train/baseline-v1/results.csv && echo "results.csv: OK"
预期输出:
best.pt: OK
last.pt: OK
results.csv: OK
然后使用最佳权重在固定验证集上单独评估,避免只依赖训练结束时的一次汇总:
python val.py \
  --weights runs/train/baseline-v1/weights/best.pt \
  --data data/warehouse-ppe.yaml \
  --img 640 \
  --task val \
  --project runs/val \
  --name baseline-v1 \
--exist-okClass Images Instances P R mAP50 mAP50-95
all <N> <N> <VALUE> <VALUE> <VALUE> <VALUE>
Results saved to runs/val/baseline-v1指标不能只看总体行。若某个类别样本少、目标小或标注不稳定,应记录其单类表现,并结合混淆矩阵和预测样例判断问题来自数据、类别边界还是模型能力。
登记可复现实验记录
至少记录代码提交号、数据版本、权重来源、命令、硬件、随机种子、最佳 epoch、主要指标和输出目录。后续任何调优实验都只改变一个主要变量,并与 baseline-v1 使用相同验证集比较。
建议把 best.pt 视为当前基线候选,把 last.pt 用于恢复训练,把 results.csv 和验证目录作为指标证据。仅保存一个权重文件而没有命令和版本信息,无法构成可复现基线。
本课总结
- 基线训练应固定数据、代码和主要参数,避免一次改变多个变量
best.pt、results.csv与独立验证结果共同构成可比较的基线证据- 后续优化必须使用相同验证集,并完整记录每次实验的唯一变化
下一课预告
下一课将基于基线模型的类别指标、混淆矩阵和错误样例定位主要瓶颈,再决定优先补数据、调整标注还是修改训练参数。