
计算机视觉 / 系统课时
目标检测核心概念
目标检测核心概念
要读懂 YOLOv5 的预测结果,必须先理解边界框、类别、置信度、交并比和非极大值抑制。它们共同决定一个框表示什么、是否准确,以及重复结果该如何删除。
学习目标
- 理解一次检测结果包含的核心字段
- 使用 IoU 判断两个边界框的重叠程度
- 说明非极大值抑制如何删除重复框
一次预测包含什么
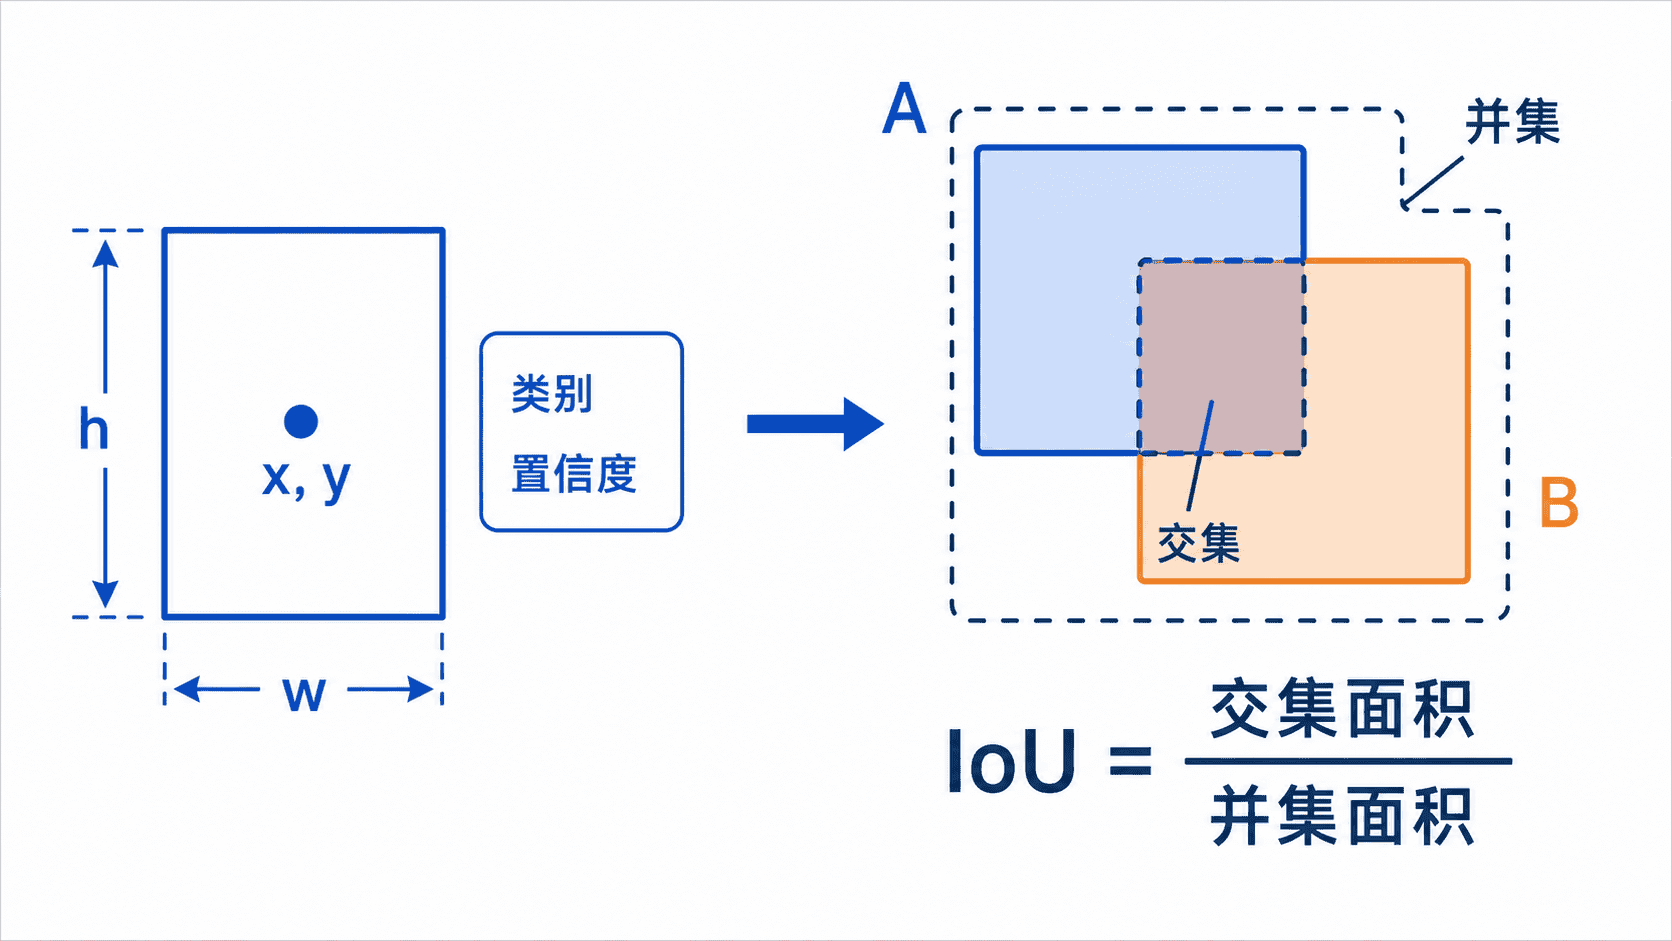
一条检测结果通常包含边界框、类别和置信度。边界框可用左上角与右下角坐标表示,也可用中心点坐标、宽度和高度表示。
类别回答“框内是什么”,例如 person、car 或 dog。置信度用于排序和过滤预测结果,数值越高,说明模型越倾向于保留该结果。
在 YOLOv5 的推理处理中,候选框通常会结合目标存在概率与类别概率形成用于筛选的分数,再与置信度阈值比较。
IoU 衡量框的重叠程度
交并比 IoU 用来衡量两个边界框的重叠程度,取值范围是 0 到 1。
两个框完全不重叠时,IoU 为 0;两个框完全一致时,IoU 为 1。训练评估时,它可用于判断预测框是否足够接近真实框;推理后处理时,它可用于判断两个预测框是否重复。
IoU 只描述几何重叠,不表示类别是否正确,也不等同于置信度。
置信度与类别分数
置信度阈值决定哪些候选框有资格进入后续处理。阈值过低会保留较多误检,阈值过高则可能漏掉本来正确但分数不高的目标。
类别分数表示候选框属于各类别的可能性。一个框可能同时得到 car、bus、truck 等多个类别分数,最终通常保留得分最高的类别,并按阈值过滤。
实际使用时,阈值应根据场景调整。安防告警更怕漏检,可以适当降低阈值;自动化执行更怕误触发,通常需要更严格的阈值和额外规则。
NMS 删除重复框
模型常会围绕同一个目标产生多个高度重叠的候选框。非极大值抑制 NMS 会优先保留高分框,并删除与它过度重叠的低分框。
- 按置信度从高到低排序候选框
- 保留当前分数最高的框
- 计算它与其余同类框的 IoU
- 删除 IoU 高于阈值的重复框
- 对剩余框重复以上过程
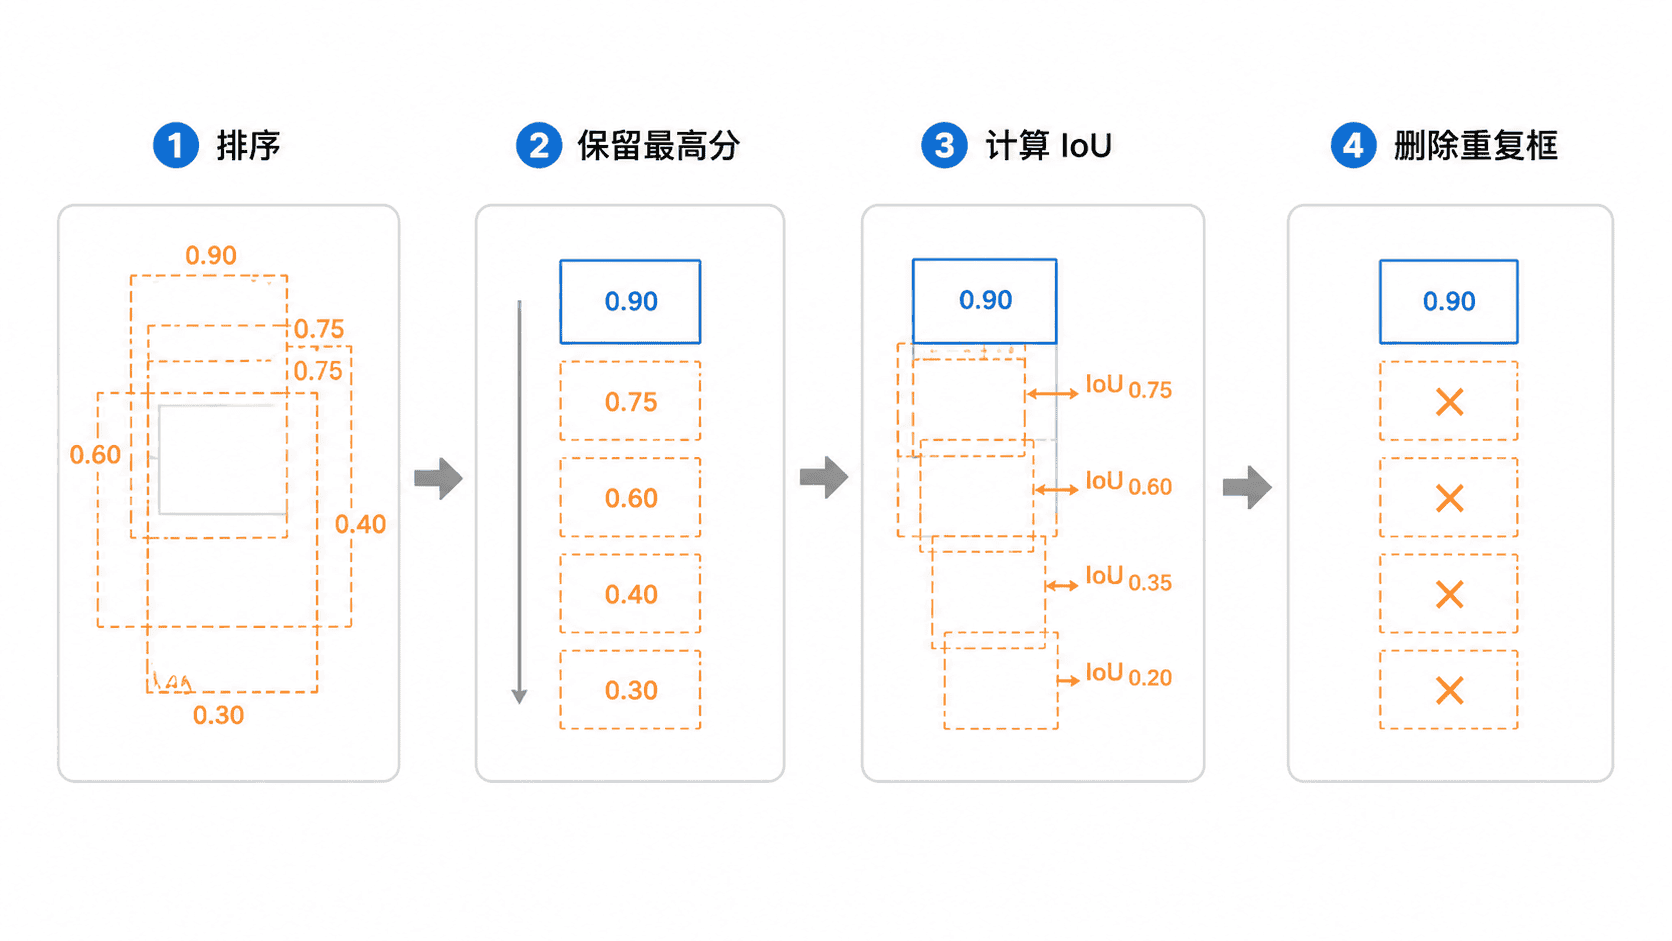
例如,同一辆车有两个预测框,分数分别为 0.92 和 0.74,二者 IoU 为 0.78。若 NMS 阈值为 0.50,则保留 0.92 的框并删除 0.74 的框。不同类别通常分别执行 NMS,避免把相邻但类别不同的目标误删。
容易混淆的边界
IoU 高不代表置信度高;它只说明两个框的位置接近。NMS 也不会修正框的位置,只负责减少重复结果。
置信度阈值和 NMS 阈值作用不同:前者先过滤低分框,后者再处理高重叠框。调参时应分别观察误检、漏检和重复框数量。
本课总结
- 边界框、类别和置信度共同描述一次检测结果
- IoU 衡量几何重叠,不能替代类别或置信度判断
- NMS 通过保留高分框并抑制重复框得到最终结果
下一课预告
下一课将进入 YOLOv5 的整体结构,观察图像如何经过主干网络、特征融合与检测头生成多尺度预测。