
计算机视觉 / 系统课时
调整批量推理
调整批量推理
本课解决逐张推理无法充分利用 GPU 的问题。你将编写一个可运行的批量推理脚本,测量每批耗时、平均单图延迟和总体吞吐量,并根据实时或离线场景选择合适的批量大小。
学习目标
- 区分吞吐量、平均单图耗时和端到端延迟。
- 使用 YOLOv5 一次处理多张图片。
- 通过递增测试找到性能与显存之间的平衡点。
先区分吞吐量与延迟
批量大小表示一次前向计算同时送入模型的图片数量。批量增大后,GPU 可以并行处理更多数据,单位时间完成的图片数通常会上升,这个指标称为吞吐量。
吞吐量可写为 。平均单图耗时则是总推理时间除以图片数,但它不等于用户真正感受到的端到端延迟,因为图片还可能在队列中等待凑满一批。
| 场景 | 推荐倾向 | 主要原因 |
|---|---|---|
| 摄像头实时检测 | 小批量或批量 1 | 优先降低等待时间 |
| 图片离线处理 | 尽可能大的稳定批量 | 优先提高吞吐量 |
| 多路视频流 | 中等批量 | 在等待时间与 GPU 利用率之间折中 |
批量推理的数据路径
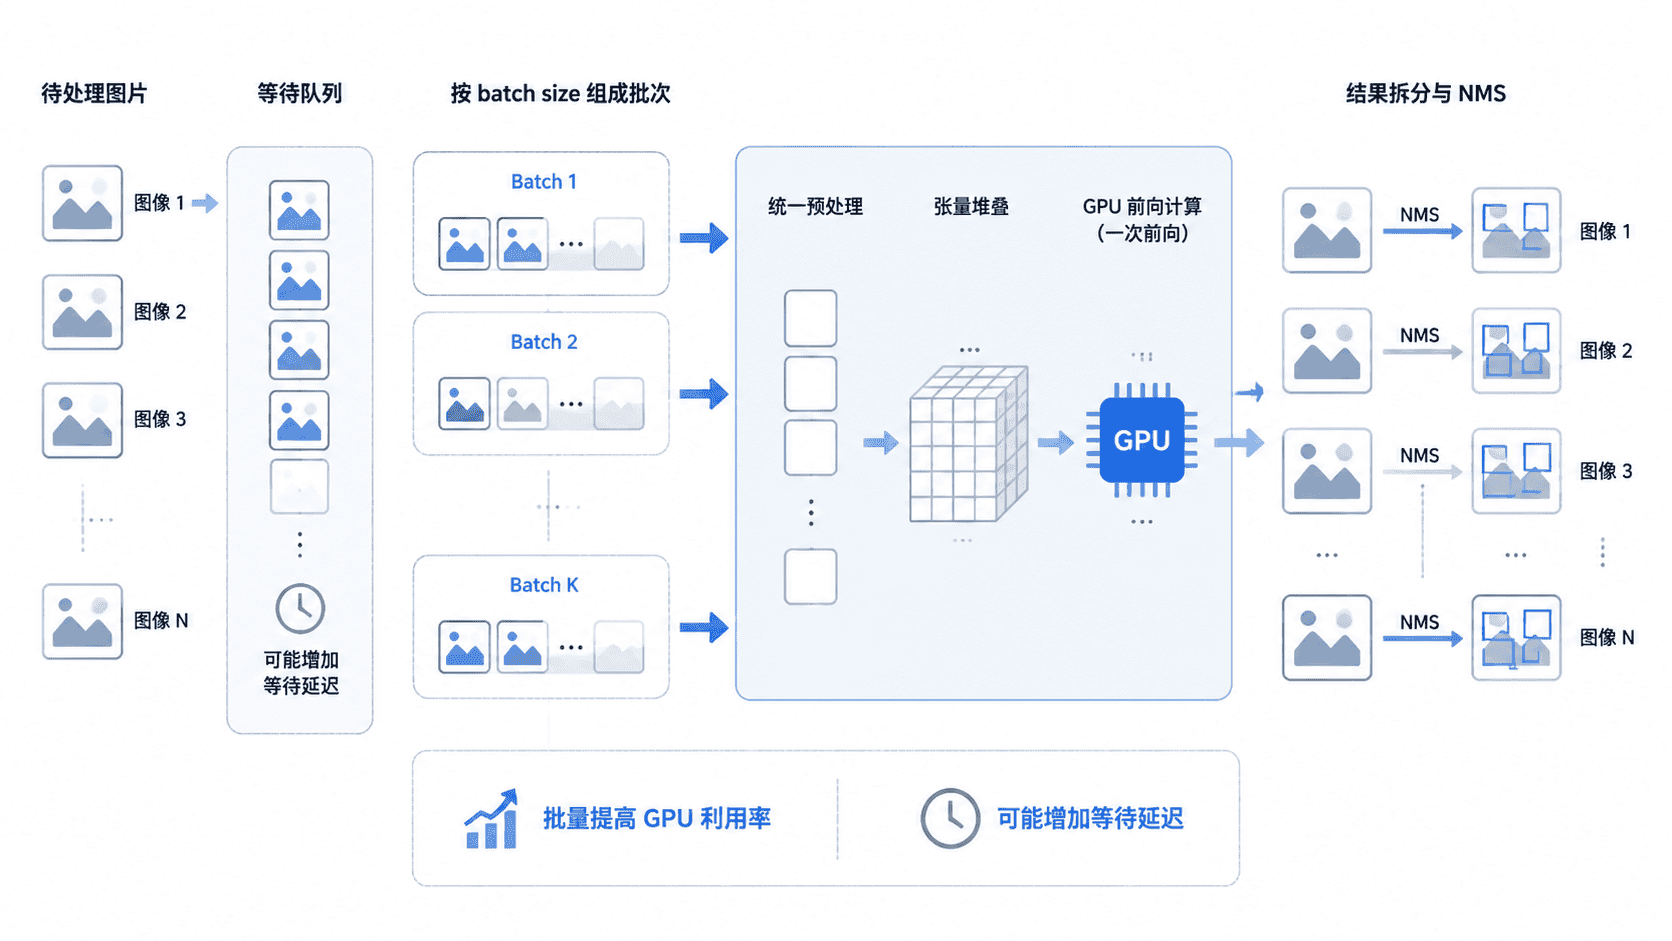
批量推理不是简单地把循环次数减少,而是先收集多张图片,统一完成预处理和张量拼接,再执行一次 GPU 前向计算,最后按图片拆分检测结果。
编写批量推理脚本
下面的脚本应放在 YOLOv5 项目根目录中运行。它通过本地 torch.hub 加载自定义权重,先进行一次预热,再按指定批量大小处理目录中的图片。
import argparse
import time
from pathlib import Path
from typing import Iterator, List

import torch

IMAGE_EXTENSIONS = {".jpg", ".jpeg", ".png", ".bmp", ".webp"}

def split_batches(items: List[Path], batch_size: int) -> Iterator[List[Path]]:
    for start in range(0, len(items), batch_size):
        yield items[start:start + batch_size]

@torch.inference_mode()
def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--weights", required=True)
    parser.add_argument("--source", required=True)
    parser.add_argument("--batch-size", type=int, default=8)
    parser.add_argument("--img-size", type=int, default=640)
    parser.add_argument("--device", default="cuda:0")
    args = parser.parse_args()

    if args.batch_size < 1:
        raise ValueError("batch-size 必须大于等于 1")

    image_paths = sorted(
        path for path in Path(args.source).rglob("*")
        if path.is_file() and path.suffix.lower() in IMAGE_EXTENSIONS
    )
    if not image_paths:
        raise FileNotFoundError("输入目录中没有可推理的图片")

    device = torch.device(args.device)
    model = torch.hub.load(
        ".",
        "custom",
        path=args.weights,
        source="local"
    ).to(device).eval()

    # 预热不计入正式统计,避免首次 CUDA 初始化干扰结果。
    model([str(image_paths[0])], size=args.img_size)
    if device.type == "cuda":
        torch.cuda.synchronize()

    total_images = 0
    total_elapsed = 0.0

    for batch_index, batch_paths in enumerate(
        split_batches(image_paths, args.batch_size),
        start=1
    ):
        if device.type == "cuda":
            torch.cuda.synchronize()
        started = time.perf_counter()

        results = model(
            [str(path) for path in batch_paths],
            size=args.img_size
        )

        if device.type == "cuda":
            torch.cuda.synchronize()
        elapsed = time.perf_counter() - started

        detections = sum(len(prediction) for prediction in results.xyxy)
        total_images += len(batch_paths)
        total_elapsed += elapsed

        print(
            f"Batch {batch_index}: {len(batch_paths)} images, "
            f"{detections} detections, {elapsed * 1000:.1f} ms"
        )

    throughput = total_images / total_elapsed
    average_ms = total_elapsed * 1000 / total_images
    print(
        f"Total: {total_images} images, "
        f"throughput {throughput:.1f} images/s, "
        f"average {average_ms:.1f} ms/image"
    )

if __name__ == "__main__":
    main()
使用批量大小 8 运行脚本:
python batch_infer.py --weights runs/train/exp/weights/best.pt --source data/images --batch-size 8 --img-size 640 --device cuda:0预期输出
Batch 1: 8 images, <DETECTION_COUNT> detections, <BATCH_TIME> ms
Batch 2: <IMAGE_COUNT> images, <DETECTION_COUNT> detections, <BATCH_TIME> ms
Total: <TOTAL_IMAGES> images, throughput <IMAGES_PER_SECOND> images/s, average <AVERAGE_MS> ms/image
占位值会随图片数量、目标数量和硬件性能变化。脚本中的平均耗时只统计模型调用阶段,不包含业务系统中的排队、网络传输和结果持久化时间。
找到合适的批量大小
从批量 1 开始,按 2、4、8、16 逐步增加,每次使用同一批图片执行多轮测试。记录吞吐量、单批耗时、平均单图耗时和峰值显存,直到吞吐量提升趋缓或出现显存不足。
实时系统不能只看平均单图耗时。批量越大,第一张图片等待同批其他图片到达的时间可能越长,因此摄像头或交互式接口通常使用小批量。离线图片处理没有严格响应时间要求,可以选择更大的稳定批量。
不同尺寸的图片会在组批时统一缩放和填充。若同一批图片长宽差异很大,填充区域会增加无效计算。将相近尺寸或相近宽高比的图片分组,通常能获得更稳定的吞吐量。
显存不足与测量偏差
出现 CUDA out of memory 时,先减小批量大小,再考虑降低输入尺寸或启用 FP16。不要在同一块 GPU 上同时运行其他占用大量显存的任务,否则测试结果会失真。
每个批量大小至少重复测试数次,并排除第一次预热结果。比较时保持模型、图片、输入尺寸、置信度阈值和软件环境一致,否则无法判断性能变化究竟来自批量调整还是其他参数。
最终批量大小应以业务目标为准:实时接口关注端到端延迟上限,离线任务关注单位时间处理量,多路视频则需要同时约束等待时间、显存和每路帧率。
本课总结
- 批量推理通常能提高 GPU 吞吐量,但可能增加图片等待组批的延迟。
- 合适的批量大小需要通过递增测试确定,不能只依据显存容量猜测。
- 性能测试必须预热并保持输入与参数一致,同时记录吞吐量、延迟和峰值显存。
下一课预告
下一课将继续围绕模型导出与部署优化,比较不同推理后端的兼容性、速度和部署成本。