
计算机视觉 / 系统课时
制定数据方案
制定数据方案
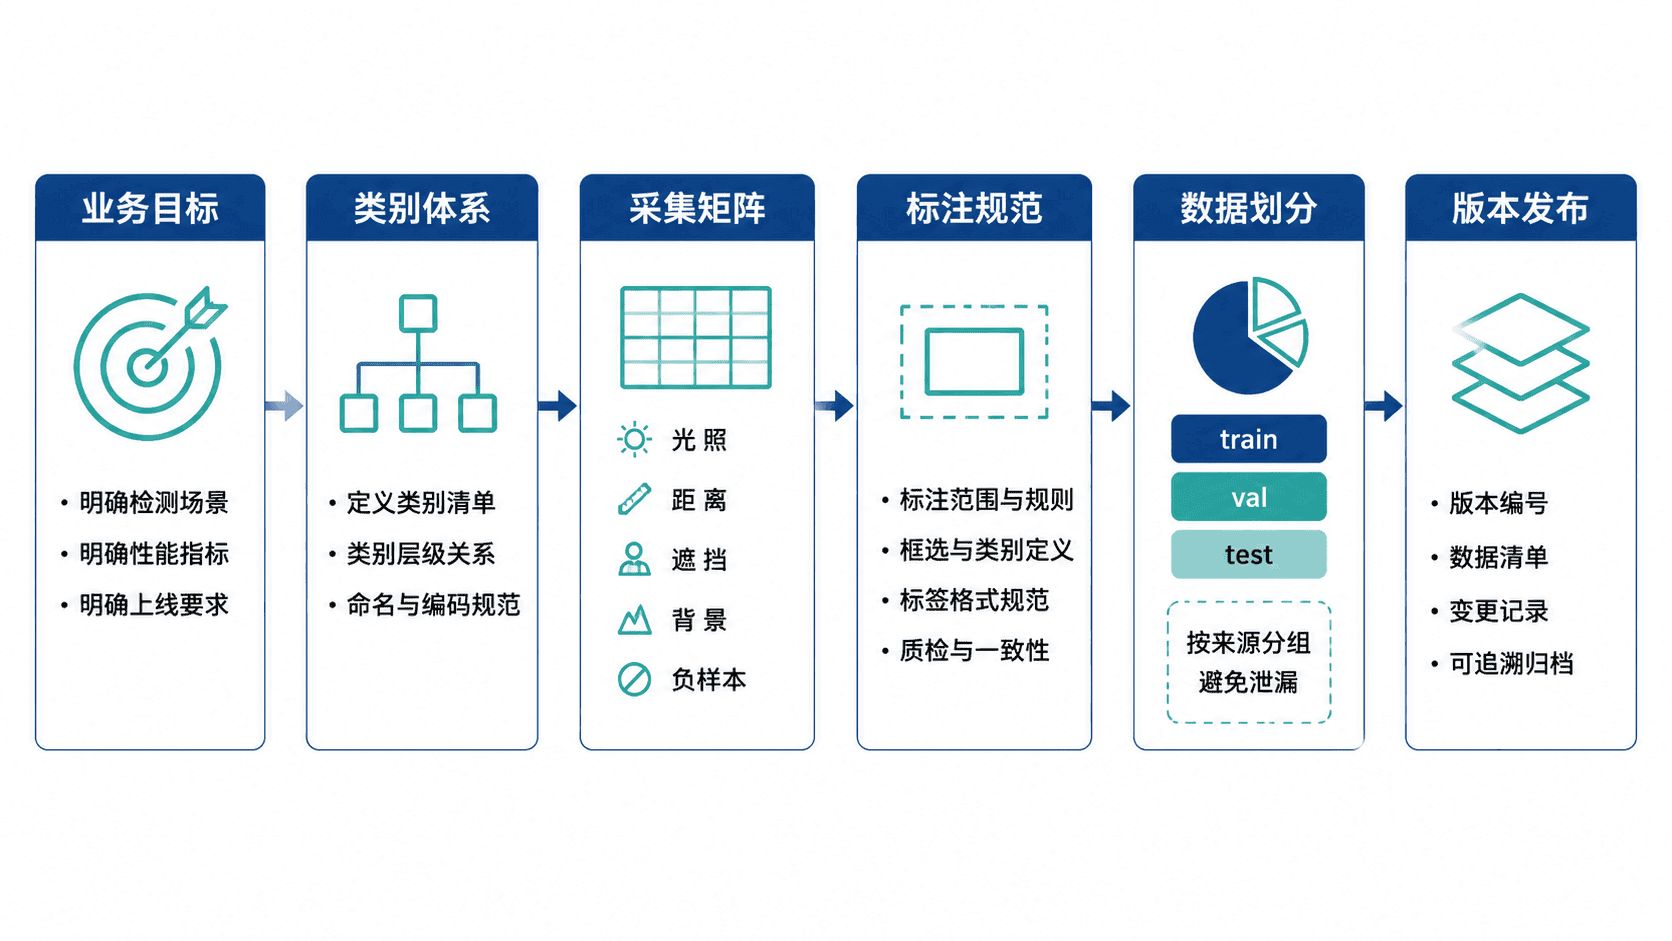
本课把“收集一些图片”转化为可执行的数据方案:先确定类别边界,再规划采集覆盖、标注规则、数据划分与版本管理,最终得到一份团队可以共同执行、能够被脚本验证的数据集规范。
学习目标
- 建立互斥、可标注、可评估的类别体系
- 设计覆盖真实场景的数据采集与数据划分方案
- 用统一规范和检查脚本控制标注质量与数据版本
从业务结果反推数据要求
数据方案的起点不是图片数量,而是模型上线后要解决的问题。本课以仓库安全检测为例,先检测 person、helmet、vest 三类目标。项目验收时不仅要看整体 mAP,还要单独检查远距离、遮挡、弱光等困难场景,避免平均指标掩盖明显短板。
先写出一页可执行的验收约束:模型识别哪些对象、忽略哪些对象、主要部署在哪些摄像头、允许多大的误检与漏检,以及测试集必须覆盖哪些风险场景。类别和场景一旦变化,应创建新数据版本,而不是直接覆盖旧数据。
建立清晰的类别体系
类别必须满足“标注员能稳定判断、模型能从图像中观察、不同类别之间尽量互斥”。不要把业务状态直接当作目标类别,例如“未规范佩戴”通常需要结合人员与装备的位置关系推导,不宜在没有明确视觉边界时直接定义为对象类别。
| 类别 | 标注对象 | 纳入条件 | 排除条件 |
|---|---|---|---|
person |
可见人体 | 身体主体可辨认 | 海报、反射、屏幕中的人物 |
helmet |
安全帽实体 | 帽体边界可辨认 | 普通帽子、仅露出极小碎片 |
vest |
反光背心实体 | 背心主体可辨认 | 普通外套、反光条局部 |
每个类别还要补充边界案例:严重遮挡是否标、画面边缘目标是否标、目标小到什么程度可以忽略、多个物体重叠时如何分别框选。规则应配套正例和反例,减少不同标注员之间的主观差异。
规划采集范围与样本比例
采集清单应覆盖模型实际运行环境,而不是只追求图片总数。可以按光照、机位、距离、遮挡、背景复杂度和目标密度建立场景矩阵,并记录每个单元格的计划数量与完成数量。
建议同时保留三类样本:常见场景用于稳定主指标,困难场景用于暴露边界,纯背景或相似物体构成的负样本用于抑制误检。连续视频抽帧时不要高频保留近乎相同的画面,否则数据量看似增加,信息量却没有同步增长。
训练集、验证集和测试集应按视频、摄像头、日期或地点分组后再划分。来自同一段视频的相邻帧不能分散到不同集合,否则验证结果会因数据泄漏而虚高。一个实用起点是按约 8:1:1 划分,再根据测试场景的重要性调整。
固化标注规范与目录约定
YOLO 标签每行包含 class_id x_center y_center width height,四个坐标均为相对图像宽高归一化后的数值。边界框应贴合可见目标,不要为了补全被遮挡部分而扩大框,也不要把多个独立目标合并成一个框。
建议固定如下目录,并让图片与标签使用相同的基础文件名:
datasets/warehouse-ppe/
├── images/
│   ├── train/
│   ├── val/
│   └── test/
├── labels/
│   ├── train/
│   ├── val/
│   └── test/
└── versions/
    └── v1.0.0.yaml
版本文件至少记录类别顺序、数据来源、划分规则、标注规范版本、生成日期和已知缺陷。类别顺序一旦进入训练配置就不能随意调整,因为标签中的 class_id 只保存数字,不保存类别名称。
用脚本检查交付数据
下面的检查脚本只依赖 Python 标准库,可验证图片是否缺少标签、标签列数是否正确、类别编号是否越界,以及归一化坐标是否合法。将脚本保存为 check_dataset.py,并从项目根目录运行。
from pathlib import Path
import sys

ROOT = Path("datasets/warehouse-ppe")
CLASSES = ["person", "helmet", "vest"]
IMAGE_SUFFIXES = {".jpg", ".jpeg", ".png", ".bmp"}

def check_split(split: str) -> tuple[int, int, list[str]]:
    image_dir = ROOT / "images" / split
    label_dir = ROOT / "labels" / split
    images = sorted(
        path for path in image_dir.rglob("*")
        if path.suffix.lower() in IMAGE_SUFFIXES
    )
    object_count = 0
    errors: list[str] = []

    for image_path in images:
        relative = image_path.relative_to(image_dir).with_suffix(".txt")
        label_path = label_dir / relative
        if not label_path.exists():
            errors.append(f"{image_path}: missing label")
            continue

        for line_no, raw in enumerate(
            label_path.read_text(encoding="utf-8").splitlines(), start=1
        ):
            parts = raw.split()
            if len(parts) != 5:
                errors.append(f"{label_path}:{line_no}: expected 5 columns")
                continue

            try:
                class_id = int(parts[0])
                x, y, width, height = map(float, parts[1:])
            except ValueError:
                errors.append(f"{label_path}:{line_no}: invalid number")
                continue

            if not 0 <= class_id < len(CLASSES):
                errors.append(f"{label_path}:{line_no}: class id out of range")
            if not (0 <= x <= 1 and 0 <= y <= 1):
                errors.append(f"{label_path}:{line_no}: center out of range")
            if not (0 < width <= 1 and 0 < height <= 1):
                errors.append(f"{label_path}:{line_no}: size out of range")
            object_count += 1

    return len(images), object_count, errors

def main() -> int:
    all_errors: list[str] = []
    for split in ("train", "val", "test"):
        image_count, object_count, errors = check_split(split)
        print(f"[CHECK] {split}: images={image_count}, objects={object_count}")
        all_errors.extend(errors)

    if all_errors:
        for error in all_errors[:20]:
            print(f"[ERROR] {error}")
        print(f"DATASET CHECK FAILED: {len(all_errors)} error(s)")
        return 1

    print("DATASET CHECK PASSED")
    return 0

if __name__ == "__main__":
    sys.exit(main())
运行命令:
python check_dataset.py预期输出如下,其中 <N> 会替换为当前数据集的实际统计值:
[CHECK] train: images=<N>, objects=<N>
[CHECK] val: images=<N>, objects=<N>
[CHECK] test: images=<N>, objects=<N>
DATASET CHECK PASSED
脚本通过只代表格式和基础范围正确,不能替代人工抽检。交付前应从每个类别、每种困难场景和每位标注员的结果中随机抽样,重点检查漏标、错类、框过松、框过紧和重复框。
本课总结
- 数据方案应从业务验收目标反推类别、场景和测试集要求
- 数据划分必须按来源分组,避免相邻帧泄漏到不同集合
- 目录、类别顺序、标注规则和检查结果都应纳入可追踪的数据版本
下一课预告
下一课将冻结本节的数据版本与类别配置,使用统一训练参数完成首个 YOLOv5 基线模型,并记录可复现的训练产物和评估结果。