
计算机视觉 / 系统课时
排查推理结果异常
排查推理结果异常
当检测框缺失、类别错乱、框位置偏移或置信度异常时,不能只反复调阈值。本课建立一条可复现的排查链路,从权重、类别、预处理、后处理到坐标还原逐层验证,最终定位真正出错的环节。
学习目标
- 能按固定顺序定位推理异常所在层级
- 能验证权重类别、输入张量和坐标还原是否一致
- 能用对照实验判断阈值调整是否合理
先判断异常属于哪一层
推理结果异常通常来自五个位置:加载了错误权重、类别映射不一致、图像预处理与训练不一致、置信度或 NMS 阈值不合适、坐标没有从缩放图正确还原到原图。先根据现象缩小范围,再做验证,效率远高于同时修改多个参数。
| 现象 | 优先检查 |
|---|---|
| 所有图片都没有框 | 权重、输入尺寸、归一化、置信度阈值 |
| 有框但类别名称错误 | names 顺序、数据集 YAML、部署端类别表 |
| 框整体偏移或尺寸不对 | Letterbox 填充、坐标缩放、原图宽高顺序 |
| 重复框很多 | IoU 阈值、NMS 是否执行、类别无关 NMS 配置 |
| 离线正常、服务异常 | BGR/RGB、张量维度、FP16、前后处理差异 |
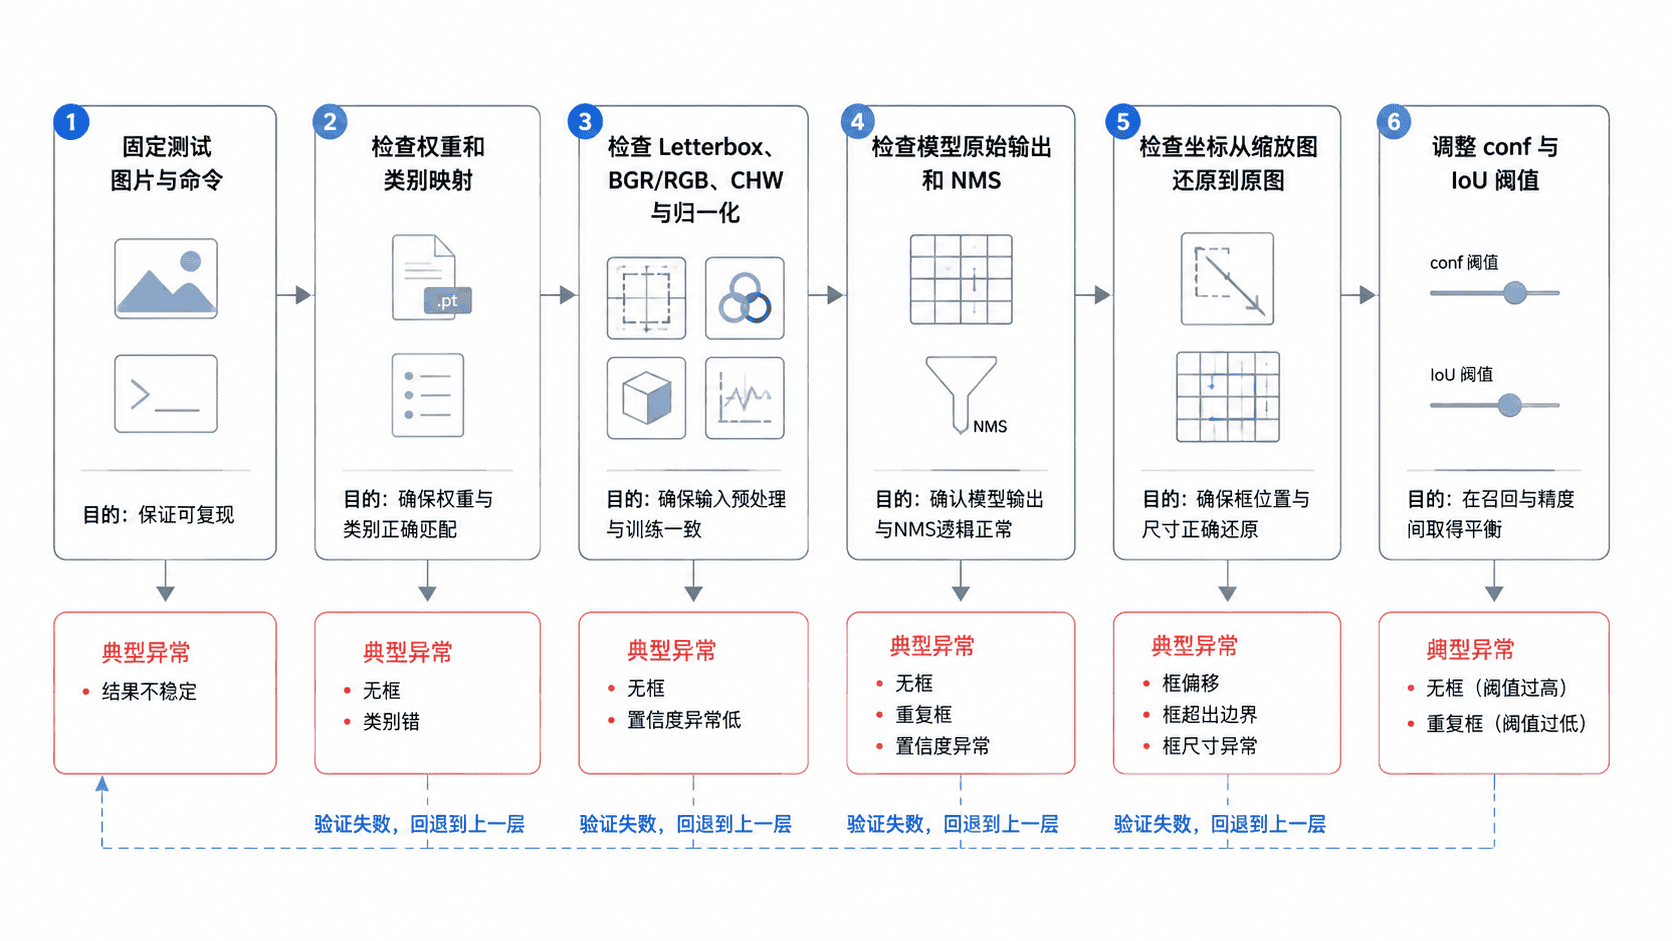
固定输入并建立基线
选择一张长期不变、人工确认过标注的测试图片,固定权重、输入尺寸和阈值。每次只改一个变量,并把检测图片与标签同时保存,避免凭肉眼比较不同批次结果。
# 固定权重、图片、尺寸和阈值,建立可重复的基线
python detect.py \
  --weights runs/train/exp/weights/best.pt \
  --source data/images/bus.jpg \
  --imgsz 640 \
  --conf-thres 0.25 \
  --iou-thres 0.45 \
  --save-txt \
  --save-conf \
  --project runs/diagnose \
  --name baseline \
  --exist-ok
预期结果
runs/diagnose/baseline/
├── bus.jpg
└── labels/
    └── bus.txt
实际日志中的推理耗时和保存路径可能不同,但目录中应同时出现可视化图片与对应标签文件。若标签文件为空,先检查权重和预处理;若标签正确而图片框错误,重点检查绘制与坐标还原。
核对权重与类别映射
权重必须来自预期训练任务,类别数量和顺序必须与推理端使用的名称表一致。不要只看文件名,应直接读取权重中的 model.names。仅对可信的本地权重执行下面的检查,因为 torch.load 会反序列化文件内容。
import torch

weights_path = "runs/train/exp/weights/best.pt"

# 新旧 PyTorch 对 weights_only 参数的支持不同,兼容两种加载方式
try:
    checkpoint = torch.load(
        weights_path, map_location="cpu", weights_only=False
    )
except TypeError:
    checkpoint = torch.load(weights_path, map_location="cpu")

model = checkpoint.get("ema") or checkpoint["model"]
names = model.names
items = sorted(names.items()) if isinstance(names, dict) else list(enumerate(names))

print(f"num_classes={len(items)}")
for class_id, class_name in items:
    print(f"{class_id}: {class_name}")
预期输出
num_classes=<N>
0: <CLASS_0>
1: <CLASS_1>
...
将输出与数据集 YAML 中的 names、服务端类别数组以及前端展示文案逐项对照。数量相同但顺序不同,也会造成“框正确、名称错误”。
检查图像预处理
YOLOv5 常见输入流程是读取 BGR 图像、执行 Letterbox、转换为 RGB、从 HWC 变为 CHW、转为连续数组,再归一化到 0~1。部署代码漏掉任一步,都可能让模型输出明显退化。
import cv2
import numpy as np
from utils.augmentations import letterbox

image = cv2.imread("data/images/bus.jpg")
if image is None:
    raise FileNotFoundError("未找到测试图片")

# 固定 auto=False,确保输出尺寸可直接与部署端对照
resized, ratio, pad = letterbox(image, new_shape=640, auto=False)

# BGR 转 RGB、HWC 转 CHW,并归一化到 0~1
tensor = resized[:, :, ::-1].transpose(2, 0, 1)
tensor = np.ascontiguousarray(tensor, dtype=np.float32) / 255.0

print(f"shape={tensor.shape}")
print(f"range=({tensor.min():.3f}, {tensor.max():.3f})")
print(f"ratio={ratio}, pad={pad}")
预期输出
shape=(3, 640, 640)
range=(<MIN_0_TO_1>, <MAX_0_TO_1>)
ratio=(<RATIO_X>, <RATIO_Y>), pad=(<PAD_X>, <PAD_Y>)
如果形状不是 CHW、数值仍在 0~255、颜色通道未转换,先修复预处理。训练与推理的 Letterbox 参数也应一致,尤其要关注 auto、目标尺寸和步长约束。
验证后处理与坐标还原
模型输出的框坐标基于 Letterbox 后的图像,绘制到原图前必须去掉填充并按缩放比例还原。推荐复用 YOLOv5 自带的 non_max_suppression 和 scale_boxes,不要在多个服务中各写一套近似实现。
排查时同时记录三组数据:NMS 前候选框数量、NMS 后框数量、还原后的最终坐标。若 NMS 前已有正确候选而最终框消失,问题在阈值或 NMS;若数值正确但绘制偏移,问题在坐标还原或宽高顺序。
最后再调整阈值
conf-thres 过高会漏检,过低会引入大量低质量框;iou-thres 过低容易过度抑制相邻目标,过高则可能保留重复框。先确认权重、类别、预处理和坐标链路正确,再用同一验证集做单变量对照。
建议依次测试 conf-thres 为 0.15、0.25、0.40,并保留同一 iou-thres。比较的不只是“看起来更好”,还应记录漏检数、误检数和重复框数量,选择符合业务成本的阈值。
本课总结
- 推理异常应按权重、类别、预处理、后处理和坐标还原的顺序逐层定位
- 固定测试输入并一次只改一个变量,才能形成可靠的对照结论
- 阈值只负责取舍已有预测,不能修复错误的类别映射或图像处理链路
下一课预告
下一课将为数据集、训练配置、代码提交和模型权重建立统一版本关系,使每个线上模型都能追溯、复现并安全回滚。