
计算机视觉 / 系统课时
分析混淆矩阵
分析混淆矩阵
混淆矩阵把“真实类别”和“预测类别”放进同一张表中,能快速指出哪些类别互相误判、哪些目标被当成背景,以及哪些背景被错误识别为目标。本课将建立固定的阅读顺序,并把矩阵中的数字转成可执行的改进任务。
学习目标
- 正确识别混淆矩阵的行、列和背景区域
- 区分类别互判、背景误检与目标漏检
- 根据误差模式选择数据或模型改进方向
先确认坐标含义
不同工具可能交换横纵轴,因此分析前必须先阅读图上的轴标题。YOLOv5 常见实现中,行表示预测类别,列表示真实类别;最后一行和最后一列用于背景。
| 区域 | 含义 | 直接结论 |
|---|---|---|
| 对角线 | 预测类别等于真实类别 | 数值越集中越好 |
| 非对角线 | 两个前景类别之间误判 | 类别特征或标注边界不清 |
| 最后一行 | 真实目标被预测为背景 | 漏检 |
| 最后一列 | 背景被预测为某个类别 | 误检 |
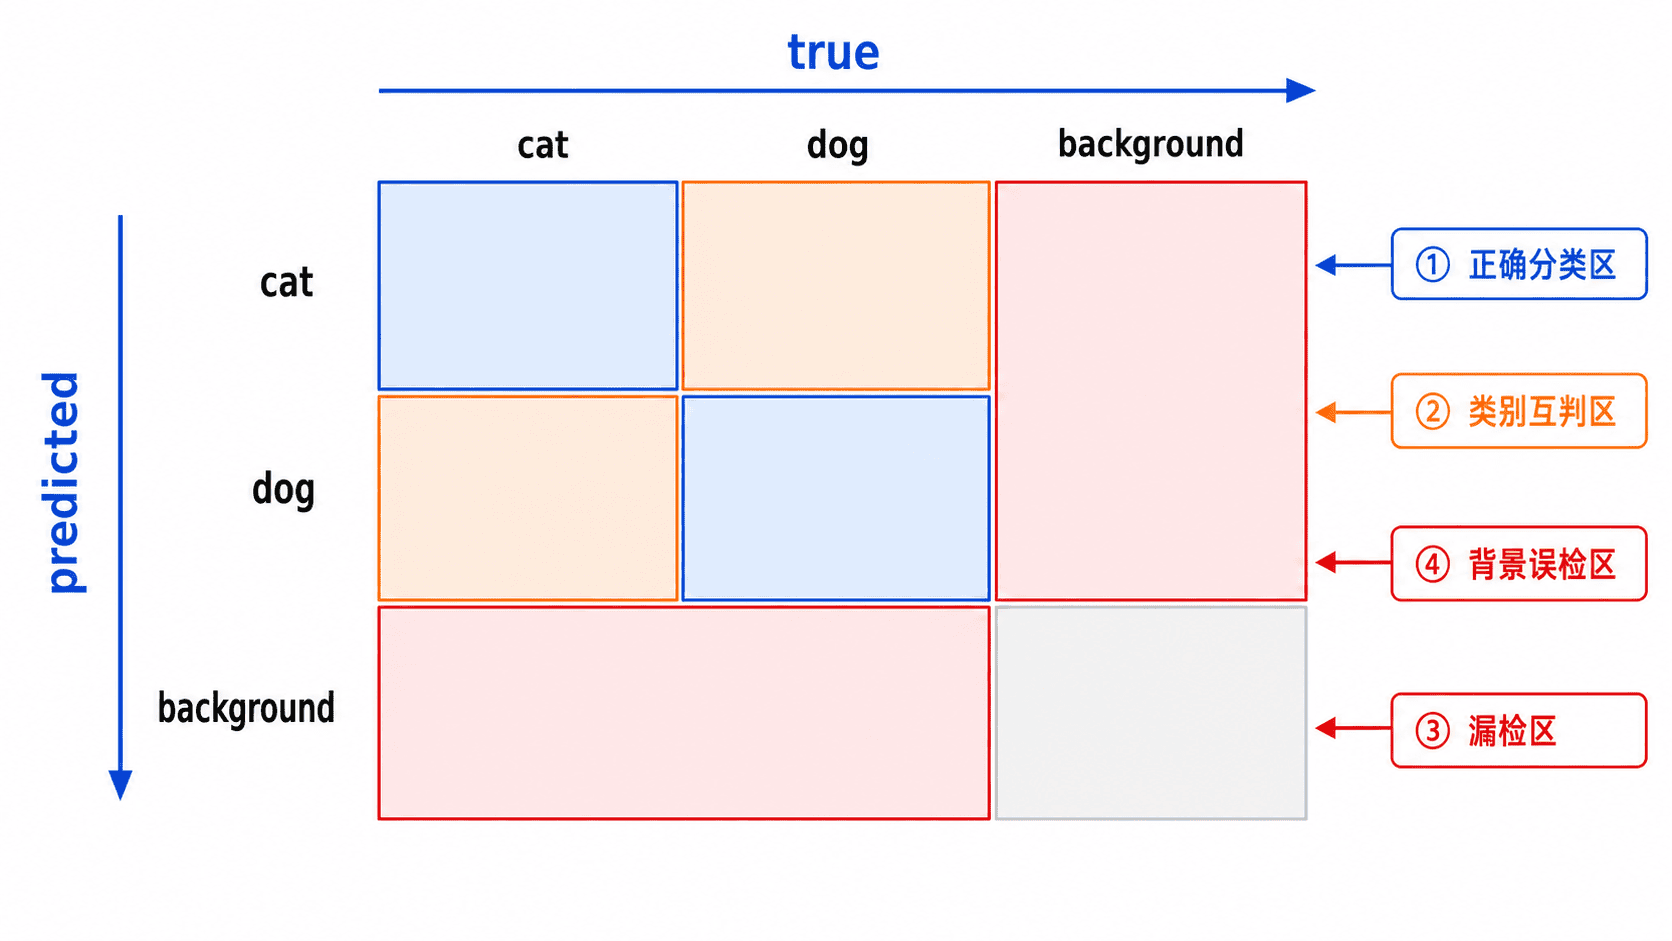
按四步读取矩阵
第一步看对角线占比,判断各类别是否能被稳定识别。第二步找最大的非对角线单元格,定位最严重的类别互判。第三步检查最后一行,找出漏检最多的真实类别。第四步检查最后一列,确认模型最容易把哪些背景纹理当成目标。
不要只比较绝对数量。样本多的类别天然会产生更大的数字,应同时计算每个真实类别的召回率,或查看归一化混淆矩阵。某类召回率低,说明该列中流向其他行或背景行的比例过高。
用代码提取主要误差
下面的完整示例按“行是预测、列是真实”的约定分析一个三分类矩阵,并分别输出类别互判、背景误检和目标漏检。
labels = ["cat", "dog", "background"]
matrix = [
    [82, 6, 9],
    [4, 71, 11],
    [14, 23, 0],
]
foreground_count = len(labels) - 1
errors = []
for pred in range(foreground_count):
    for true in range(foreground_count):
        if pred != true and matrix[pred][true] > 0:
            errors.append((matrix[pred][true], labels[true], labels[pred]))
errors.sort(reverse=True)
for count, true_name, pred_name in errors:
    print(f"{true_name} -> {pred_name}: {count}")
for index in range(foreground_count):
    false_positive = matrix[index][-1]
    false_negative = matrix[-1][index]
    true_total = sum(matrix[row][index] for row in range(len(matrix)))
    recall = matrix[index][index] / true_total if true_total else 0
    print(f"{labels[index]}: recall={recall:.1%}, FP={false_positive}, FN={false_negative}")
预期输出
dog -> cat: 6
cat -> dog: 4
cat: recall=82.0%, FP=9, FN=14
dog: recall=71.0%, FP=11, FN=23
结果表明 dog 的主要问题不是被误判成 cat,而是有 23 个实例直接落入背景行,因此应优先分析漏检样本,而不是只增加区分类别的特征。
把误差转成改进任务
类别互判集中时,先检查类别定义是否重叠,再补充容易混淆的成对样本,例如相似姿态、相似颜色和相近视角。若定义本身模糊,应先统一标注规范,否则继续训练只会放大噪声。
背景误检集中时,收集产生误检的真实背景作为负样本,并检查置信度阈值是否过低。若误检总发生在固定纹理、反光或局部物体上,应让训练集覆盖这些“困难背景”。
目标漏检集中时,应回到原图检查尺寸、遮挡、模糊、光照和标注质量。若某类样本很少,还要检查类别不平衡;若小目标占主导,则需要调整输入尺寸、数据增强和检测层适配。
常见误读
不要把最后一行和最后一列混为一谈:前者表示真实目标没有被任何类别接住,后者表示没有真实目标却产生了预测。也不要只看颜色深浅,归一化图与原始计数图的含义不同,必须先确认色条和轴标签。
本课总结
- 先确认行列定义,再读取对角线、非对角线和背景区域
- 类别互判、背景误检和目标漏检对应不同的修复方向
- 绝对计数必须结合类别样本量和召回率一起判断
下一课预告
下一课将从验证结果中筛出具体漏检图片,并按目标尺度、遮挡、模糊、光照和标注质量建立可复用的原因分类。