
计算机视觉 / 系统课时
迭代数据与训练策略
迭代数据与训练策略
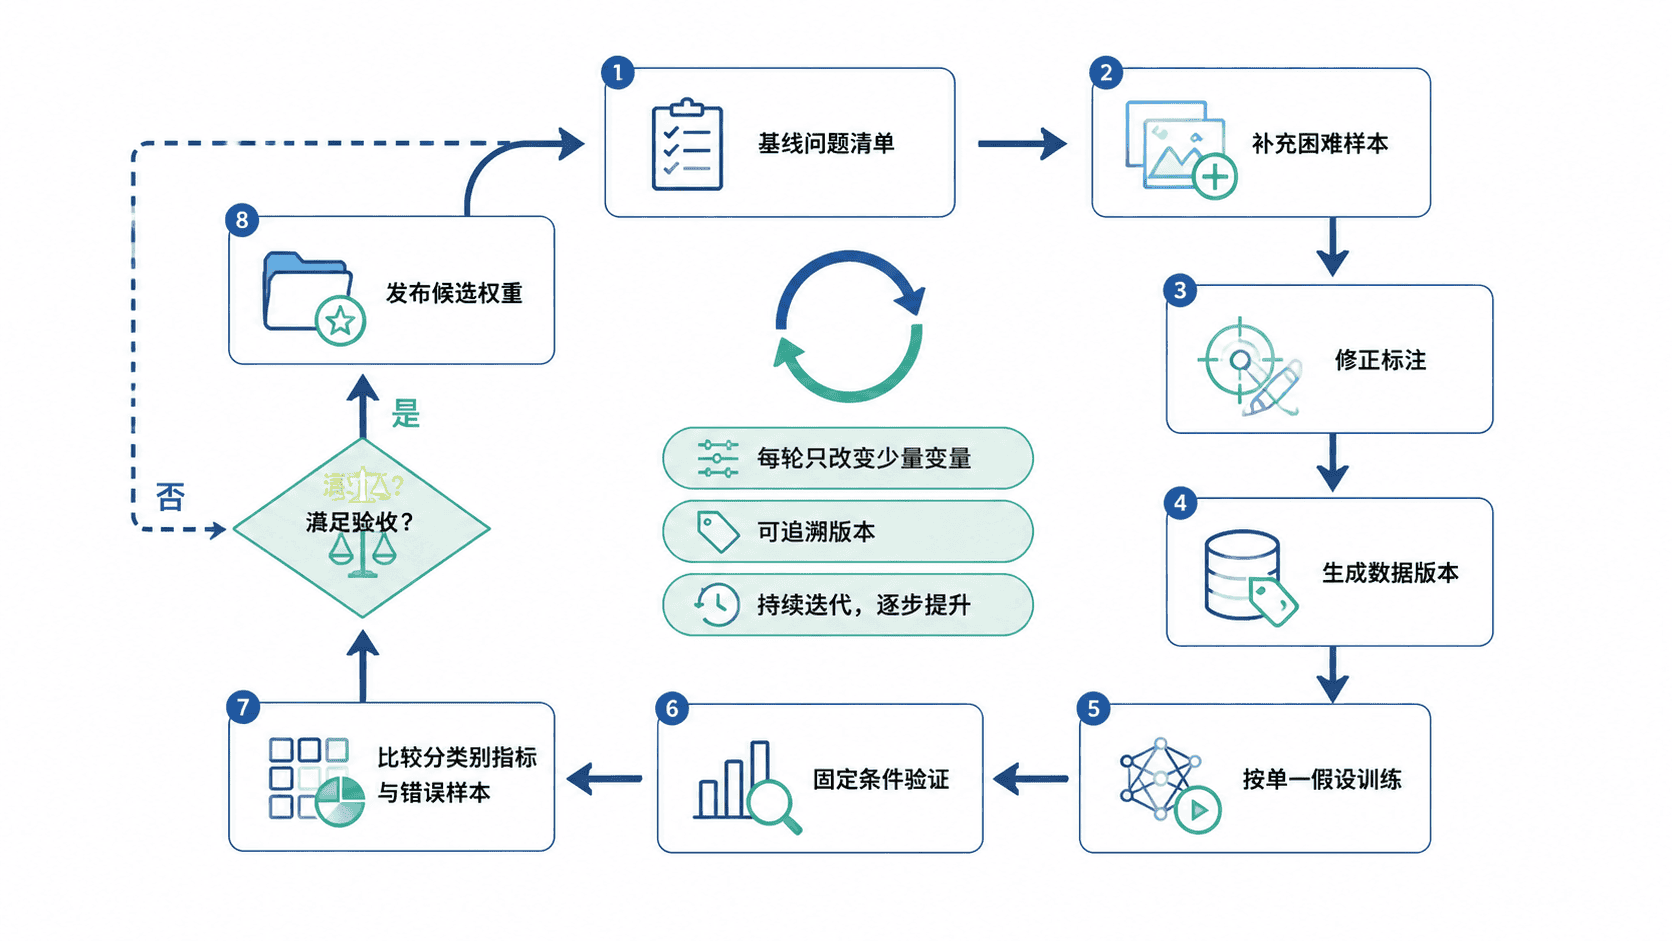
发现基线问题后,不能同时修改所有变量再重新训练。本课将把问题拆成可验证实验,优先修复数据与标注,再按证据调整输入尺寸、训练轮次和早停策略,形成可回滚的迭代闭环。
学习目标
- 将基线问题转成单变量或少变量实验
- 按优先级补充数据、修正标注并调整训练参数
- 使用统一验收标准决定保留或回滚模型
把问题转成实验
每轮迭代先写清一个主要假设,例如“夜间漏检来自夜间样本不足”或“小目标召回率低来自输入分辨率不足”。实验记录至少包含数据版本、初始权重、训练命令、目标指标和回滚条件。
不要在同一轮同时更换数据、模型规模、增强策略和输入尺寸。变量过多时,即使指标提升,也无法判断真正有效的改动,下一轮很难复用经验。
优先修复数据与标注
先处理会直接污染监督信号的问题:漏标、错类、重复图片、框越界、训练集与验证集泄漏。随后再针对错误样本补充数据,尤其是困难光照、遮挡、小目标、相似背景和易混类别。
新增样本不应只追求数量。每批数据都要说明它解决哪类错误,并保持验证集相对稳定;若验证集也必须更新,应建立新的固定版本,不能把新旧结果直接混在一起比较。
按证据调整训练策略
数据修复后再调整训练参数。小目标持续漏检时,可在显存允许的范围内提高 --img;训练和验证指标仍同步上升时,可增加轮次;验证指标长期不再改善时,应使用早停,而不是机械延长训练。
下面以基线最佳权重为起点进行一次受控迭代。命令保持模型规模不变,只更新数据版本并设置明确的训练轮次和早停窗口:
python train.py --weights runs/train/baseline/weights/best.pt --data data/project-v2.yaml --img 640 --batch-size 16 --epochs 80 --hyp data/hyps/hyp.scratch-low.yaml --patience 20 --project runs/train --name iter-01预期输出:
Results saved to runs/train/iter-01训练目录中应生成 weights/best.pt、weights/last.pt、results.csv 和训练曲线。实际耗时、最佳轮次及指标值会随硬件和数据变化。
batch-size 应以显存稳定为准,不必盲目追求更大。若提高输入尺寸导致显存不足,应先降低批量大小,并保持其他变量不变,再判断小目标召回率是否改善。
用同一标准验收
新模型必须使用与基线完全一致的验证命令。验收时至少比较总体 mAP、目标类别的精确率与召回率、主要错误类型数量,以及推理速度和显存占用。
一个可接受的迭代不仅要让目标指标提升,还要避免关键类别明显回退。若总体 mAP 上升但核心业务类别召回率下降,应视为未通过,继续检查类别权重、样本分布或阈值设置。
保留版本与回滚点
为每轮训练保存数据清单、标签快照、命令、代码提交号和结果目录。模型文件名应能关联到实验编号,但不要只依赖文件名记录条件。
通过验收的权重标记为候选版本,未通过的实验保留结论后回滚到上一基线。这样即使连续多轮尝试失败,也不会丢失当前可用模型。
本课总结
- 数据和标注问题应优先于参数调优处理
- 每轮只改变少量变量,才能判断改动是否有效
- 新模型必须在统一条件下验收,并保留完整回滚点
下一课预告
下一课将把通过验收的候选权重接入完整检测流程,检查输入、输出、性能和业务规则是否满足项目交付要求。