
计算机视觉 / 系统课时
多尺度特征融合
多尺度特征融合
本课解决“单一尺度为什么难以同时检测大小目标”这一问题。你将理解 YOLOv5 Neck 如何利用自顶向下与自底向上的路径融合多层特征,并通过张量上采样、拼接和卷积验证融合前后的尺寸关系。
学习目标
- 理解多尺度检测对小、中、大目标的必要性
- 看懂 FPN 与 PAN 路径中的上采样、拼接和下采样
- 能检查特征融合时通道数和空间尺寸是否匹配
为什么需要多尺度特征
主干网络输出的高分辨率特征保留了更多位置细节,但语义相对较弱;低分辨率特征语义更强,却可能丢失小目标的轮廓。如果只使用最深层特征,小目标可能在多次下采样后只剩极少像素;如果只使用浅层特征,模型又难以判断局部纹理属于什么对象。
YOLOv5 因此使用多个尺度共同预测。以 640×640 输入为例,常见的三层检测特征为 80×80、40×40 和 20×20,它们分别更有利于小、中、大目标,但每一层都需要同时具备定位细节和类别语义。
FPN 与 PAN 如何协作
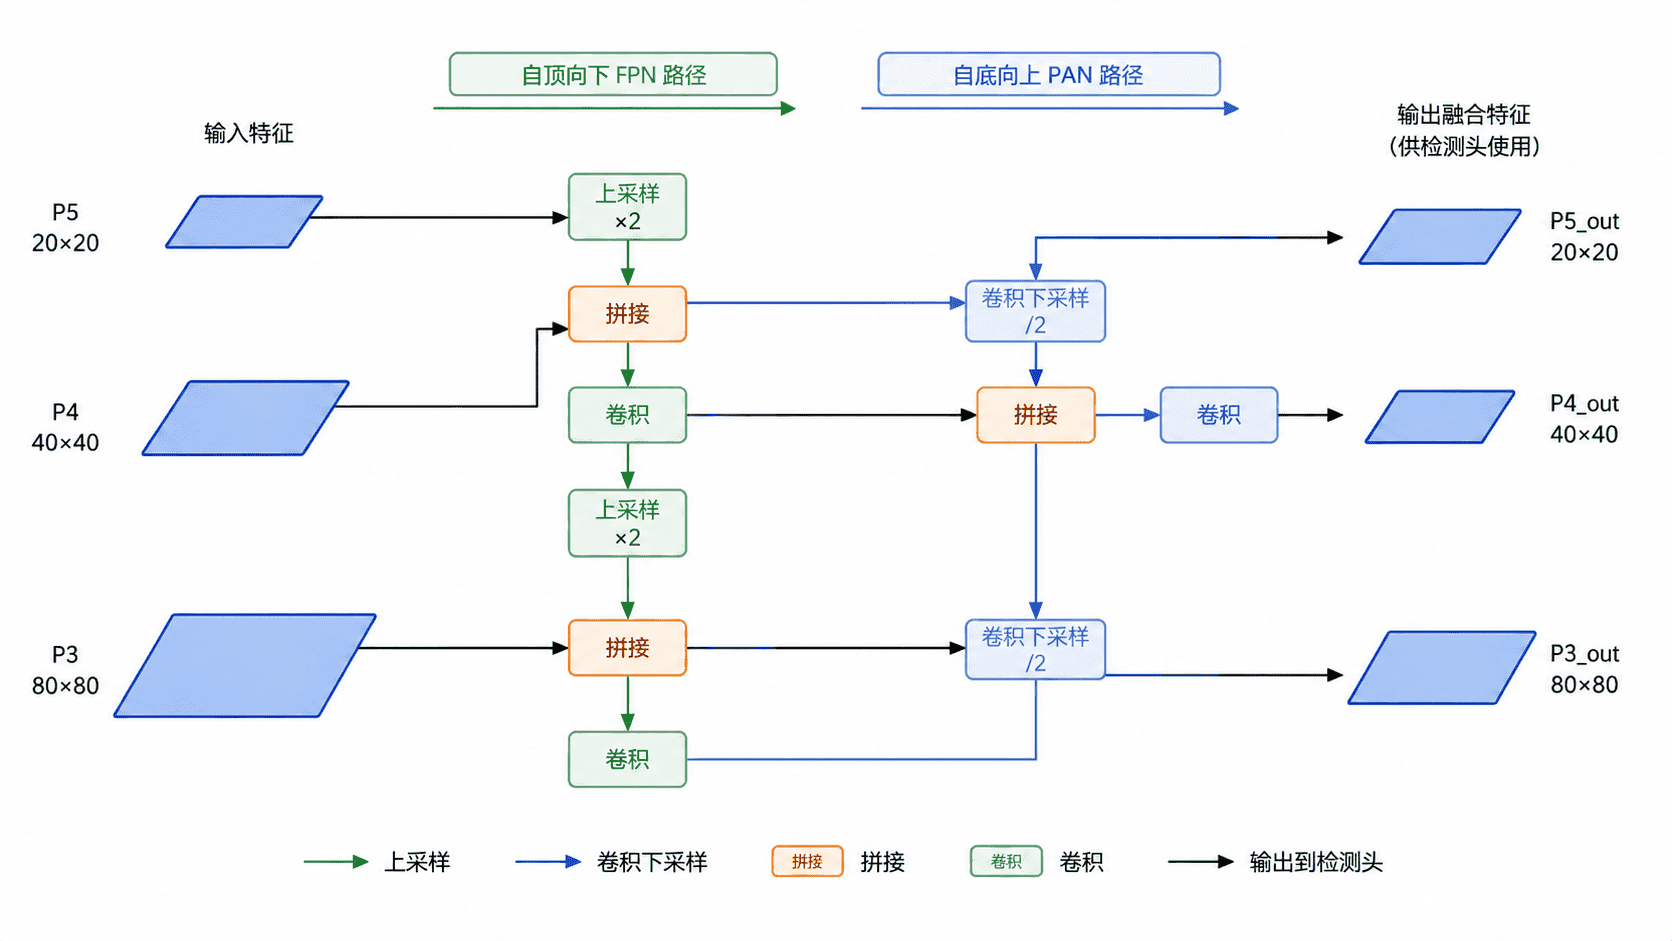
FPN 路径先把深层特征上采样,再与更浅一层的特征拼接。这样,高分辨率特征可以获得深层语义,帮助模型在细小区域中判断目标类别。
PAN 路径随后把融合后的高分辨率特征再次向下传递,通过步长为 2 的卷积与中、低分辨率特征融合。它补充了从浅层到深层的定位信息流,使不同尺度之间形成双向连接。
融合时必须满足的尺寸条件
拼接通常沿通道维进行,因此参与拼接的张量必须具有相同的高和宽。例如 20×20 特征上采样 2 倍后变为 40×40,才能与来自 Backbone 的 40×40 特征拼接。拼接后通道数相加,再由卷积或 C3 模块压缩和重组。
若两个张量分别为 [1, 256, 40, 40] 和 [1, 256, 40, 40],沿通道维拼接后会得到 [1, 512, 40, 40]。若空间尺寸不一致,程序会直接报错,这也是修改模型结构时最常见的问题之一。
用代码验证一次融合
下面的示例构造三层特征,并完成一次从 20×20 到 40×40、再到 80×80 的自顶向下融合。它省略了 YOLOv5 中更复杂的 C3 计算,只保留上采样、拼接和通道压缩三个关键动作。
import torch
from torch import nn
from torch.nn import functional as F

class TopDownFusion(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        # 先压缩深层通道,避免拼接后的计算量过大。
        self.reduce_p5 = nn.Conv2d(512, 256, kernel_size=1)
        self.fuse_p4 = nn.Conv2d(512, 256, kernel_size=3, padding=1)
        self.reduce_p4 = nn.Conv2d(256, 128, kernel_size=1)
        self.fuse_p3 = nn.Conv2d(256, 128, kernel_size=3, padding=1)

    def forward(
        self,
        p3: torch.Tensor,
        p4: torch.Tensor,
        p5: torch.Tensor,
    ) -> tuple[torch.Tensor, torch.Tensor]:
        p5_reduced = self.reduce_p5(p5)
        p5_up = F.interpolate(p5_reduced, scale_factor=2, mode="nearest")
        n4 = self.fuse_p4(torch.cat([p5_up, p4], dim=1))

        n4_reduced = self.reduce_p4(n4)
        n4_up = F.interpolate(n4_reduced, scale_factor=2, mode="nearest")
        n3 = self.fuse_p3(torch.cat([n4_up, p3], dim=1))
        return n3, n4

def main() -> None:
    p3 = torch.randn(1, 128, 80, 80)
    p4 = torch.randn(1, 256, 40, 40)
    p5 = torch.randn(1, 512, 20, 20)

    n3, n4 = TopDownFusion()(p3, p4, p5)
    print("n3:", tuple(n3.shape))
    print("n4:", tuple(n4.shape))

if __name__ == "__main__":
    main()
预期输出:
n3: (1, 128, 80, 80)
n4: (1, 256, 40, 40)
输出说明上采样后的空间尺寸已与横向连接匹配,而卷积层把拼接后的通道数重新压缩。完整 YOLOv5 Neck 还会继续执行自底向上的 PAN 融合,并输出三个尺度给检测头。
常见理解与实现错误
最常见的错误是只看通道数,不检查高和宽。torch.cat(..., dim=1) 只能在通道维不同,其他维度必须相等。另一个错误是把上采样当成“创造新细节”;上采样只是扩大特征图,真正有价值的细节来自与 Backbone 对应层的横向连接。
融合层也不是越多越好。额外路径会增加显存、延迟和优化难度。实际选择需要结合目标尺寸分布、输入分辨率和部署算力,而不是单纯追求更复杂的 Neck。
本课总结
- 多尺度融合让高分辨率细节与低分辨率语义相互补充
- FPN 负责自顶向下传递语义,PAN 负责自底向上传递定位信息
- 拼接前必须统一空间尺寸,拼接后通常再压缩和重组通道
下一课预告
下一课将继续连接检测头,说明三个尺度的融合特征如何被转换为边界框、目标置信度和类别概率。