
计算机视觉 / 系统课时
使用数据增强
使用数据增强
数据增强通过在不修改标签语义的前提下制造更多训练变化,帮助 YOLOv5 适应视角、尺度、光照和背景差异。本课将完成一套可直接训练的增强配置,并说明何时应降低 Mosaic、MixUp 等强增强的比例。
学习目标
- 区分几何增强、色彩增强与样本混合增强
- 能在超参数文件中配置翻转、缩放、Mosaic 和 MixUp
- 能根据验证集表现判断增强是否过强
增强解决什么问题
训练集通常只能覆盖有限的拍摄条件。模型若反复看到近似角度、亮度和背景,容易记住训练图像,而不是学习目标稳定特征。数据增强的作用是扩大输入分布,同时保持边界框与类别标签同步变化。
几何增强主要改变目标的位置和尺度,例如水平翻转、平移与缩放;色彩增强改变色相、饱和度和亮度;Mosaic 将四张图拼成一张,MixUp 则按比例叠加两张图。前两类模拟真实采集变化,后两类会明显改变画面结构,强度需要更谨慎。
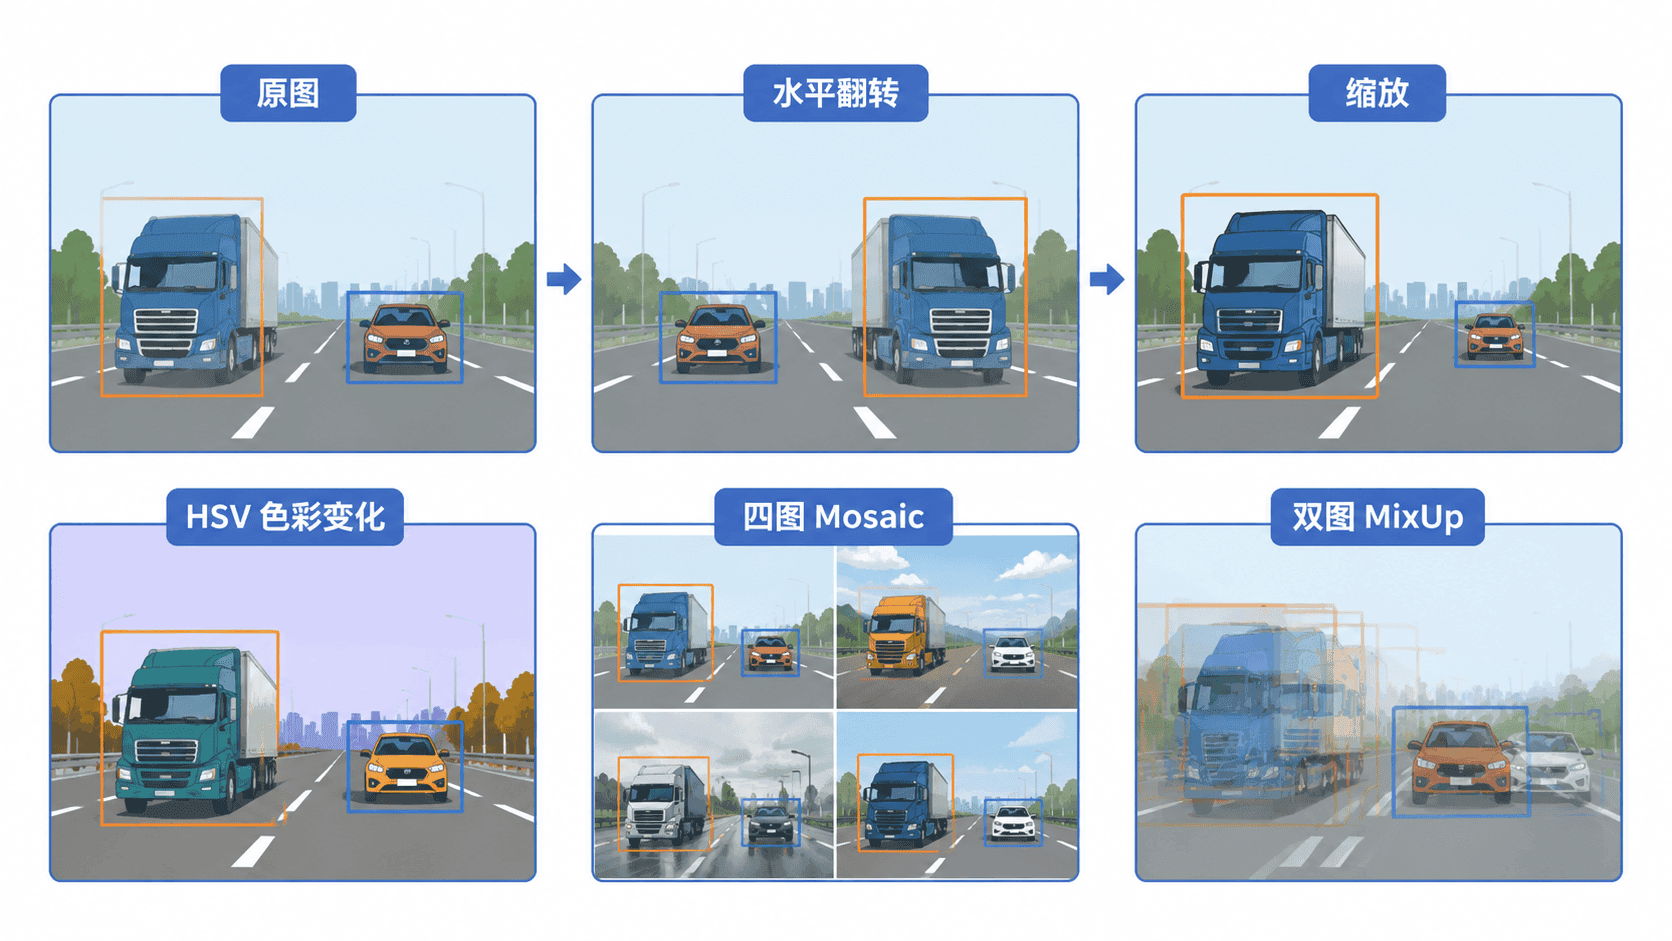
配置一组稳健的增强参数
复制 YOLOv5 自带的超参数文件,再修改与增强相关的字段。下面是一组适合多数自然图像检测任务的起始配置;它不是固定答案,后续仍应通过验证集比较。
# data/hyps/hyp.custom.yaml:仅展示需要重点调整的增强字段
hsv_h: 0.015
hsv_s: 0.7
hsv_v: 0.4
degrees: 0.0
translate: 0.1
scale: 0.5
shear: 0.0
perspective: 0.0
flipud: 0.0
fliplr: 0.5
mosaic: 1.0
mixup: 0.1
预期结果:训练读取该文件后,约一半样本可能发生水平翻转,Mosaic 默认高概率启用,MixUp 只在少量批次中出现。若目标上下方向具有明确语义,应保持 flipud: 0.0。
启动训练并核对增强是否生效
将配置文件传给训练脚本,并为实验使用独立名称,便于与未增强或弱增强实验对比。
python train.py --img 640 --batch 16 --epochs 100 --data data/custom.yaml --weights yolov5s.pt --hyp data/hyps/hyp.custom.yaml --name aug_exp预期输出如下。不同 YOLOv5 版本的日志格式可能不同,但应能看到超参数文件被加载,并在实验目录中生成训练批次可视化图片。
hyperparameters: ... mosaic=1.0, mixup=0.1, fliplr=0.5 ...
Results saved to runs/train/aug_exp
打开 runs/train/aug_exp/train_batch*.jpg,重点检查边界框是否仍贴合目标、拼接边缘是否合理、MixUp 后目标是否仍可辨认。若框与目标错位,先排查标签和自定义数据加载逻辑,不要继续训练。
判断增强是否过强
增强不是越多越好。小目标在大比例缩放后可能几乎消失,文字、仪表读数或方向标志经过翻转后可能改变语义,MixUp 也可能制造现实中不会出现的重叠关系。
应同时观察训练损失和验证指标。若训练集损失下降缓慢、验证集召回率持续偏低,先降低 scale、mosaic 或 mixup;若训练指标很好但验证集明显落后,可以适度保留增强并补充真实场景数据。判断依据始终是独立验证集,而不是增强后的训练图看起来是否“丰富”。
调优顺序
先从水平翻转、轻度缩放和 HSV 变化开始,它们通常更接近真实采集差异。确认模型稳定后,再增加 Mosaic,最后少量尝试 MixUp。每次只改一到两个变量,并保留实验名称、配置文件和指标结果,才能知道性能变化来自哪项增强。
训练后期若需要让模型重新适应自然图像,可在最后若干轮降低或关闭强增强。不同 YOLOv5 版本支持的关闭方式不同;无法直接关闭时,可以使用弱增强配置继续微调,并保持较小学习率。
本课总结
- 几何、色彩和样本混合增强解决的问题不同,应按真实场景选择
- 强增强必须通过训练批次可视化和独立验证集共同检查
- 调优时一次只改变少量参数,并优先保留真实数据补充方案
下一课预告
下一课将处理类别不平衡问题,使用类别统计、样本补充和重新采样改善少数类别的召回率。