
计算机视觉 / 系统课时
目标检测项目流程
目标检测项目流程
一个可交付的目标检测项目,不是“训练出权重文件”就结束,而是从业务验收标准出发,完成数据、训练、评估、部署与反馈闭环。本课将给出一条可直接用于规划 YOLOv5 项目的最小完整链路。
学习目标
- 能把业务需求转换为类别、场景、精度和性能指标
- 能说明数据准备、训练评估、推理部署之间的依赖关系
- 能建立上线验收与持续迭代的闭环
用闭环理解完整链路
目标检测项目通常按“需求定义 → 数据准备 → 训练 → 评估 → 部署 → 线上反馈”推进。它不是单向流水线:评估失败会回到数据或训练阶段,线上误检与漏检也会沉淀为下一版数据。
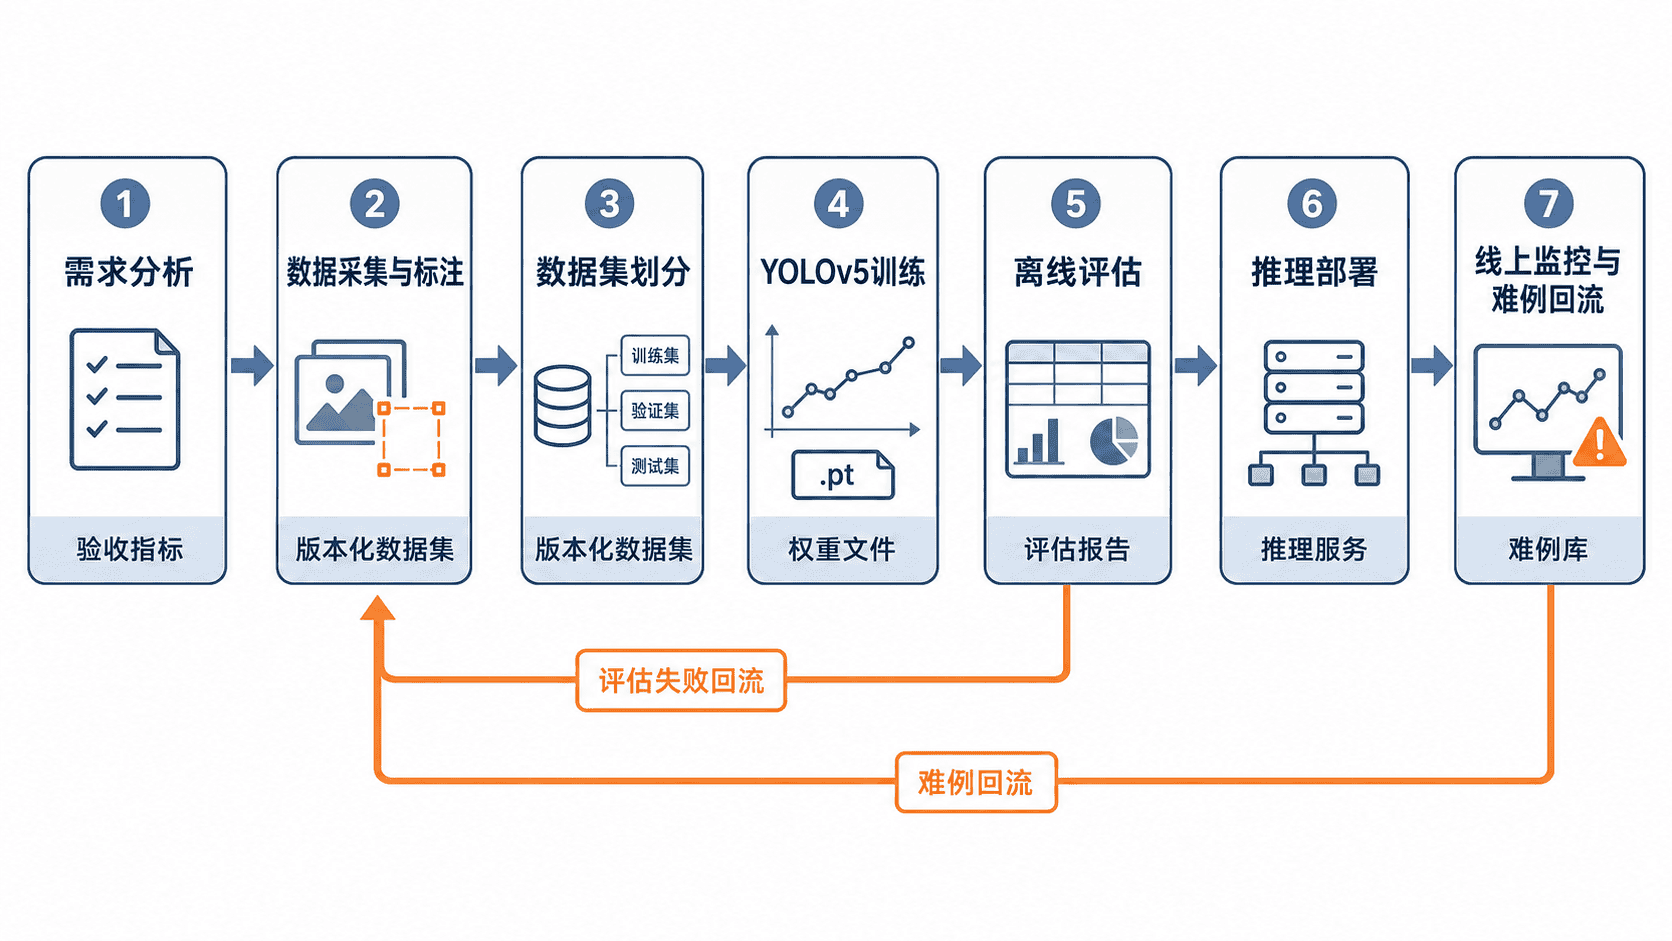
每个阶段都应留下可追踪产物,例如需求清单、数据版本、实验参数、权重、评估报告和部署版本。这样出现问题时,才能判断是需求变化、数据偏差、模型退化还是运行环境异常。
从上线结果倒推需求
先定义“检测什么、在哪里检测、达到什么标准”。类别名称必须互斥且可标注;场景要覆盖摄像头角度、距离、光照、遮挡和目标大小;指标既要包含精度,也要包含延迟、吞吐量和资源上限。
例如安全帽检测不能只写“识别人和安全帽”,还应明确是否检测未佩戴状态、多人遮挡是否计入、最小目标尺寸是多少,以及边缘设备上的单张推理延迟上限。需求越可测量,后续验收越客观。
把数据准备成可训练资产
数据准备包括采集、清洗、标注、质检和划分。训练集用于学习,验证集用于调参,测试集只用于最终验收;同一视频连续帧、同一拍摄点或同一对象的近似图片,不应被随机拆到不同集合,否则会造成数据泄漏。
数据集必须版本化。每次新增类别、修正标注或回流难例,都应产生新版本,并记录图片数量、类别分布、来源和变更原因。训练记录必须绑定数据版本,避免“同一参数却复现不了结果”。
训练评估与门槛验收
训练阶段先用小规模数据验证目录、标签和类别配置,再启动完整训练。评估不能只看单个 mAP 数值,还要同时检查每类精确率、召回率、混淆情况,以及不同光照、距离和遮挡条件下的失败样本。
下面用一个最小脚本演示如何根据项目门槛判断一次实验是否可进入部署阶段:
def is_accepted(metrics: dict[str, float], thresholds: dict[str, float]) -> bool:
    # 所有核心指标都达到门槛,实验才允许进入部署验证
    return all(metrics[name] >= limit for name, limit in thresholds.items())

metrics = {"map50": 0.92, "recall": 0.87, "precision": 0.90}
thresholds = {"map50": 0.90, "recall": 0.85, "precision": 0.88}

print("验收通过" if is_accepted(metrics, thresholds) else "需要继续迭代")
预期输出:
验收通过真实项目还应把延迟、模型大小和设备资源加入门槛,并保存对应测试环境。只有在同一设备、同一输入尺寸和同一推理配置下,性能数据才具备可比性。
推理部署与持续迭代
部署前需要固定权重版本、输入尺寸、置信度阈值、NMS 参数和类别映射,并在目标设备上执行端到端测试。验收应覆盖正常输入、空画面、损坏文件、极端光照和高并发,确认输出格式、异常处理和资源占用符合要求。
上线后持续记录误检、漏检、低置信度样本、延迟和设备状态。难例经过脱敏、复核和重新标注后进入下一版数据集,再按相同评估集比较新旧模型。若新模型只提升总体指标却损害关键类别,应拒绝发布。
本课总结
- 目标检测项目必须从可测量的业务验收标准出发,而不是从训练命令出发
- 数据版本、实验参数、模型权重和部署配置需要形成可追踪链路
- 离线评估与线上难例回流共同构成持续迭代闭环
下一课预告
下一课将进入开发环境准备,学习如何根据 CPU、NVIDIA GPU 和云端资源选择合适的 YOLOv5 训练与推理环境。