
计算机视觉 / 系统课时
调整学习率
调整学习率
学习率决定每次参数更新迈多大一步。本课将从损失曲线识别学习率过高或过低的信号,修改 YOLOv5 的 lr0 与 lrf,并用控制变量实验选出稳定收敛的配置。
学习目标
- 根据损失变化判断学习率是否合适
- 修改初始学习率和训练后期的衰减比例
- 在批量大小变化后合理缩放并验证学习率
从损失曲线判断学习率
学习率过高时,训练损失常出现大幅震荡、突然升高或直接变为异常值;学习率过低时,曲线下降缓慢,多个 epoch 后仍接近初始水平。合适的学习率通常能让训练损失整体下降,同时验证指标稳步改善。
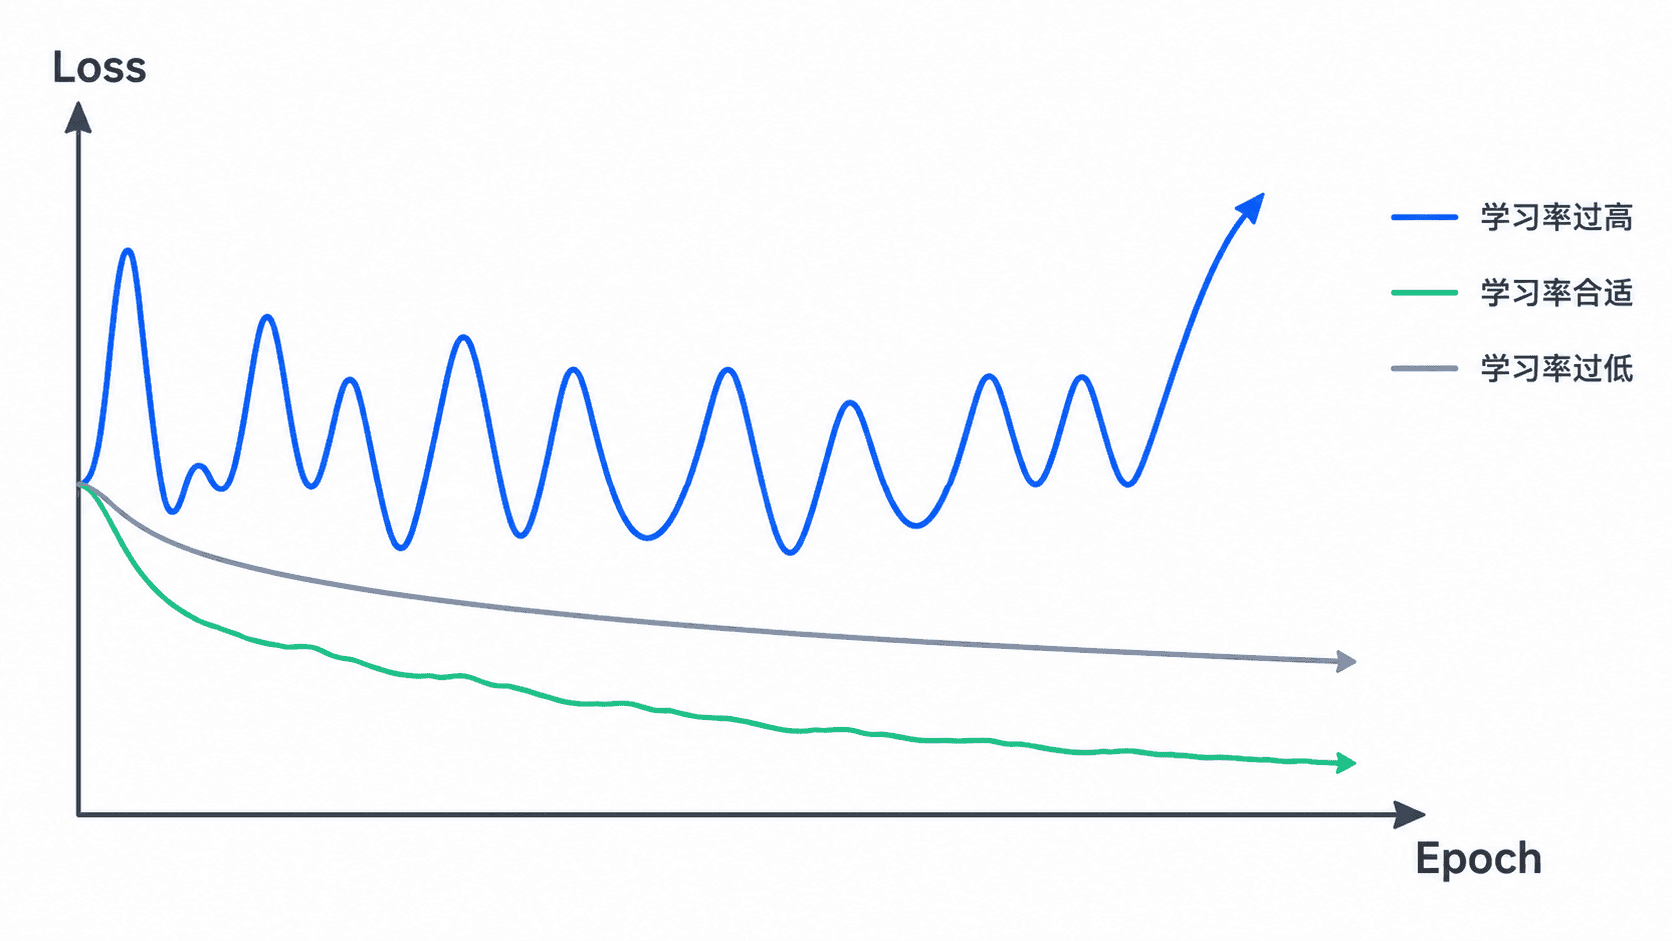
判断时不要只看某一个训练损失。训练损失持续下降而验证 mAP 停滞甚至回落,可能是过拟合、数据问题或正则化不足,并不等于继续提高学习率就能解决。
修改初始学习率和衰减比例
YOLOv5 超参数文件中的 lr0 表示初始学习率,lrf 表示训练末期学习率相对 lr0 的比例。可近似理解为:
下面先复制仓库自带的超参数文件,再只修改学习率字段,避免遗漏数据增强、损失权重等必需配置。若你的仓库没有 hyp.scratch-low.yaml,应改成 data/hyps 目录中实际存在的默认文件。
python - <<'PY'
from pathlib import Path
import yaml

source = Path("data/hyps/hyp.scratch-low.yaml")
target = Path("data/hyps/hyp.lr-tune.yaml")

hyp = yaml.safe_load(source.read_text(encoding="utf-8"))
hyp["lr0"] = 0.005
hyp["lrf"] = 0.10

target.write_text(
    yaml.safe_dump(hyp, sort_keys=False, allow_unicode=True),
    encoding="utf-8",
)
print(f"已生成 {target}")
PY

python train.py --img 640 --batch-size 16 --epochs 100 --data data/custom.yaml --weights yolov5s.pt --hyp data/hyps/hyp.lr-tune.yaml --name lr005
预期输出
已生成 data/hyps/hyp.lr-tune.yaml
<YOLOv5 启动日志,超参数中 lr0=0.005、lrf=0.1>
Starting training for 100 epochs...
配置生效后,训练目录会生成结果曲线和指标文件。实际目录通常位于 runs/train/lr005;若名称被自动追加序号,以终端打印的保存路径为准。
用小范围对照实验定位区间
不要一次把学习率从很小改到很大。先保留一组基线,再分别测试基线的 0.5 倍和 2 倍,并保持模型、数据、批量大小、随机种子和训练轮数一致。短实验通常运行 10~20 个 epoch,就能排除明显不稳定的设置。
比较时先看是否出现震荡或异常值,再看相同 epoch 下的验证损失和 mAP。若三组都稳定,优先保留下降更快且验证指标更好的区间,再进行完整训练,而不是直接选择训练损失最低的一组。
批量大小变化时同步检查
批量变大后,每次更新汇总的样本更多,常见起点是线性缩放:
例如批量从 16 调到 32,可先尝试把学习率提高到原来的 2 倍。但这只是经验起点,不是固定规则;预训练权重、优化器、数据规模和梯度累积都会影响结果。
批量减小时通常应降低学习率,并保留 warmup。若训练最开始几轮就震荡,先延长 warmup 或降低 lr0,不要急着修改损失权重和数据增强,否则难以定位根因。
验收与常见误判
完成调整后,应确认训练没有异常值,损失整体下降,验证 mAP 在相同训练预算下优于或不差于基线。若只有训练损失改善而验证指标下降,应回退到基线并检查过拟合,而不是继续放大学习率。
学习率调度决定“何时减速”,初始学习率决定“起步多快”。两者必须一起观察:lr0 合适但 lrf 过大,训练后期可能仍在震荡;lrf 过小,则可能过早进入几乎不更新的状态。
本课总结
- 过高学习率常导致震荡或发散,过低学习率会让收敛过慢
- 修改学习率时应复制完整超参数文件,只调整
lr0、lrf等目标字段 - 批量大小变化后可用线性缩放作为起点,但最终必须用验证曲线确认
下一课预告
下一课将继续结合训练日志分析过拟合与欠拟合,并说明何时应调整数据增强、训练轮数或模型规模。