
计算机视觉 / 系统课时
测量推理性能
测量推理性能
本课把一次 YOLOv5 推理拆成预处理、模型推理和后处理三段分别计时,并通过预热、同步和多轮统计减少误差,最终定位真正限制吞吐量的环节。
学习目标
- 能够分别测量预处理、模型推理和后处理耗时
- 理解 GPU 同步、模型预热和多轮统计对结果的影响
- 根据端到端耗时判断性能瓶颈和优化优先级
建立分段计时模型
端到端耗时不是单纯的模型前向时间,而是三段耗时之和:
预处理包含缩放填充、通道转换、张量搬运和归一化;模型推理是网络前向计算;后处理通常包含置信度过滤、非极大值抑制和结果整理。只查看模型前向时间,容易高估真实吞吐量。
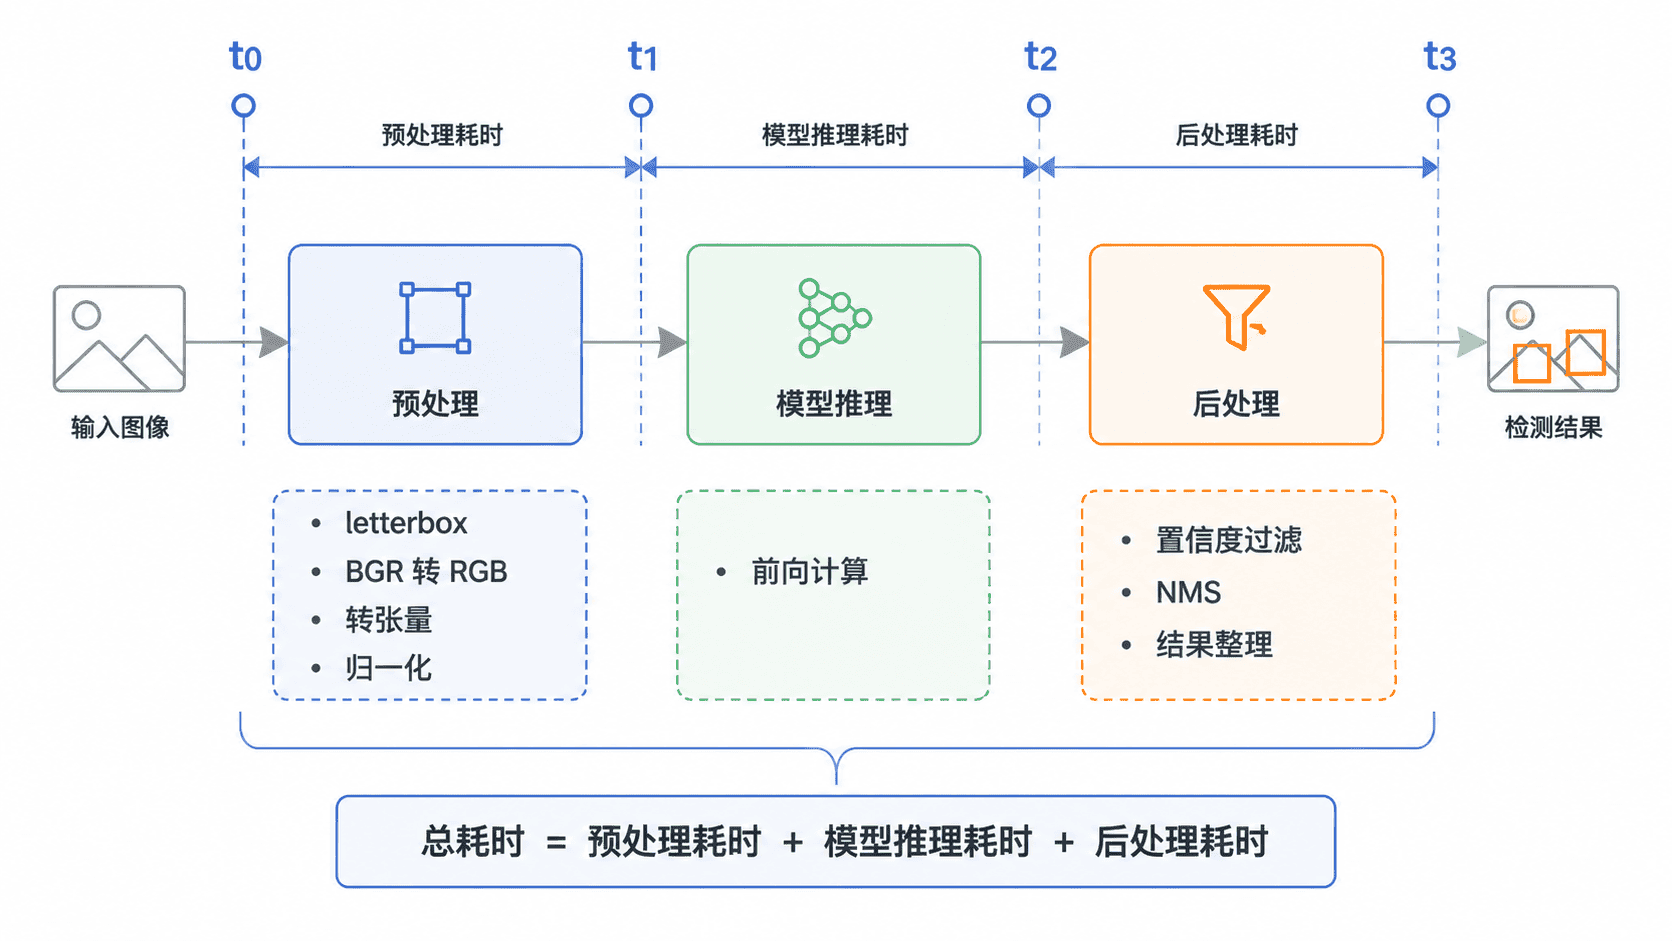
GPU 操作默认异步执行。若直接在前向调用前后读取系统时钟,CPU 可能已经继续执行,而 GPU 仍在计算,因此必须在计时边界调用同步操作。正式统计前还应进行若干轮预热,让显存分配、CUDA 内核选择和缓存进入稳定状态。
编写性能测试脚本
以下脚本需要放在 YOLOv5 项目根目录运行。它使用项目内部的 DetectMultiBackend、letterbox 和 non_max_suppression,分别记录三段耗时,并输出多轮平均值。
import argparse
import time

import cv2
import numpy as np
import torch

from models.common import DetectMultiBackend
from utils.augmentations import letterbox
from utils.general import check_img_size, non_max_suppression
from utils.torch_utils import select_device

def synchronize(device: torch.device) -> None:
    if device.type == "cuda":
        torch.cuda.synchronize(device)

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--weights", required=True)
    parser.add_argument("--source", required=True)
    parser.add_argument("--device", default="0")
    parser.add_argument("--imgsz", type=int, default=640)
    parser.add_argument("--warmup", type=int, default=10)
    parser.add_argument("--runs", type=int, default=50)
    args = parser.parse_args()

    if args.warmup < 1 or args.runs < 1:
        raise ValueError("warmup 和 runs 必须大于 0")

    device = select_device(args.device)
    model = DetectMultiBackend(args.weights, device=device, fp16=False)
    stride = int(model.stride)
    image_size = check_img_size((args.imgsz, args.imgsz), s=stride)

    image = cv2.imread(args.source)
    if image is None:
        raise FileNotFoundError(f"无法读取图片:{args.source}")

    # 预热使用与正式测试相同的输入尺寸,避免首轮初始化污染结果。
    model.warmup(imgsz=(1, 3, image_size[0], image_size[1]))

    preprocess_times = []
    inference_times = []
    postprocess_times = []
    total_rounds = args.warmup + args.runs

    for round_index in range(total_rounds):
        synchronize(device)
        t0 = time.perf_counter()

        resized = letterbox(image, image_size, stride=stride, auto=False)[0]
        tensor_image = resized[:, :, ::-1].transpose(2, 0, 1)
        tensor_image = np.ascontiguousarray(tensor_image)
        tensor = torch.from_numpy(tensor_image).to(device)
        tensor = tensor.float() / 255.0
        tensor = tensor.unsqueeze(0)

        synchronize(device)
        t1 = time.perf_counter()

        prediction = model(tensor, augment=False, visualize=False)

        synchronize(device)
        t2 = time.perf_counter()

        _ = non_max_suppression(
            prediction,
            conf_thres=0.25,
            iou_thres=0.45,
            max_det=1000,
        )

        synchronize(device)
        t3 = time.perf_counter()

        if round_index >= args.warmup:
            preprocess_times.append((t1 - t0) * 1000)
            inference_times.append((t2 - t1) * 1000)
            postprocess_times.append((t3 - t2) * 1000)

    preprocess_ms = float(np.mean(preprocess_times))
    inference_ms = float(np.mean(inference_times))
    postprocess_ms = float(np.mean(postprocess_times))
    total_ms = preprocess_ms + inference_ms + postprocess_ms
    fps = 1000.0 / total_ms

    print(f"设备:{device}")
    print(f"预处理:{preprocess_ms:.2f} ms")
    print(f"模型推理:{inference_ms:.2f} ms")
    print(f"后处理:{postprocess_ms:.2f} ms")
    print(f"端到端:{total_ms:.2f} ms")
    print(f"理论吞吐:{fps:.2f} FPS")

if __name__ == "__main__":
    main()
运行命令:
python benchmark_yolov5.py --weights runs/train/exp/weights/best.pt --source data/images/bus.jpg --device 0 --runs 50预期输出:
设备:cuda:0
预处理:<PREPROCESS_MS> ms
模型推理:<INFERENCE_MS> ms
后处理:<POSTPROCESS_MS> ms
端到端:<TOTAL_MS> ms
理论吞吐:<FPS> FPS
这些占位值受显卡、输入尺寸、模型规模、驱动版本和当前负载影响,实际结果可能不同。若没有可用 GPU,可把 --device 0 改为 --device cpu。
读取测试结果
如果模型推理占比最高,应优先考虑更小的模型、FP16、TensorRT 或降低输入尺寸。若预处理占比异常高,应检查图像解码、CPU 到 GPU 拷贝和数据格式转换。若后处理耗时明显升高,通常说明候选框数量过多,可检查置信度阈值、输入尺寸和场景复杂度。
理论吞吐量按单张端到端平均耗时计算,即 。它不等于真实视频系统 FPS,因为摄像头读取、界面绘制、视频编码和队列等待尚未计入。评估完整应用时,应在最外层再增加一次整体计时。
避免常见测量误差
不要只运行一次并把首轮结果当成结论,首次执行通常包含模型初始化和缓存建立。不要在 GPU 测试中省略同步,也不要把不同输入尺寸、不同批大小或不同精度模式的结果直接比较。
正式对比两个方案时,应固定权重、图片、设备、输入尺寸、预热轮数和统计轮数。除平均值外,还可以记录中位数与高分位耗时,用于观察偶发抖动,但优化判断仍应先从三段平均占比开始。
本课总结
- 推理性能必须拆分为预处理、模型推理和后处理分别测量
- GPU 计时需要同步,正式统计前需要预热并执行多轮测试
- 优化方向应由耗时占比决定,而不是只盯住模型前向时间
下一课预告
下一课将根据性能测试结果调整输入尺寸、精度模式和模型格式,并比较不同优化方案对速度与精度的影响。