
计算机视觉 / 系统课时
采集与筛选图像
采集与筛选图像
高质量数据不是“拍得越多越好”,而是要覆盖模型上线后真正会遇到的场景。本课将从采集计划、现场拍摄、质量筛选和数据验收四个环节,完成一批可进入标注阶段的候选图像。
学习目标
- 根据场景、角度、光照和目标尺度设计采集覆盖矩阵
- 识别模糊、重复、失真和无效图像并建立筛选规则
- 使用脚本完成基础质量检查,输出可复核的淘汰清单
先定义采集边界
开始拍摄前,先写清检测对象、使用环境和模型边界。例如“检测仓库通道中的安全帽”至少要明确安全帽类别、摄像头高度、室内外环境、允许的遮挡程度,以及是否需要保留无人或无目标画面。
候选数据应同时包含正样本、困难样本和负样本。正样本展示目标的常见形态;困难样本覆盖遮挡、密集、过暗、过曝和小目标;负样本不包含目标,用于降低模型把相似背景误判为目标的概率。
用覆盖矩阵规划拍摄
不要只按“拍摄数量”分配任务,而要按关键维度交叉覆盖。下面的矩阵可作为最低采集清单,实际项目还应结合设备位置和业务高峰补充场景。
| 维度 | 建议覆盖 | 检查重点 |
|---|---|---|
| 场景 | 室内、室外、入口、远端背景 | 背景是否与上线环境一致 |
| 角度 | 正面、侧面、俯视、斜视 | 目标外观是否发生明显变化 |
| 光照 | 正常、逆光、阴影、夜间 | 轮廓和纹理是否仍可辨认 |
| 尺度 | 大、中、小目标 | 小目标是否仍有足够像素 |
| 状态 | 完整、部分遮挡、密集重叠 | 是否覆盖真实困难样本 |
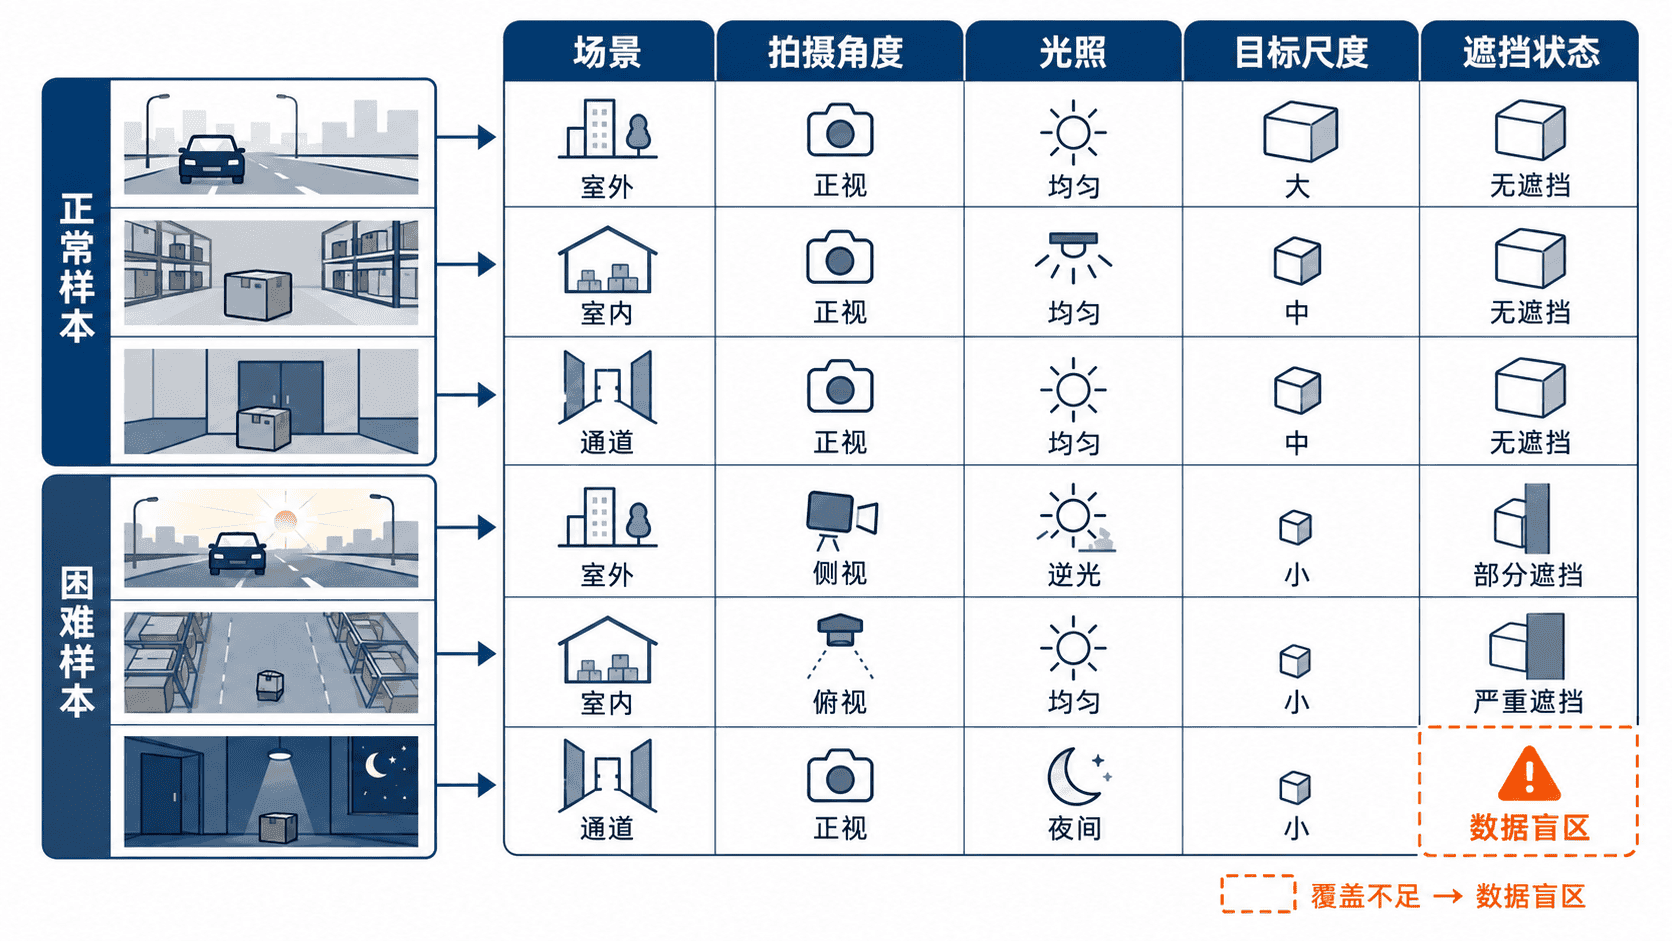
同一目标不要连续拍摄大量近乎相同的帧。视频抽帧时应按时间间隔或画面变化采样,避免训练集被某一段背景和姿态占满。
按批次采集并保留来源
建议按“日期—设备—场景—批次”保存原始图像,并额外记录拍摄地点、设备编号、时间段和异常说明。文件名只需保证唯一,不必把所有业务信息都塞进名称中,详细来源可以写入 CSV 清单。
训练集、验证集和测试集应按来源批次划分,而不是随机拆散连续帧。否则同一视频前后相邻画面可能同时进入训练集和验证集,得到虚高的评估结果。
自动筛除明显无效图像
下面的脚本会检查图片是否损坏、尺寸是否过小以及是否存在内容完全相同的重复文件,并把淘汰原因写入 rejected.csv。运行前需在当前 Python 环境中安装 Pillow,并把待检查图片放入 raw_images 目录。
from pathlib import Path
from hashlib import sha256
import csv
import sys

from PIL import Image, UnidentifiedImageError

IMAGE_SUFFIXES = {'.jpg', '.jpeg', '.png', '.bmp'}

def scan_images(root: Path, min_width: int = 320, min_height: int = 320):
    accepted = []
    rejected = []
    seen_hashes = {}

    for path in sorted(root.rglob('*')):
        if not path.is_file() or path.suffix.lower() not in IMAGE_SUFFIXES:
            continue

        try:
            digest = sha256(path.read_bytes()).hexdigest()

            # verify() 只校验文件完整性,不会解码并修改原图。
            with Image.open(path) as image:
                width, height = image.size
                image.verify()

            if width < min_width or height < min_height:
                rejected.append((str(path), 'too_small'))
            elif digest in seen_hashes:
                rejected.append((str(path), f'duplicate_of:{seen_hashes[digest]}'))
            else:
                seen_hashes[digest] = str(path)
                accepted.append(str(path))
        except (UnidentifiedImageError, OSError):
            rejected.append((str(path), 'corrupted_or_unsupported'))

    return accepted, rejected

def main():
    root = Path(sys.argv[1] if len(sys.argv) > 1 else 'raw_images')
    accepted, rejected = scan_images(root)

    # 保留淘汰清单,便于人工复核误删情况。
    with open('rejected.csv', 'w', newline='', encoding='utf-8-sig') as file:
        writer = csv.writer(file)
        writer.writerow(['file', 'reason'])
        writer.writerows(rejected)

    print(f'accepted={len(accepted)}')
    print(f'rejected={len(rejected)}')
    print('report=rejected.csv')

if __name__ == '__main__':
    main()
预期输出
accepted=<ACCEPTED_COUNT>
rejected=<REJECTED_COUNT>
report=rejected.csv
<ACCEPTED_COUNT> 和 <REJECTED_COUNT> 会随实际数据变化。脚本只能排除明显问题,运动模糊、严重遮挡、目标过小和场景失真仍需人工抽查。
完成入标注前验收
从每个场景批次随机抽取图像复核,确认目标可辨认、场景分布没有明显偏科、连续帧比例受控,并检查负样本是否来自真实业务环境。发现某个维度缺失时,应优先补采,而不是用大量相似图片凑数量。
最终保留原始数据、筛选后数据和淘汰清单三个版本。这样既能追溯筛选依据,也能在后续发现规则过严时恢复误删图像。
本课总结
- 数据采集应围绕真实上线场景建立多维覆盖,而不是单纯追求图片数量
- 连续帧和同源画面必须按批次隔离,避免训练集与验证集发生数据泄漏
- 自动脚本负责发现损坏、过小和重复文件,语义质量仍需人工复核
下一课预告
下一课将使用标注工具绘制边界框、统一类别名称,并导出 YOLOv5 可直接读取的标签文件。