
计算机视觉 / 系统课时
读取训练输出
读取训练输出
本课将整理一次 YOLOv5 训练结束后生成的核心文件,并建立“文件名称—含义—使用场景”的对应关系。完成后,你能够快速找到可部署权重、判断训练是否过拟合,并通过批次图和验证图检查数据与预测质量。
学习目标
- 区分
best.pt与last.pt的用途 - 读取训练曲线、指标表和批次样本图
- 根据验证结果判断下一步应继续训练还是调整数据
定位输出目录
若训练命令使用 --project runs/train --name custom-first,默认结果位于 runs/train/custom-first。先列出目录内容,确认训练产物已经写入磁盘。
cd <YOLOV5_PATH>
find runs/train/custom-first -maxdepth 2 -type f | sort
预期输出
runs/train/custom-first/F1_curve.png
runs/train/custom-first/PR_curve.png
runs/train/custom-first/confusion_matrix.png
runs/train/custom-first/results.csv
runs/train/custom-first/results.png
runs/train/custom-first/train_batch0.jpg
runs/train/custom-first/val_batch0_labels.jpg
runs/train/custom-first/val_batch0_pred.jpg
runs/train/custom-first/weights/best.pt
runs/train/custom-first/weights/last.pt
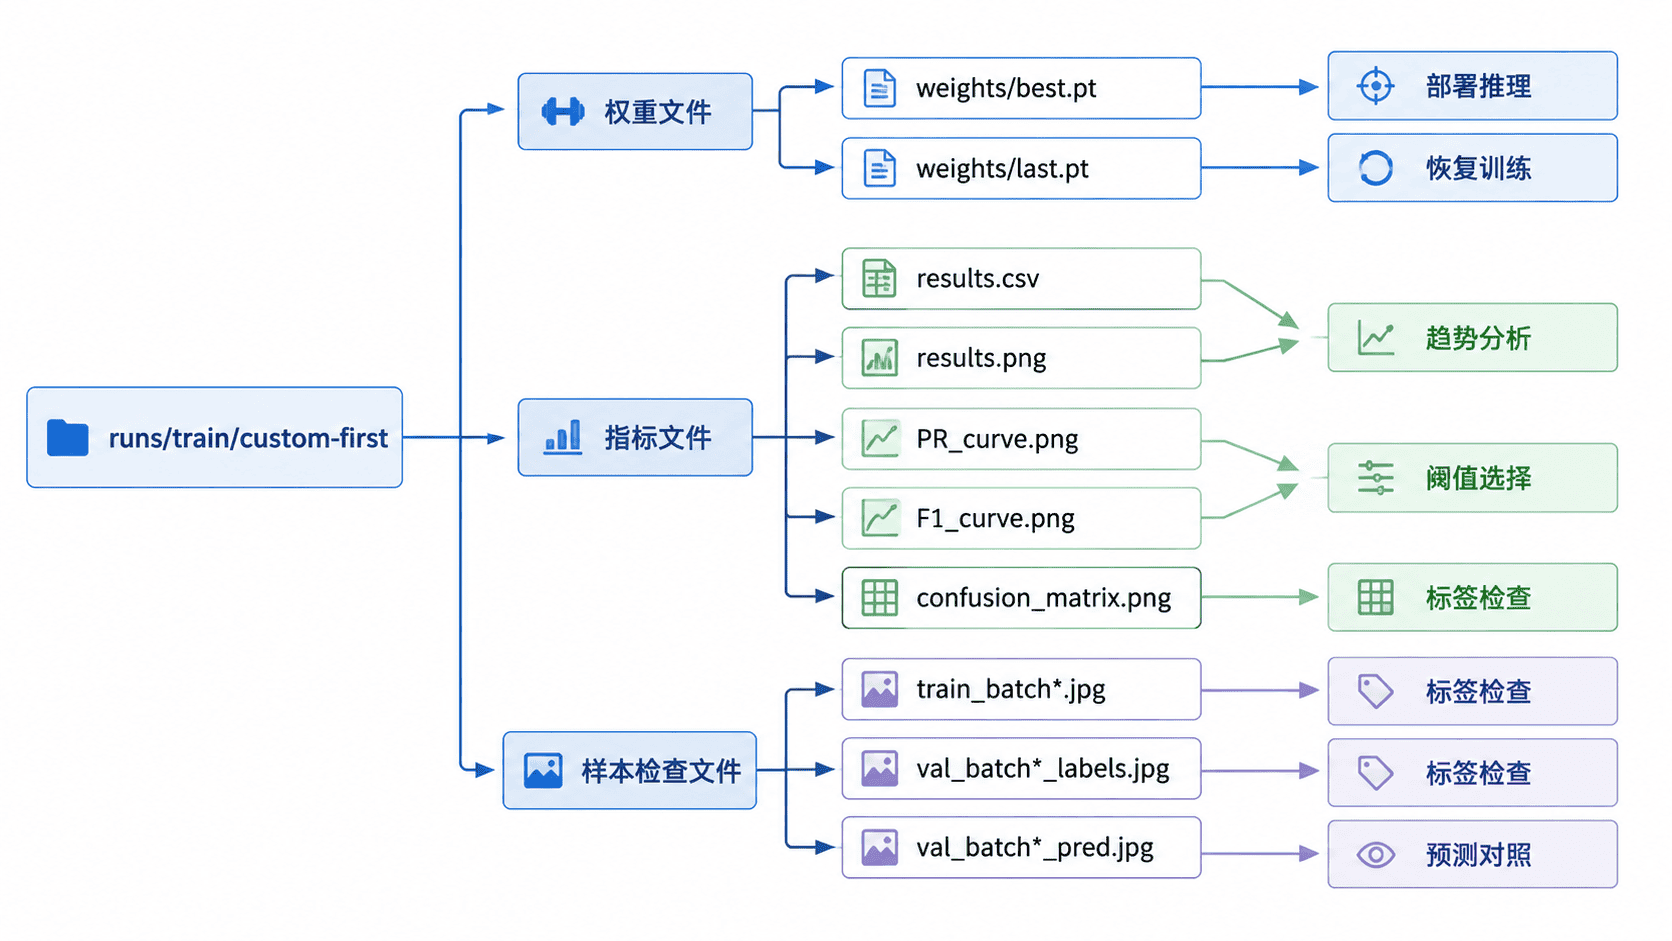
不同 YOLOv5 版本或训练参数可能生成额外文件,但 weights、指标记录和批次图通常是最重要的三类产物。
区分最佳权重和最后权重
weights/best.pt 是训练过程中验证指标表现最好的检查点,通常用于推理、验证和部署。weights/last.pt 是最后一个训练轮次保存的状态,适合恢复训练或分析训练结束时的模型。
不要仅凭文件修改时间选择权重。若训练后期出现过拟合,最后一轮不一定优于中间轮次,因此部署时通常优先验证 best.pt。
cd <YOLOV5_PATH>
python detect.py \
  --weights runs/train/custom-first/weights/best.pt \
  --source <IMAGE_PATH> \
  --img 640 \
  --conf-thres 0.25 \
  --project runs/detect \
  --name custom-best
预期输出
image 1/1 <IMAGE_PATH>: 640x640 <DETECTION_SUMMARY>
Results saved to runs/detect/custom-best
检测类别与数量取决于输入图片和模型效果,因此使用 <DETECTION_SUMMARY> 表示动态内容。
读取训练曲线
results.png 汇总训练损失和验证指标随轮次变化的趋势。训练损失持续下降而验证指标先升后降,通常意味着后期开始过拟合;训练损失和验证指标都长期没有改善,则可能需要检查数据质量、学习率、模型容量或训练轮数。
results.csv 保存每轮的数值记录,适合精确比较或二次分析。可用下面脚本读取最后五轮,并找出验证 mAP@0.5 最高的轮次。
from pathlib import Path

import pandas as pd

csv_path = Path("<YOLOV5_PATH>") / "runs/train/custom-first/results.csv"
df = pd.read_csv(csv_path)
df.columns = [column.strip() for column in df.columns]

metric = "metrics/mAP_0.5"
best_row = df.loc[df[metric].idxmax()]

print(df.tail(5).to_string(index=False))
print(f"best_epoch={int(best_row['epoch'])}")
print(f"best_map50={best_row[metric]:.4f}")
预期输出
 epoch  train/box_loss  train/obj_loss  ...  metrics/mAP_0.5  metrics/mAP_0.5:0.95  ...
 <EPOCH_ROWS>
best_epoch=<EPOCH>
best_map50=<MAP50>
列名可能随版本略有差异。若脚本提示找不到列,应先执行 print(df.columns.tolist()),再按实际列名调整 metric。这里找出的只是 mAP@0.5 最高轮次,而 best.pt 可能依据综合适应度保存,两者不一定完全一致。
检查批次样本和验证图
train_batch*.jpg 展示经过数据增强后的训练批次,可用于发现框偏移、类别错误、标签缺失或增强过强。若框没有覆盖目标,应先修复标签,而不是立即修改模型。
val_batch*_labels.jpg 展示验证集真实标签,val_batch*_pred.jpg 展示模型预测。把两者对照查看,可以直观看出漏检、误检、类别混淆和定位偏差。confusion_matrix.png 用于观察类别之间的混淆,PR_curve.png 与 F1_curve.png 用于选择更合适的置信度阈值。
形成验收结论
读取输出时应先确认训练完成,再依次检查权重、曲线和样本图。模型是否可用不能只看某一个 mAP 数值,还要结合业务目标、类别表现、漏检成本和真实图片推理结果。
若 best.pt 在验证集指标稳定、批次图标签正确、预测图没有明显系统性偏差,就可以进入独立测试集验证。若曲线异常或标签图存在问题,应先修复数据或训练配置,再重新启动实验。
本课总结
best.pt通常用于推理与部署,last.pt主要用于恢复训练results.csv和曲线图用于判断收敛、过拟合与最佳轮次- 批次样本图和验证对照图是发现标签错误与系统性误检的重要依据
下一课预告
下一课将基于训练得到的权重执行验证与推理,并通过置信度阈值和 IoU 阈值观察模型输出变化。