
计算机视觉 / 系统课时
定位漏检样本
定位漏检样本
漏检分析的目标不是简单统计“少检了多少”,而是找到每一个未匹配真实框对应的原图,并判断它为什么没有被模型接住。本课将给出可复现的筛选逻辑,再把漏检样本按尺度、遮挡、模糊、光照和标注问题分类。
学习目标
- 使用 IoU 匹配找出未被预测框覆盖的真实目标
- 建立漏检样本的统一检查顺序
- 将漏检原因转化为数据、参数或标注修复动作
定义什么是漏检
在验证阶段,先过滤低于置信度阈值的预测框,再按类别和 IoU 与真实框做一对一匹配。某个真实框没有找到同类别且 IoU 达到阈值的预测框,就记为漏检。阈值越严格,漏检数量通常越多,因此比较不同实验时必须保持置信度阈值和 IoU 阈值一致。
只看最终图片数量不够,因为一张图片可能同时包含多个目标。漏检记录至少应保留图片名、类别、真实框坐标、目标面积和最佳匹配 IoU,后续才能按原因聚类。
自动筛出未匹配目标
下面的完整脚本读取 YOLO 格式的真实标签和预测标签。真实标签每行是 class x_center y_center width height,预测标签额外包含最后一列置信度。脚本按预测置信度从高到低进行一对一匹配,并输出未匹配目标的文件名与尺度。
from pathlib import Path
import argparse
def to_xyxy(box):
    x, y, w, h = box
    return x - w / 2, y - h / 2, x + w / 2, y + h / 2
def iou(box_a, box_b):
    ax1, ay1, ax2, ay2 = to_xyxy(box_a)
    bx1, by1, bx2, by2 = to_xyxy(box_b)
    inter_w = max(0.0, min(ax2, bx2) - max(ax1, bx1))
    inter_h = max(0.0, min(ay2, by2) - max(ay1, by1))
    inter = inter_w * inter_h
    area_a = max(0.0, ax2 - ax1) * max(0.0, ay2 - ay1)
    area_b = max(0.0, bx2 - bx1) * max(0.0, by2 - by1)
    union = area_a + area_b - inter
    return inter / union if union else 0.0
def read_rows(path, with_confidence):
    if not path.exists():
        return []
    rows = []
    for line in path.read_text(encoding="utf-8").splitlines():
        parts = [float(value) for value in line.split()]
        expected = 6 if with_confidence else 5
        if len(parts) != expected:
            raise ValueError(f"invalid row in {path}: {line}")
        rows.append((int(parts[0]), parts[1:5], parts[5] if with_confidence else 1.0))
    return rows
def find_missed(targets, predictions, iou_threshold):
    matched = set()
    for pred_class, pred_box, confidence in sorted(predictions, key=lambda row: row[2], reverse=True):
        candidates = [(iou(target_box, pred_box), index) for index, (target_class, target_box, _) in enumerate(targets) if index not in matched and target_class == pred_class]
        best_iou, best_index = max(candidates, default=(0.0, -1))
        if best_iou >= iou_threshold:
            matched.add(best_index)
    missed = []
    for index, (class_id, target_box, _) in enumerate(targets):
        if index in matched:
            continue
        same_class = [iou(target_box, pred_box) for pred_class, pred_box, _ in predictions if pred_class == class_id]
        missed.append((class_id, target_box, max(same_class, default=0.0)))
    return missed
def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--labels", type=Path)
    parser.add_argument("--preds", type=Path)
    parser.add_argument("--iou", type=float, default=0.5)
    parser.add_argument("--conf", type=float, default=0.25)
    parser.add_argument("--demo", action="store_true")
    args = parser.parse_args()
    if args.demo:
        samples = {
            "img_001": ([(0, [0.5, 0.5, 0.05, 0.08], 1.0)], []),
            "img_027": ([(1, [0.5, 0.5, 0.2, 0.2], 1.0)], [(1, [0.58, 0.5, 0.2, 0.2], 0.8)]),
        }
    else:
        if not args.labels or not args.preds:
            parser.error("--labels and --preds are required unless --demo is used")
        samples = {}
        for label_file in sorted(args.labels.glob("*.txt")):
            targets = read_rows(label_file, False)
            predictions = [row for row in read_rows(args.preds / label_file.name, True) if row[2] >= args.conf]
            samples[label_file.stem] = (targets, predictions)
    total = 0
    for stem, (targets, predictions) in samples.items():
        for class_id, target_box, best_iou in find_missed(targets, predictions, args.iou):
            area = target_box[2] * target_box[3]
            scale = "small" if area < 0.01 else "medium" if area < 0.09 else "large"
            print(f"{stem} class={class_id} scale={scale} best_iou={best_iou:.3f}")
            total += 1
    print(f"missed_total={total}")
if __name__ == "__main__":
    main()
运行演示数据
python find_missed.py --demo预期输出
img_001 class=0 scale=small best_iou=0.000
img_027 class=1 scale=medium best_iou=0.429
missed_total=2
分析真实结果时,可运行 python find_missed.py --labels "<PATH>/labels/val" --preds "<PATH>/runs/val/exp/labels"。将 <PATH> 替换为实际路径,预测标签需包含置信度列;实际文件名和数量会随数据集变化。
按固定顺序检查原因
先检查标注质量,因为错误或缺失标注会让后续判断失真。确认类别编号、边界框范围和困难样本标注规则一致后,再检查目标尺寸、遮挡、模糊和光照。最后才分析模型容量、输入尺寸或训练参数。
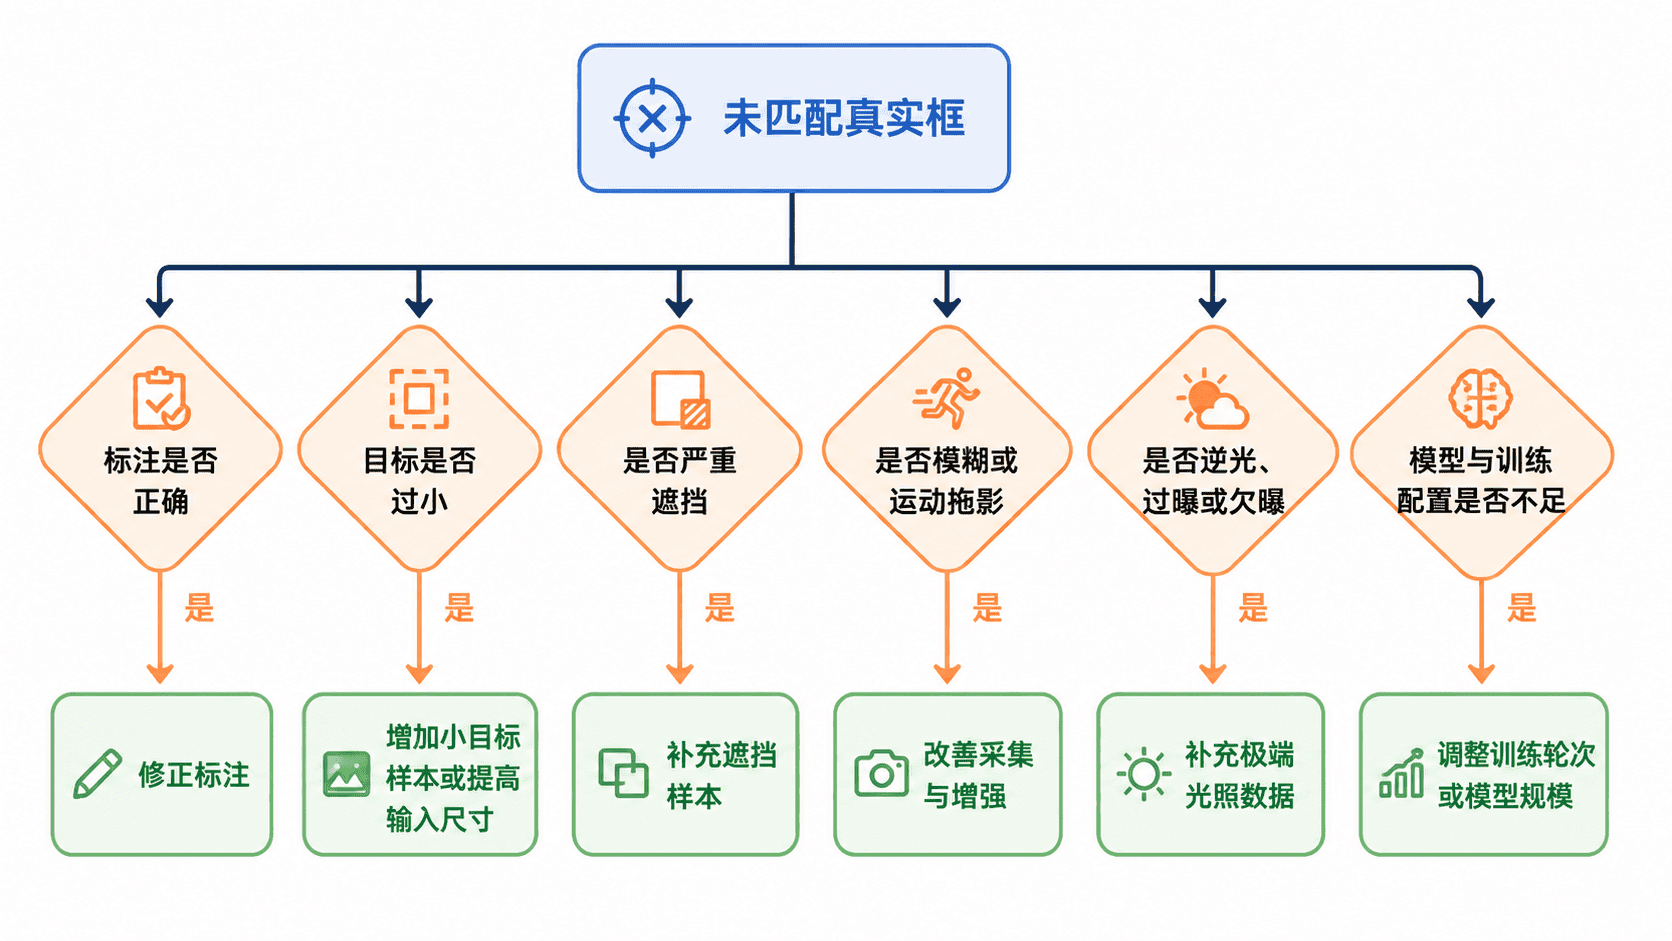
目标尺度可用归一化面积 粗分组。小目标漏检集中时,优先检查输入分辨率、下采样后的有效像素和小目标样本占比。遮挡问题则要确认可见区域是否仍包含稳定特征,并补充不同遮挡比例的训练样本。
模糊样本要区分失焦与运动模糊,两者对应不同的数据采集和增强方式。光照问题应分别统计逆光、过曝、欠曝和局部强反光。若漏检只集中在某个摄像头或场景,还要检查训练集与部署域之间的差异。
将原因映射到修复与验证
当漏检来自标注遗漏、框偏移或类别错误时,应先修复数据并重新划分验证集。来自小目标或遮挡时,应补充对应困难样本,必要时提高输入尺寸,但要同时评估显存和推理延迟。
若目标框附近存在低置信度预测,说明模型已经捕捉到部分特征,可以检查置信度阈值、类别不平衡和训练轮次。若完全没有候选框,则更可能是特征不足、尺度不适配或数据域差异。不要仅通过降低阈值解决漏检,因为这通常会同步增加背景误检。
修复后使用相同验证集、相同阈值和相同脚本复测。除了总漏检数,还应比较各类别、各尺度和各原因分组的变化,并确认误检数量没有明显上升。只有目标分组改善且其他指标未显著退化,才能认为修复有效。
本课总结
- 漏检应按真实框逐个匹配,而不是只按图片数量统计
- 先排除标注问题,再检查尺度、遮挡、模糊、光照和模型配置
- 修复必须在相同阈值与验证集上复测,并同时观察误检变化
下一课预告
下一课将把误检与漏检结果合并成误差分析清单,用统一优先级安排数据补充、标注修正和模型调参。