
计算机视觉 / 系统课时
YOLOv5 模型规格
YOLOv5 模型规格
本课对比 YOLOv5n、YOLOv5s、YOLOv5m、YOLOv5l 和 YOLOv5x 五种常用规格,帮助你从参数量、计算量、速度和精度四个维度完成选型。学完后,你可以根据设备资源和业务目标,选择合适的起点,而不是盲目使用最大模型。
学习目标
- 认识 YOLOv5 五种规格的规模关系
- 理解参数量、计算量、速度与精度之间的取舍
- 能根据训练设备和部署场景选择合适模型
五种规格代表什么
YOLOv5 的字母后缀表示模型规模:n、s、m、l、x 依次对应 nano、small、medium、large 和 extra large。它们使用相似的整体结构,但会调整网络深度和通道宽度,因此参数量与计算量逐级增加。
规模越小,训练和推理通常越快,对显存要求也越低;规模越大,特征表达能力通常越强,更容易获得较高精度,但训练时间、部署成本和推理延迟也会增加。
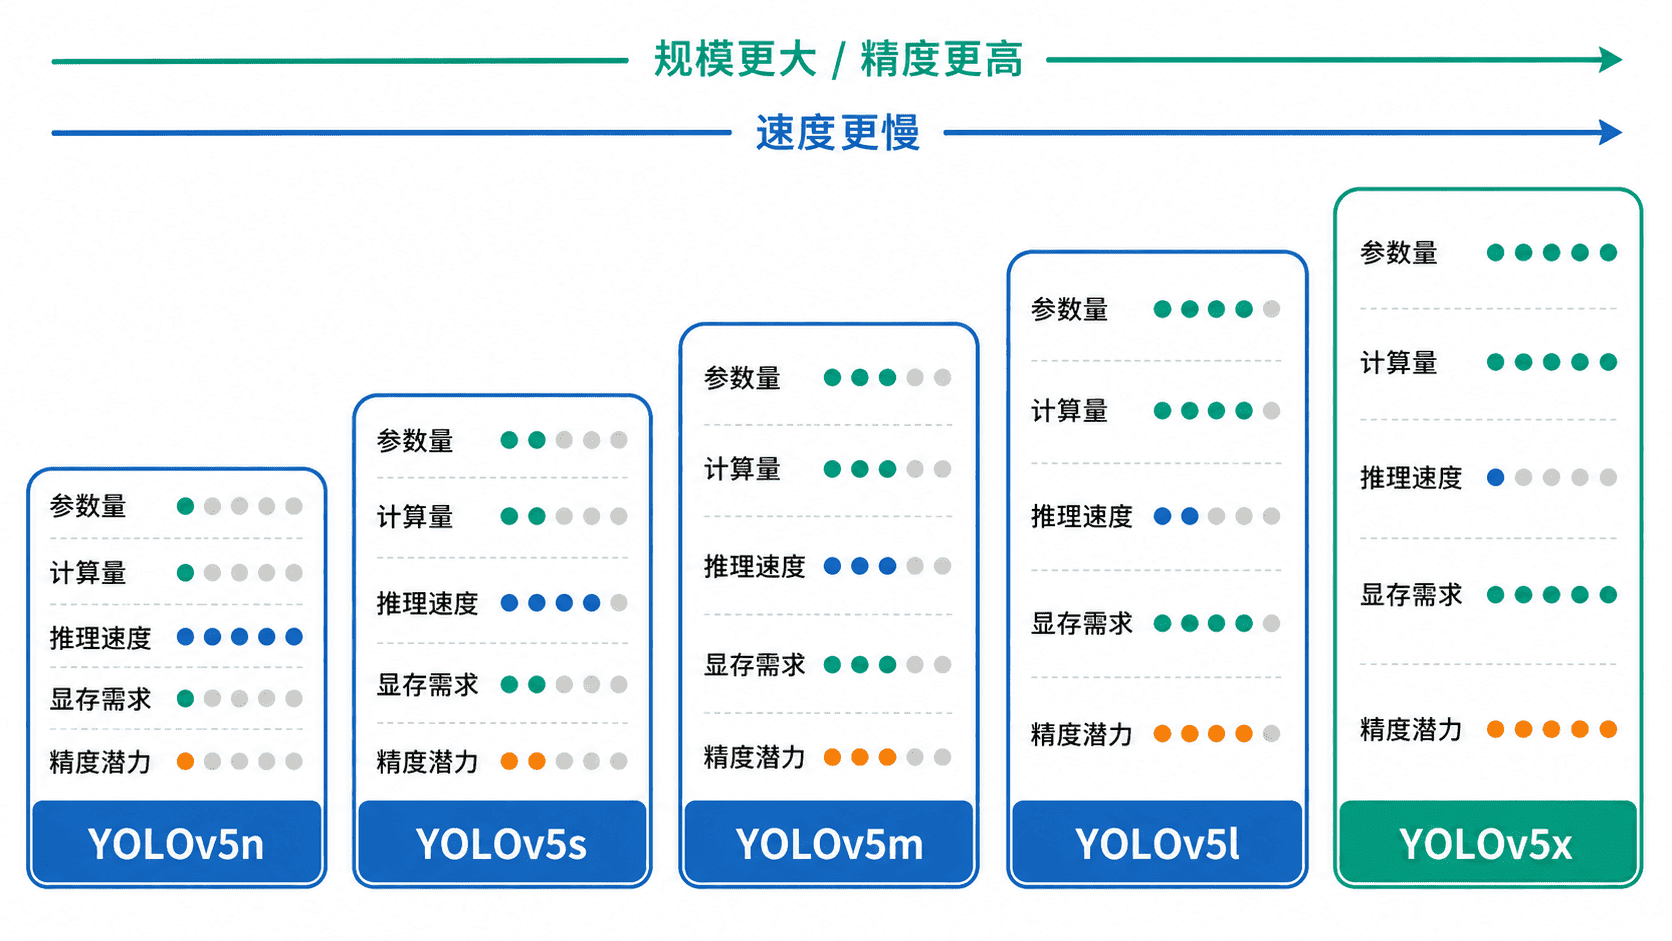
参数量与计算量对比
以下数据采用常见 YOLOv5 配置和 640×640 输入尺寸进行近似比较。不同代码版本、导出格式和计算工具可能得到略有差异的结果,因此表格更适合用于理解数量级,而不是作为绝对性能承诺。
| 规格 | 参数量约值 | 计算量约值 | 典型特点 |
|---|---|---|---|
| YOLOv5n | 1.9M | 4.5 GFLOPs | 最轻量,适合资源紧张设备 |
| YOLOv5s | 7.2M | 16.5 GFLOPs | 速度与精度较均衡 |
| YOLOv5m | 21.2M | 49.0 GFLOPs | 精度提升明显,资源需求中等 |
| YOLOv5l | 46.5M | 109.1 GFLOPs | 面向更高精度和较强算力 |
| YOLOv5x | 86.7M | 205.7 GFLOPs | 规模最大,训练与部署成本最高 |
参数量主要影响模型文件大小和内存占用,计算量主要影响一次推理需要完成多少乘加运算。两者通常相关,但不能直接等同于真实速度,因为推理速度还会受到硬件、批量大小、框架优化和模型导出格式影响。
按场景选择模型
YOLOv5n 适合移动端、嵌入式设备或快速验证,但在小目标和复杂场景中更容易遇到精度上限。YOLOv5s 通常是课程学习和业务原型的首选,因为训练速度快,效果也足以暴露数据与标注问题。
YOLOv5m 适合已经验证任务可行、希望进一步提升精度的项目。YOLOv5l 和 YOLOv5x 更适合服务器端离线分析或对精度要求较高的场景,但前提是训练数据质量足够,否则增大模型并不会自动解决错误标注和样本不足。
选型时容易出现的误区
最大模型不一定得到最高业务收益。若摄像头画面模糊、目标尺寸过小或标签不一致,模型扩大后可能只增加训练成本。正确顺序通常是先用 YOLOv5s 建立基线,确认数据流程、评价指标和部署链路,再根据瓶颈尝试更大的规格。
也不要只依据训练阶段的单张图速度做结论。上线前应在目标设备上测量端到端延迟,包括图像读取、预处理、模型推理、非极大值抑制和结果传输,才能得到真实吞吐量。
推荐的实践起点
初次训练自定义数据集时,优先选择 YOLOv5s。若显存非常有限,可改用 YOLOv5n;若 YOLOv5s 已稳定收敛且精度仍不足,再依次尝试 YOLOv5m 或 YOLOv5l。只有在数据规模、算力和延迟预算都允许时,才需要考虑 YOLOv5x。
这种由小到大的策略可以快速建立基线,也能判断精度提升究竟来自模型容量,还是来自数据清洗、输入尺寸和训练参数调整。
本课总结
- YOLOv5n 到 YOLOv5x 的参数量和计算量逐级增加,速度与精度形成明显取舍
- YOLOv5s 通常最适合作为训练基线,较大模型应在明确瓶颈后再使用
- 最终选型必须在目标设备上验证端到端延迟、显存占用和实际精度
下一课预告
下一课将进入 YOLOv5 的整体网络结构,说明 Backbone、Neck 和 Detect Head 如何协作完成多尺度目标检测。