
计算机视觉 / 系统课时
开发项目推理程序
开发项目推理程序
本课把训练得到的最终权重接入一个可直接运行的推理程序,完成图片、视频和摄像头输入处理、检测结果保存、告警规则判断与运行验证。完成后,你将得到项目交付阶段可复用的统一推理入口。
学习目标
- 使用最终权重完成图片、视频和摄像头推理
- 将检测结果转换为业务规则并输出明确状态
- 通过正常、告警和空结果样本验证程序可用性
推理链路与验收口径
项目推理不是只调用一次模型,而是把输入读取、模型预测、结果解析、业务判断、可视化和文件保存串成稳定链路。任何一环缺失,程序都难以用于现场演示或后续部署。
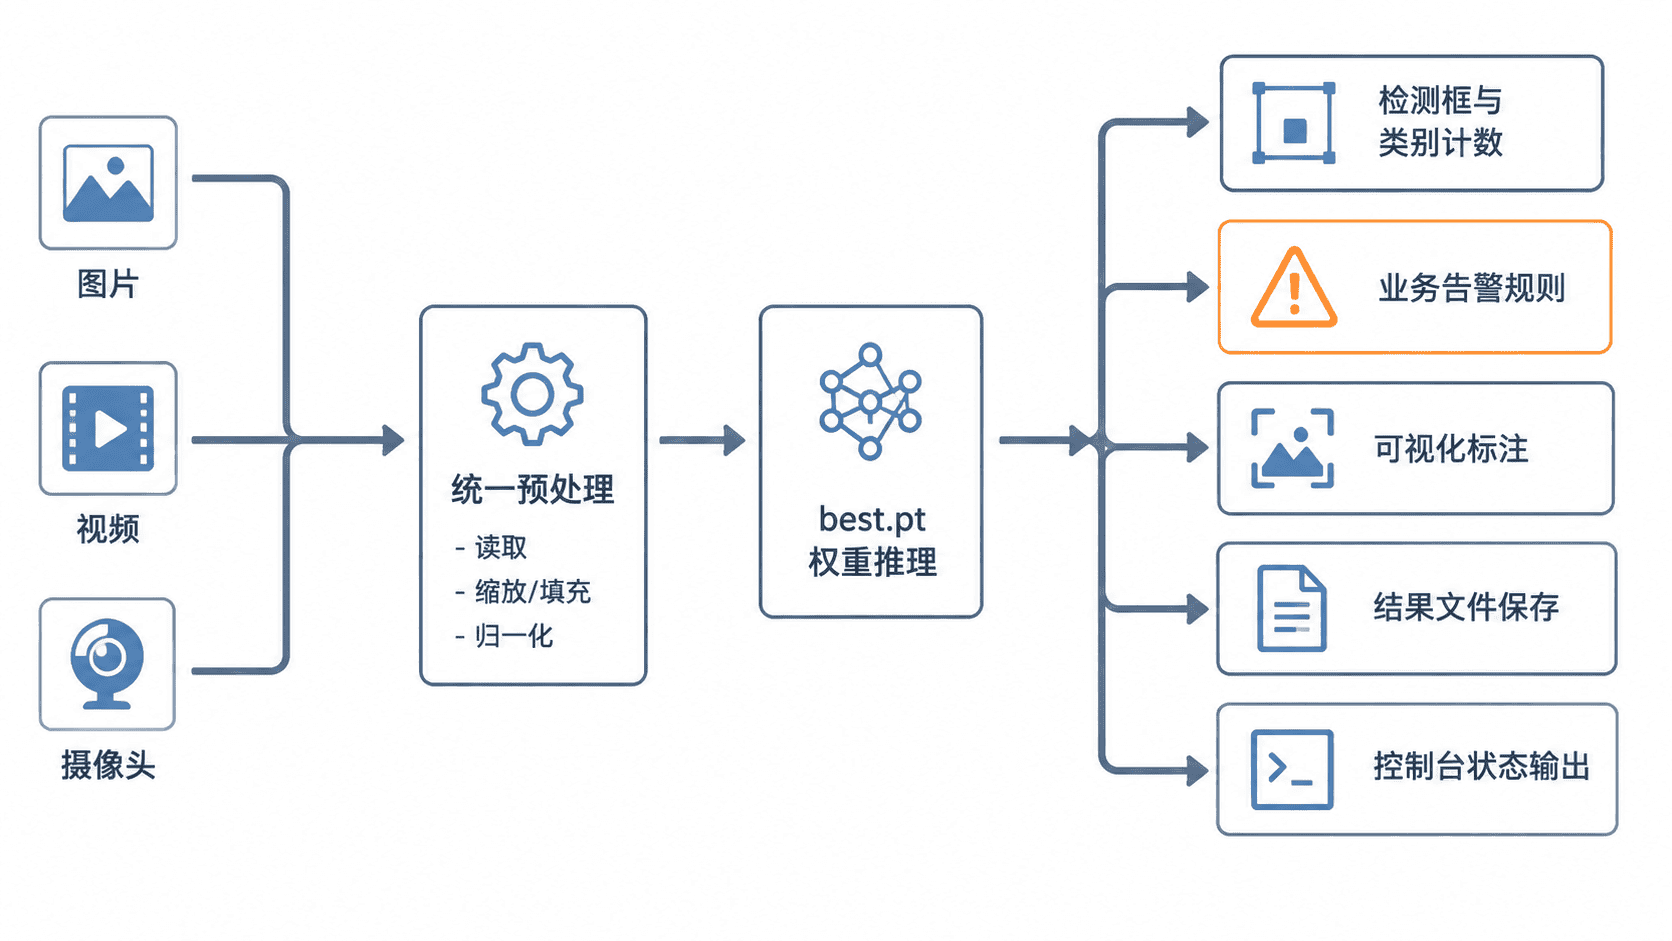
验收时至少检查四点:程序能加载指定权重;不同输入类型能被正确识别;无目标时不会异常;命中业务条件时能输出 ALERT,否则输出 PASS。
实现完整推理程序
下面的程序默认读取 weights/best.pt 和 data/demo.jpg。将 SOURCE 改为视频路径即可处理视频,改为字符串 "0" 可打开默认摄像头。程序依赖本地 YOLOv5 源码目录,因此 yolov5、权重和输入文件必须真实存在。
from collections import Counter
from pathlib import Path

import cv2
import torch

REPO_DIR = Path("yolov5")
WEIGHTS_PATH = Path("weights/best.pt")
SOURCE = "data/demo.jpg"  # 图片、视频路径,或摄像头编号字符串 "0"
OUTPUT_DIR = Path("runs/project-infer")

CONF_THRESHOLD = 0.35
IOU_THRESHOLD = 0.45
IMAGE_SIZE = 640
SHOW_WINDOW = True  # 服务器无桌面环境时改为 False

# 根据项目类别名称调整;出现任一目标即触发告警
ALERT_CLASSES = {"no_helmet", "smoke"}
MAX_ALERT_COUNT = 0
IMAGE_SUFFIXES = {".jpg", ".jpeg", ".png", ".bmp", ".webp"}

def load_model():
    if not REPO_DIR.exists():
        raise FileNotFoundError(f"YOLOv5 源码目录不存在: {REPO_DIR}")
    if not WEIGHTS_PATH.is_file():
        raise FileNotFoundError(f"权重文件不存在: {WEIGHTS_PATH}")

    device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
    # 使用本地源码加载,确保推理结构与训练版本一致
    model = torch.hub.load(
        str(REPO_DIR),
        "custom",
        path=str(WEIGHTS_PATH),
        source="local",
        force_reload=False,
    )
    model.to(device)
    model.conf = CONF_THRESHOLD
    model.iou = IOU_THRESHOLD
    return model, device

def infer_frame(model, frame):
    results = model(frame, size=IMAGE_SIZE)
    detections = results.xyxy[0].detach().cpu().tolist()

    counts = Counter()
    # 只把达到阈值的最终检测结果计入业务规则
    for _, _, _, _, confidence, class_id in detections:
        if confidence >= CONF_THRESHOLD:
            counts[model.names[int(class_id)]] += 1

    alert_count = sum(counts[name] for name in ALERT_CLASSES)
    status = "ALERT" if alert_count > MAX_ALERT_COUNT else "PASS"

    # 在模型标注结果上叠加业务状态,便于现场查看
    annotated = results.render()[0].copy()
    label = f"RULE: {status}"
    color = (0, 0, 255) if status == "ALERT" else (0, 180, 0)
    cv2.putText(
        annotated,
        label,
        (20, 40),
        cv2.FONT_HERSHEY_SIMPLEX,
        1.0,
        color,
        2,
        cv2.LINE_AA,
    )
    return annotated, counts, status

def format_counts(counts):
    if not counts:
        return "none"
    return ", ".join(f"{name}:{count}" for name, count in sorted(counts.items()))

def process_image(model, source_path):
    frame = cv2.imread(str(source_path))
    if frame is None:
        raise ValueError(f"无法读取图片: {source_path}")

    annotated, counts, status = infer_frame(model, frame)
    output_path = OUTPUT_DIR / f"{source_path.stem}_result.jpg"
    cv2.imwrite(str(output_path), annotated)
    if SHOW_WINDOW:
        cv2.imshow("YOLOv5 Result", annotated)
        cv2.waitKey(0)
        cv2.destroyAllWindows()

    print(f"source={source_path}")
    print(f"detections={format_counts(counts)}")
    print(f"business_rule={status}")
    print(f"saved_to={output_path}")

def process_stream(model, source):
    capture_source = int(source) if source.isdigit() else source
    cap = cv2.VideoCapture(capture_source)
    if not cap.isOpened():
        raise ValueError(f"无法打开视频源: {source}")

    width = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH))
    height = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT))
    fps = cap.get(cv2.CAP_PROP_FPS) or 25.0
    output_path = OUTPUT_DIR / "stream_result.mp4"
    # 按原视频尺寸写出结果,摄像头模式可按 q 提前结束
    writer = cv2.VideoWriter(
        str(output_path),
        cv2.VideoWriter_fourcc(*"mp4v"),
        fps,
        (width, height),
    )

    total_counts = Counter()
    alert_frames = 0
    frame_count = 0

    while True:
        ok, frame = cap.read()
        if not ok:
            break
        annotated, counts, status = infer_frame(model, frame)
        writer.write(annotated)
        total_counts.update(counts)
        alert_frames += int(status == "ALERT")
        frame_count += 1

        if SHOW_WINDOW:
            cv2.imshow("YOLOv5 Result", annotated)
            if cv2.waitKey(1) & 0xFF == ord("q"):
                break

    cap.release()
    cv2.destroyAllWindows()
    writer.release()
    print(f"source={source}")
    print(f"frames={frame_count}")
    print(f"detections={format_counts(total_counts)}")
    print(f"alert_frames={alert_frames}")
    print(f"saved_to={output_path}")

def main():
    OUTPUT_DIR.mkdir(parents=True, exist_ok=True)
    model, device = load_model()
    print(f"device={device}")

    source_path = Path(SOURCE)
    if source_path.suffix.lower() in IMAGE_SUFFIXES:
        process_image(model, source_path)
    else:
        process_stream(model, SOURCE)

if __name__ == "__main__":
    main()
预期输出(保存为 infer_project.py 并执行 python infer_project.py,类别和数量以实际模型结果为准):
device=<DEVICE>
source=data/demo.jpg
detections=helmet:2, person:2
business_rule=PASS
saved_to=runs/project-infer/demo_result.jpg
实际设备可能显示 cpu 或 cuda:0。如果图片没有任何目标,detections 应输出 none,程序仍应正常保存标注结果。
运行与验证
先使用一张类别清晰的正常图片确认权重、类别名称和保存路径正确,再使用包含 no_helmet 或 smoke 的样本确认告警分支。最后补充一张无目标图片,验证空检测结果不会导致计数或绘制逻辑报错。
业务规则必须建立在模型类别名称之上。若训练数据中的类别叫 without_helmet,而代码仍判断 no_helmet,模型即使检出目标也不会触发告警,因此交付前应核对 model.names 与规则集合。
常见问题
出现 No such file or directory 时,先检查当前工作目录,而不是直接修改代码中的相对路径。建议始终从项目根目录运行程序,使 yolov5、weights、data 和 runs 的相对位置保持一致。
视频可以打开但输出文件无法播放时,通常是编码器或宽高读取失败。应确认输入首帧尺寸不为零,并根据目标环境将 mp4v 替换为可用编码器,再重新完成播放验证。
本课总结
- 推理程序应统一处理输入、预测、业务判断、可视化和结果保存
- 业务告警依赖真实类别名称,必须与最终权重保持一致
- 正常、告警和空结果样本共同构成最小验收集
下一课预告
下一课将整理权重、配置、代码、数据说明、指标报告和部署文档,并通过版本号与校验文件形成可追踪的项目交付包。