
计算机视觉 / 系统课时
损失函数组成
损失函数组成
YOLOv5 训练并不是只判断“框得准不准”,而是同时校正位置、目标存在性和类别判断。本课拆解三类损失的职责,并用一个数值示例说明它们如何合成为最终优化目标。
学习目标
- 说清边界框、目标置信度和分类损失分别约束什么
- 理解三类损失只对哪些预测参与计算
- 能根据各项损失的变化判断训练问题
总损失如何分工
检测头会为每个候选位置输出边界框、目标置信度和类别分数,因此训练目标也被拆成三部分:
实际训练还会为三项乘以不同权重,使数值尺度和优化重点保持平衡。三项不是互相替代,而是共同回答“在哪里、有没有、是什么”。
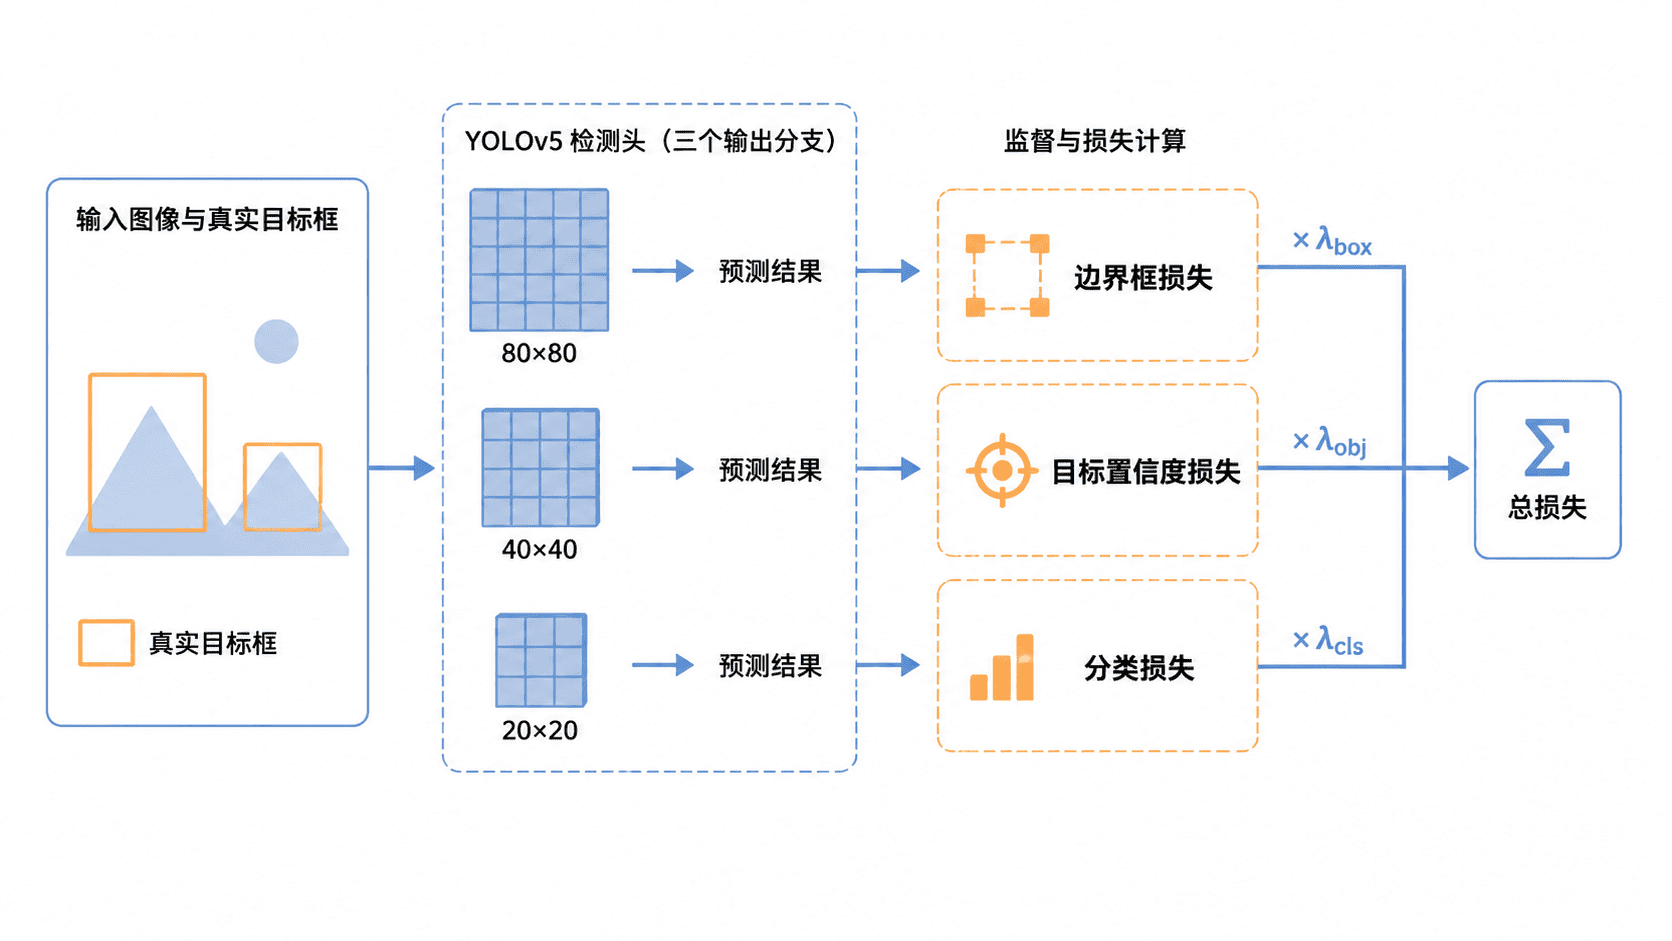
三项损失分别优化什么
边界框损失
边界框损失只作用于已经与真实目标匹配的正样本。YOLOv5 常用 CIoU 衡量预测框与真实框的差异,不只看重叠面积,还考虑中心点距离和宽高比,因此能推动预测框更快贴近目标。
目标置信度损失
目标置信度损失判断候选位置是否应该包含目标。正样本位置的目标值通常会结合框的 IoU 质量,负样本位置则趋近于 0。该项覆盖大量候选位置,是抑制背景误报的关键。
分类损失
分类损失只在正样本上比较类别预测与真实类别,通常使用带 Logits 的二元交叉熵。多类别任务需要它区分类别;单类别数据集没有类别竞争,YOLOv5 通常不会计算这一项。
权重与数值示例
下面的可运行示例只演示三项损失的加权关系,不复刻训练器内部的批次缩放。
def weighted_loss(box_loss: float, obj_loss: float, cls_loss: float) -> float:
    # 权重决定各项对总梯度的相对影响
    box_weight, obj_weight, cls_weight = 0.05, 1.0, 0.5
    return (
        box_weight * box_loss
        + obj_weight * obj_loss
        + cls_weight * cls_loss
    )

total = weighted_loss(box_loss=1.2, obj_loss=0.18, cls_loss=0.11)
print(f"{total:.3f}")
预期输出:
0.295不能只比较三项原始数值的大小,因为它们的样本数量、计算方式和权重不同。判断异常时,应看同一项在多个 epoch 中是否稳定下降,以及验证集指标是否同步改善。
训练时怎样读损失
box_loss 长期不降,常见原因是标注框错误、目标尺寸异常或样本匹配不足。obj_loss 很高且波动大,通常要检查背景比例、漏标和学习率。cls_loss 不降时,应先核对类别编号、names 顺序和类别分布。
损失下降并不等于模型一定可用。最终还要结合精确率、召回率和 mAP 判断:损失负责提供优化方向,评估指标负责回答模型在未见数据上是否真正有效。
本课总结
- 边界框损失负责定位,目标置信度损失负责区分前景与背景,分类损失负责区分类别
- 三项损失的计算对象和数值尺度不同,必须结合权重与变化趋势分析
- 训练损失需要与验证集指标一起判断,不能只看总损失是否下降
下一课预告
下一课将进入自定义训练配置,编写数据集 YAML 文件,把图像路径、验证集和类别名称接入 YOLOv5 训练入口。