
计算机视觉 / 系统课时
排查数据加载错误
排查数据加载错误
YOLOv5 数据加载错误常表现为找不到图片、标签数量异常、类别索引越界或训练过程中突然中断。本课建立一套从数据配置到单文件校验的排查流程,并提供可直接运行的检查脚本,帮助你在训练前发现问题。
学习目标
- 按配置、路径、图片、标签和类别映射的顺序定位错误
- 使用脚本批量发现缺失标签、损坏图片和非法标注
- 修复后验证数据集能够被训练程序完整扫描
从错误信息定位范围
先保留完整报错,不要只看最后一行。路径类错误通常包含 FileNotFoundError,图片损坏常出现读取失败或图像尺寸异常,标签问题则可能表现为类别索引超出 nc、坐标不在有效范围或标签列数错误。
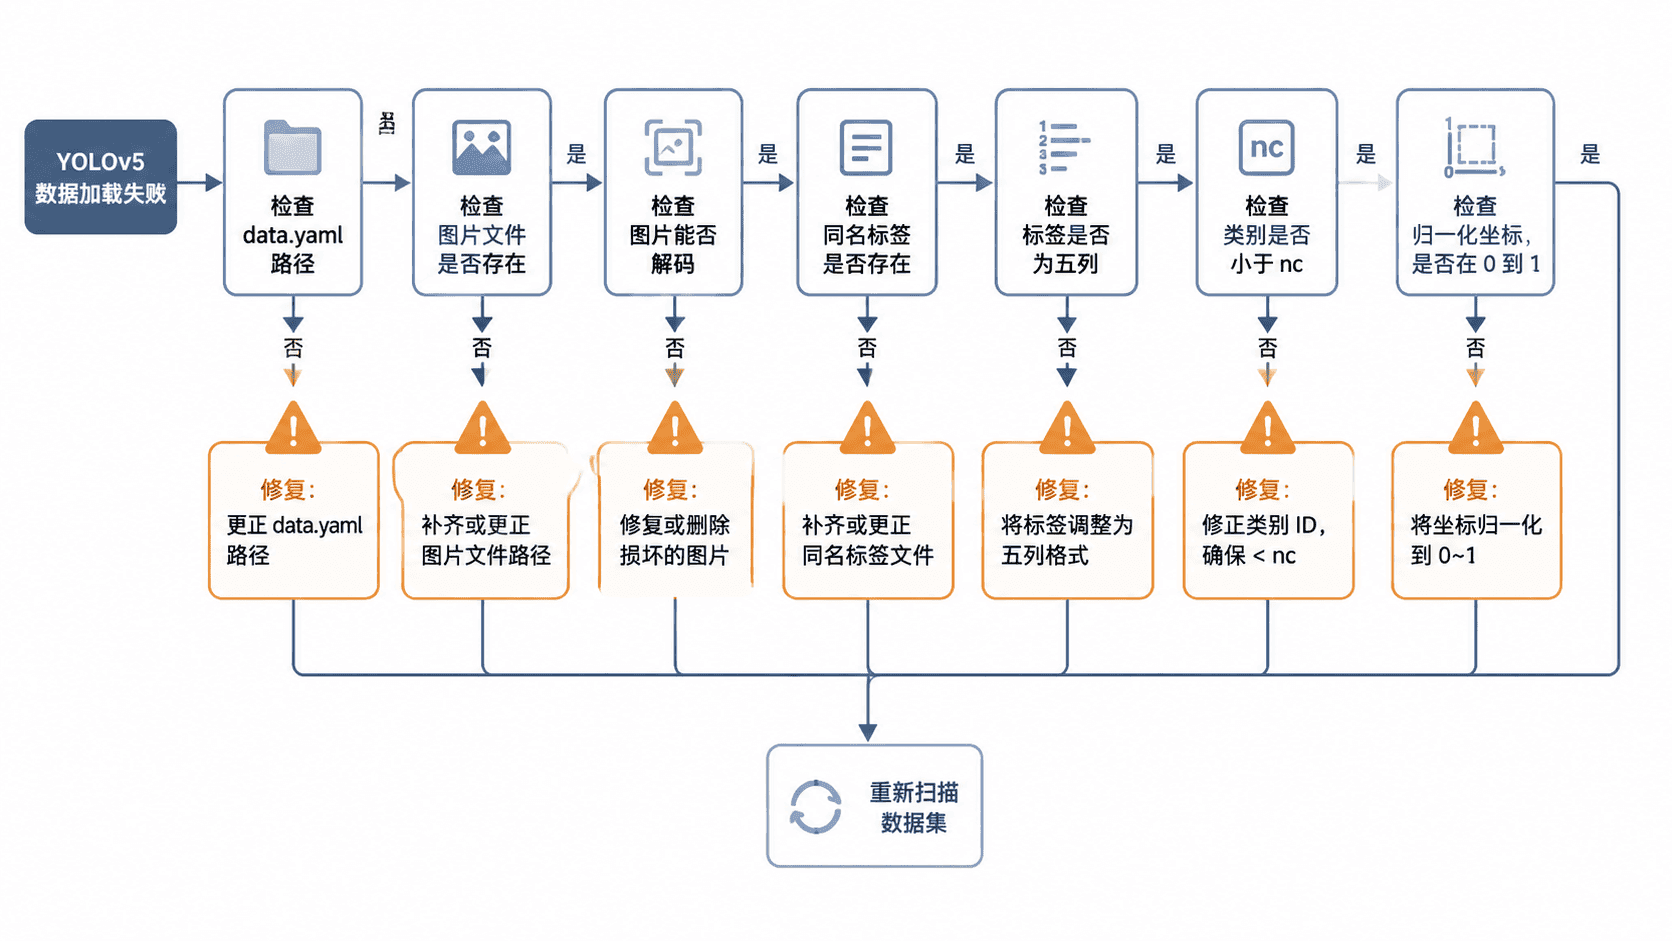
推荐按以下顺序排查:
data.yaml中的train、val和names是否正确。- 图片目录是否存在,路径是相对项目还是绝对路径。
- 每张图片是否能被正常解码。
- 标签文件是否与图片同名,内容是否符合 YOLO 格式。
- 类别编号是否位于
0到nc - 1。 - 中心点和宽高是否为归一化数值。
检查数据配置
一个最小数据配置如下:
path: /data/my_dataset
train: images/train
val: images/val
names:
  0: person
1: helmet生效行为与验证方法:train 和 val 会相对于 path 解析,标签目录通常由 images 对应到同级 labels。配置完成后,应确认 /data/my_dataset/images/train、/data/my_dataset/labels/train 等目录真实存在。
若使用 Windows 路径,建议使用正斜杠或加引号,避免反斜杠被错误解释。类别名称的数量必须与训练参数中的类别数一致,编号应从 0 连续开始。
批量检查图片与标签
下面的脚本会扫描训练集,检查图片是否损坏、标签是否缺失、每行是否为五列、类别是否越界,以及归一化坐标是否超出范围。将 dataset_root 和 num_classes 修改为实际值后运行。
from pathlib import Path
from PIL import Image

dataset_root = Path("/data/my_dataset")
image_dir = dataset_root / "images" / "train"
label_dir = dataset_root / "labels" / "train"
num_classes = 2
image_suffixes = {".jpg", ".jpeg", ".png", ".bmp"}

errors = []

for image_path in sorted(image_dir.rglob("*")):
    if image_path.suffix.lower() not in image_suffixes:
        continue

    relative_path = image_path.relative_to(image_dir)
    label_path = (label_dir / relative_path).with_suffix(".txt")

    try:
        with Image.open(image_path) as image:
            image.verify()
    except Exception as exc:
        errors.append(f"损坏图片: {image_path} -> {exc}")
        continue

    if not label_path.exists():
        errors.append(f"缺失标签: {label_path}")
        continue

    for line_number, line in enumerate(label_path.read_text(encoding="utf-8").splitlines(), start=1):
        parts = line.split()
        if len(parts) != 5:
            errors.append(f"标签列数错误: {label_path}:{line_number}")
            continue

        try:
            class_id = int(parts[0])
            x_center, y_center, width, height = map(float, parts[1:])
        except ValueError:
            errors.append(f"标签类型错误: {label_path}:{line_number}")
            continue

        if not 0 <= class_id < num_classes:
            errors.append(f"类别越界: {label_path}:{line_number} -> {class_id}")

        if not all(0.0 <= value <= 1.0 for value in (x_center, y_center, width, height)):
            errors.append(f"坐标越界: {label_path}:{line_number}")

if errors:
    print("\n".join(errors))
    print(f"共发现 {len(errors)} 个问题")
else:
    print("数据集检查通过")
预期输出
缺失标签: /data/my_dataset/labels/train/example.txt
类别越界: /data/my_dataset/labels/train/sample.txt:2 -> 3
共发现 2 个问题
当数据无异常时,预期输出为:
数据集检查通过路径、文件名和问题数量取决于实际数据。脚本只检查结构与基础数值,不判断框是否准确包围目标。
理解 YOLO 标签边界
每行标签格式为:
<class_id> <x_center> <y_center> <width> <height>这是片段格式说明,不可独立执行。后四个值通常按图片宽高归一化,应位于 0 到 1。class_id 必须是整数,并满足:
空标签文件可以表示图片中没有目标,不一定是错误;完全缺失标签文件则要根据训练策略判断。为了减少歧义,建议为负样本保留同名空标签文件。
修复后重新验证
删除或修正问题文件后,再次运行检查脚本,直到输出“数据集检查通过”。随后使用 YOLOv5 的训练命令做一次短周期验证:
python train.py --img 640 --batch 2 --epochs 1 --data /data/my_dataset/data.yaml --weights yolov5s.pt预期结果
train: Scanning <PATH>/labels/train...
val: Scanning <PATH>/labels/val...
1 epochs completed in <TIME>
实际日志、耗时和缓存路径会不同。若扫描阶段仍失败,应根据日志中的首个异常文件回到前面的检查步骤,而不是直接增大 batch 或修改模型参数。
常见误区
图片与标签数量不完全相等不一定错误,因为负样本可能没有目标;真正要确认的是训练框架对缺失标签的处理方式是否符合预期。
类别越界不能通过简单增大 nc 掩盖。应先确认标签编号与 names 的映射是否一致,否则模型会学习到错误类别。
损坏图片即使能被文件管理器预览,也可能包含截断数据。应使用图像库完整解码验证,并重新导出异常文件。
本课总结
- 数据加载应按配置、路径、图片、标签和类别映射逐层排查
- 批量检查脚本能在训练前发现大多数结构性错误
- 修复完成后应进行一次短周期训练,确认扫描和加载流程真正通过
下一课预告
下一课将继续处理训练过程中出现的显存不足、损失异常和训练中断问题。