
计算机视觉 / 系统课时
主干网络提取特征
主干网络提取特征
本课解决“输入图像怎样变成可供检测头使用的特征”这一问题。你将沿着 YOLOv5 Backbone 的计算路径,观察分辨率逐步降低、通道数逐步增加的过程,并用可运行代码验证不同层级特征的形状变化。
学习目标
- 理解 Backbone 从边缘、纹理到高层语义的逐层提取过程
- 看懂下采样、通道扩展与 C3、SPPF 模块的主要作用
- 能根据特征图尺寸判断某一层更适合表达哪类信息
Backbone 的输入与输出
Backbone 可以理解为检测模型的“视觉编码器”。输入通常是形状为 [批量, 3, 高, 宽] 的图像张量,输出不是类别或边界框,而是多组经过编码的特征图。后续 Neck 会继续融合这些特征,检测头再据此预测目标。
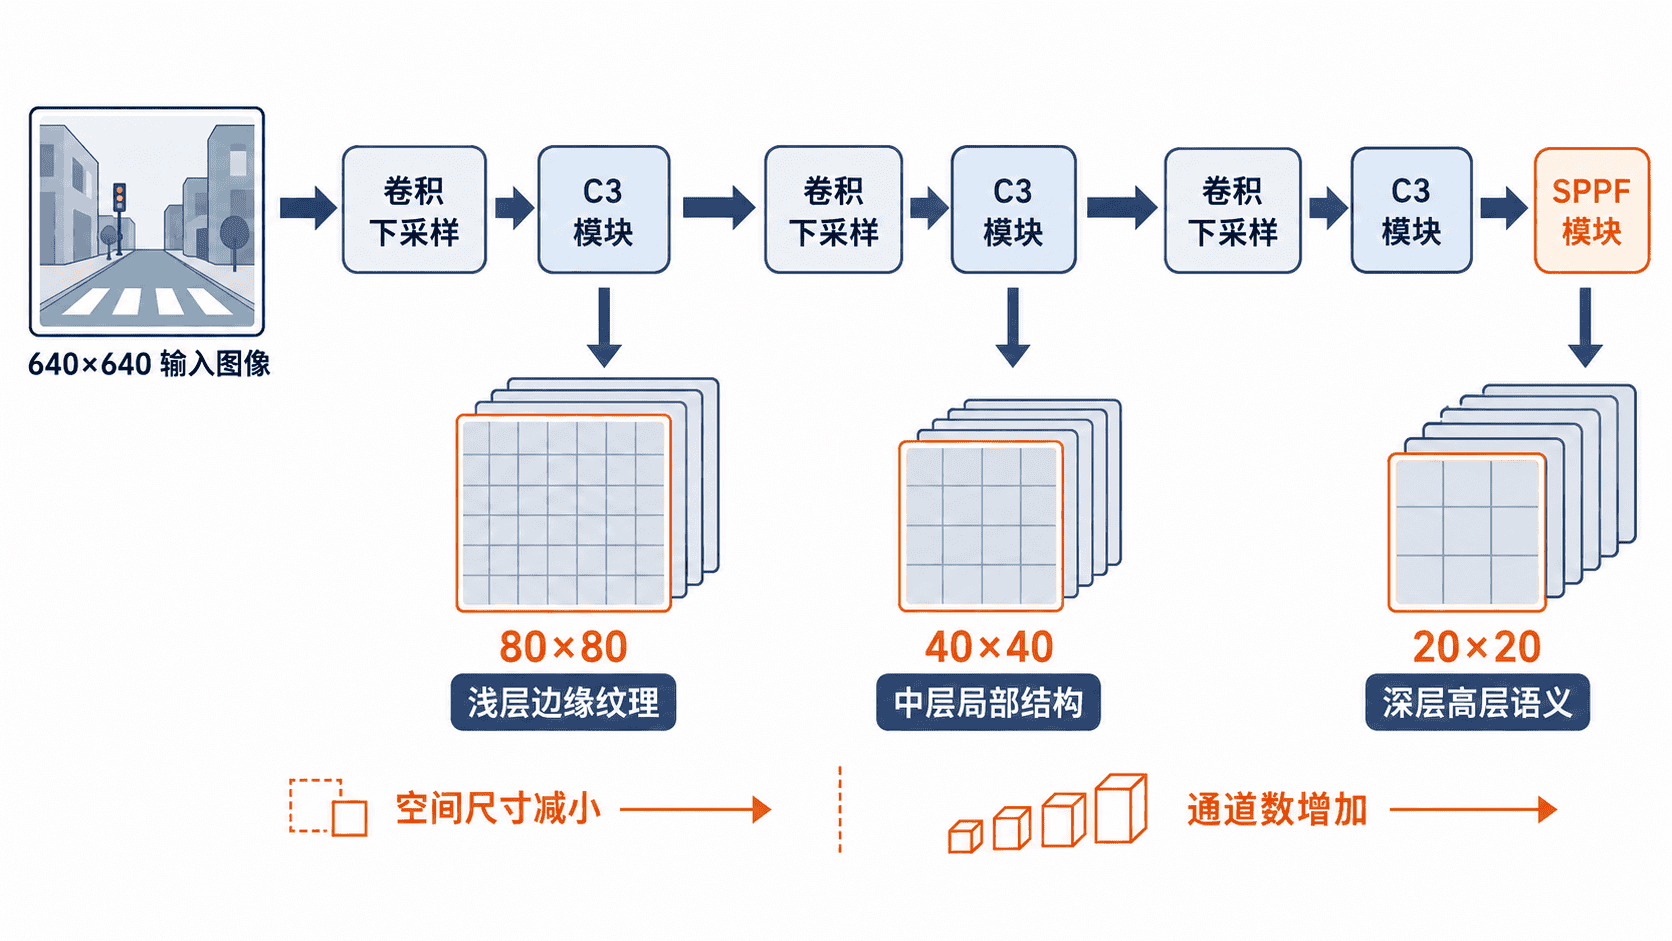
以 640×640 输入为例,特征图经过多次步长为 2 的卷积后,空间尺寸通常依次变为 320×320、160×160、80×80、40×40 和 20×20。空间越小,单个位置覆盖的原图区域越大,语义更强,但精细位置信息也更少。
下采样为什么能扩大感受野
卷积层使用步长 2 时,会在提取局部模式的同时缩小特征图。连续下采样使深层神经元能够综合更大范围的像素,因此更容易识别“车辆”“行人”这类完整对象,而不仅是单条边缘。
通道数通常随深度增加,用来容纳更多特征类型。例如浅层通道可能响应水平边缘、颜色变化和角点,深层通道则组合出车轮、人体轮廓或目标整体结构。分辨率降低和通道增加是一种计算量与表达能力之间的平衡。
C3 与 SPPF 的作用
YOLOv5 Backbone 中常见的 C3 模块会把输入分成不同分支,其中一部分经过瓶颈结构,另一部分保留较直接的信息路径,最后再拼接。这样既能增强特征提取能力,也能让梯度传播更稳定。
SPPF 位于主干网络较深位置。它通过连续的最大池化,以较低计算成本聚合不同范围的上下文,让同一位置同时看到局部和更大区域的信息。它不会直接生成检测结果,而是为后续多尺度融合提供语义更充分的深层特征。
用代码观察尺寸变化
下面的程序不是 YOLOv5 源码复刻,而是一个可独立运行的最小示例,用卷积下采样模拟 Backbone 的尺寸变化。重点是观察空间尺寸和通道数如何沿网络深度变化。
import torch
from torch import nn

class MiniBackbone(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        # 每个卷积块都使用 stride=2,将高宽缩小一半。
        self.stages = nn.ModuleList(
            [
                nn.Conv2d(3, 32, kernel_size=3, stride=2, padding=1),
                nn.Conv2d(32, 64, kernel_size=3, stride=2, padding=1),
                nn.Conv2d(64, 128, kernel_size=3, stride=2, padding=1),
                nn.Conv2d(128, 256, kernel_size=3, stride=2, padding=1),
                nn.Conv2d(256, 512, kernel_size=3, stride=2, padding=1),
            ]
        )
        self.activation = nn.SiLU()

    def forward(self, x: torch.Tensor) -> list[torch.Tensor]:
        outputs = []
        for stage in self.stages:
            x = self.activation(stage(x))
            outputs.append(x)
        return outputs

def main() -> None:
    model = MiniBackbone()
    image = torch.randn(1, 3, 640, 640)

    for index, feature in enumerate(model(image), start=1):
        print(f"stage{index}: {tuple(feature.shape)}")

if __name__ == "__main__":
    main()
预期输出:
stage1: (1, 32, 320, 320)
stage2: (1, 64, 160, 160)
stage3: (1, 128, 80, 80)
stage4: (1, 256, 40, 40)
stage5: (1, 512, 20, 20)
实际 YOLOv5 的通道数会随模型规模配置变化,但高宽按步长逐级缩小的规律一致。检测通常会重点使用 80×80、40×40 和 20×20 三个层级,分别保留不同程度的细节与语义。
如何理解不同层级特征
80×80 特征图位置密集,能保留更多边缘和局部结构,适合为小目标提供定位线索。40×40 在细节与语义之间较平衡,常用于中等目标。20×20 的感受野更大,单个位置能概括较大区域,更适合表达大目标和整体语义。
不要把“浅层只检测小目标、深层只检测大目标”理解成绝对规则。最终预测依赖 Neck 的跨层融合,浅层也会接收深层语义,深层同样会结合其他尺度信息。
本课总结
- Backbone 通过连续卷积和下采样,把原始像素转换为多层特征图
- 浅层保留空间细节,深层拥有更大感受野和更强语义
- C3 强化特征提取与梯度传播,SPPF 聚合多范围上下文
下一课预告
下一课将进入 Neck,观察它如何把深层语义传回高分辨率特征,并融合多个尺度以同时服务小、中、大目标检测。