
计算机视觉 / 系统课时
排查显存不足
排查显存不足
训练出现 CUDA out of memory 时,真正目标不是盲目清缓存,而是先确认显存被谁占用,再按影响最小的顺序降低单批次计算量,最后用短训练验证配置稳定可复现。
学习目标
- 判断显存不足发生在训练、验证还是其他进程占用阶段
- 按批量大小、输入尺寸和模型规模的顺序降低显存压力
- 用一次短训练确认修复有效且不会立即复发
先确认是不是显存不足
典型报错包含 CUDA out of memory、Tried to allocate 和当前已分配、保留的显存信息。若错误是驱动版本不匹配、CUDA 不可用或进程被系统杀死,就不能按显存不足处理。
先查看 GPU 上是否还有其他训练、推理或桌面进程。下面的命令只读取状态,不会结束进程。
nvidia-smi --query-compute-apps=pid,process_name,used_memory --format=csv预期输出
pid, process_name, used_gpu_memory [MiB]
<ID>, python, <MEMORY> MiB
<ID> 和 <MEMORY> 会随环境变化。若存在不属于当前任务的高占用进程,应先正常停止它;不要直接删除缓存文件,也不要在不清楚进程归属时强制结束。
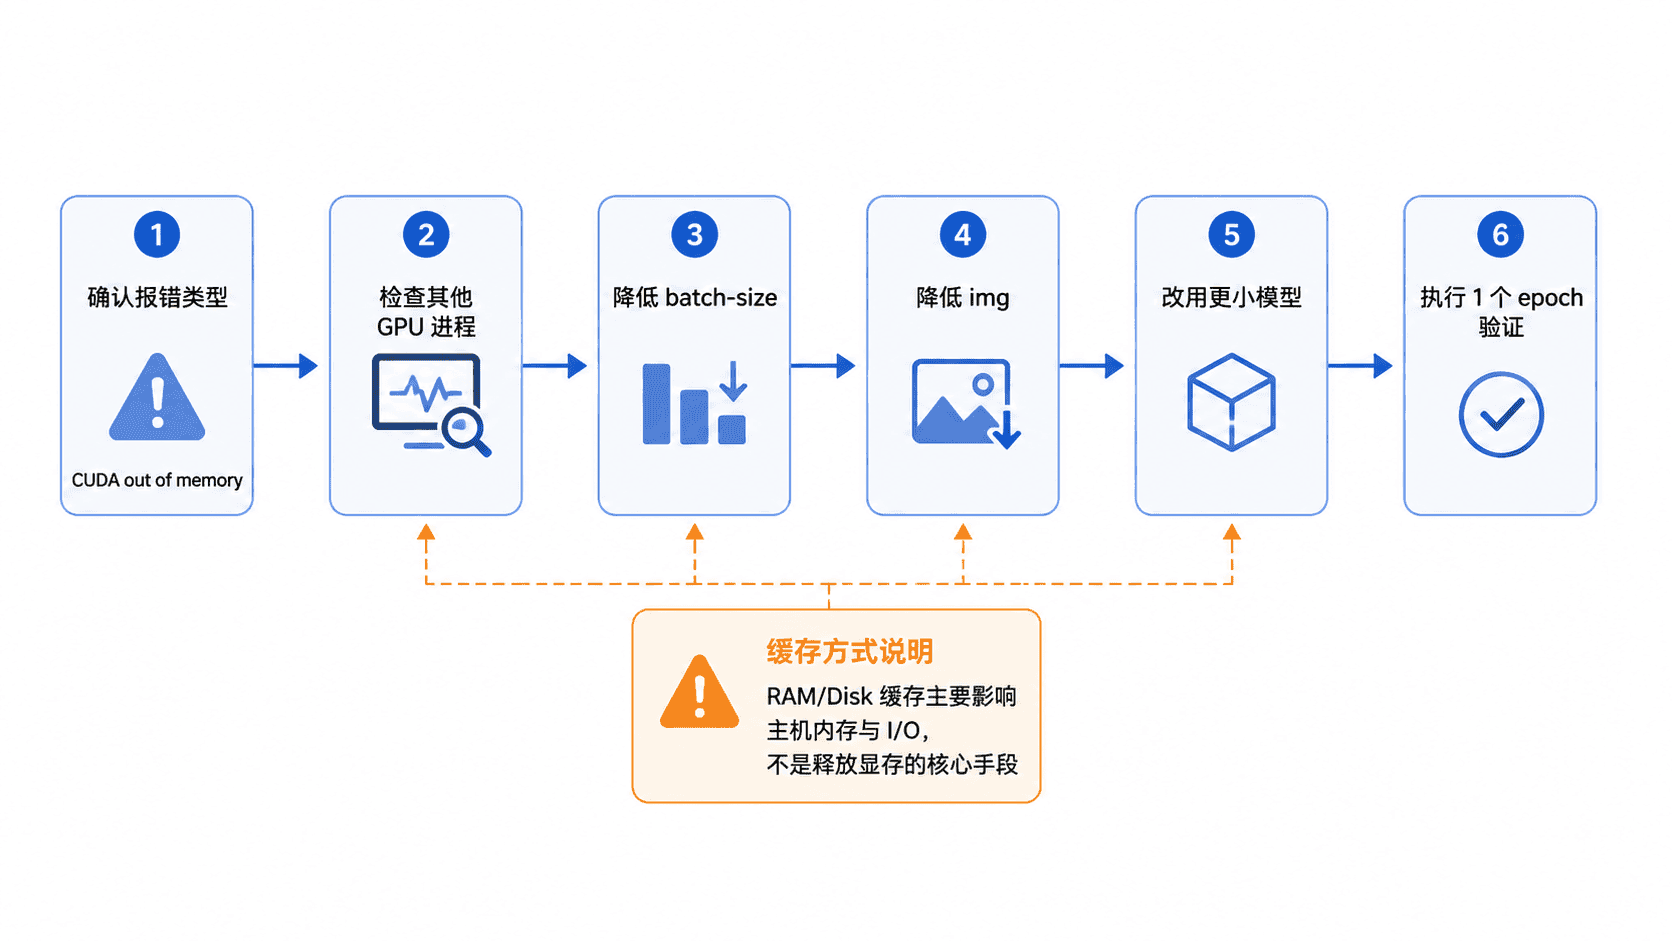
按影响最小的顺序调整
第一步只降低 --batch-size。它通常是最有效且对输入信息损失最小的手段,例如从 16 依次降到 8、4、2。批量变小后,梯度噪声会增加,但 YOLOv5 的训练逻辑通常会通过梯度累积减轻有效批量变化带来的影响。
第二步再降低 --img,例如从 640 调到 512 或 416。显存占用会明显下降,但小目标可见细节也会减少,因此不能只看“能跑”,还要重新比较验证集指标。
第三步改用更小的模型,例如从 yolov5m.pt 改为 yolov5s.pt 或 yolov5n.pt。模型越小,显存和计算量越低,但容量也更有限,适合先建立可训练基线。
--cache ram 主要占用系统内存,不会把训练图像长期放进显存。主机内存紧张时可改为磁盘缓存或关闭缓存,避免系统换页、进程被杀死等连锁问题,但它不是解决 GPU OOM 的首选开关。
用短训练验证修复
下面以较保守的配置运行 1 个 epoch。请在 YOLOv5 项目根目录执行,并将数据集配置路径替换为自己的文件。
python train.py --img 512 --batch-size 4 --epochs 1 --data data/custom.yaml --weights yolov5s.pt --workers 2预期结果
train: Scanning <PATH>...
Starting training for 1 epochs...
1 epochs completed in <TIME>.
Results saved to runs/train/<PATH>
实际路径和耗时可能不同。只要训练与验证阶段都完成、没有再次出现 OOM,并且结果目录生成本轮日志,就说明当前配置至少能够稳定启动。
仍然溢出时怎么定位
如果在训练开始前就溢出,优先检查其他进程、模型加载和自定义代码是否把额外张量放到了 GPU。若只在验证阶段溢出,应检查验证批量、推理增强和结果保存逻辑。
如果显存看似足够却频繁溢出,可能是自定义循环保存了带计算图的张量,或把每个 batch 的预测结果累积在 GPU 列表中。此时应在保存前使用 detach() 并转到 CPU,同时避免持有不再需要的中间变量。
不要把“每轮调用清缓存”当作长期方案。缓存分配器保留显存是为了复用,频繁清理通常只会降低速度;真正的修复应减少峰值张量或缩小单批次工作量。
本课总结
- 先确认报错与 GPU 占用,再处理无关进程,避免把驱动或系统内存问题误判为显存不足
- 降低批量大小是首选,其次才是输入尺寸和模型规模
- 修复后必须完成一次包含训练与验证的短运行,确认 OOM 不再出现
下一课预告
下一课将排查损失不下降、指标为零、训练发散和验证波动,建立从数据到超参数的固定定位顺序。