
计算机视觉 / 系统课时
检测头输出解析
检测头输出解析
本课解决一个核心问题:YOLOv5 检测头输出的张量到底表示什么。你将从形状、字段含义和解码流程三个层面读懂预测结果,并能用一段可运行代码检查单个预测向量。
学习目标
- 读懂检测头输出张量的维度与各字段含义
- 区分边界框参数、目标置信度和类别概率
- 理解从原始输出到最终检测框的基本处理顺序
输出张量长什么样
YOLOv5 通常在三个尺度上进行预测。每个尺度对应一张不同大小的特征图,每个网格位置又会基于若干锚框产生预测。对单个尺度而言,输出可整理为 [batch, anchors, height, width, 5 + classes]。
最后一维中的前 5 个值依次表示边界框中心位置、宽高和目标置信度,后面的 classes 个值表示各类别的预测分数。以 80 类数据集为例,单个预测向量共有 5 + 80 = 85 个数。
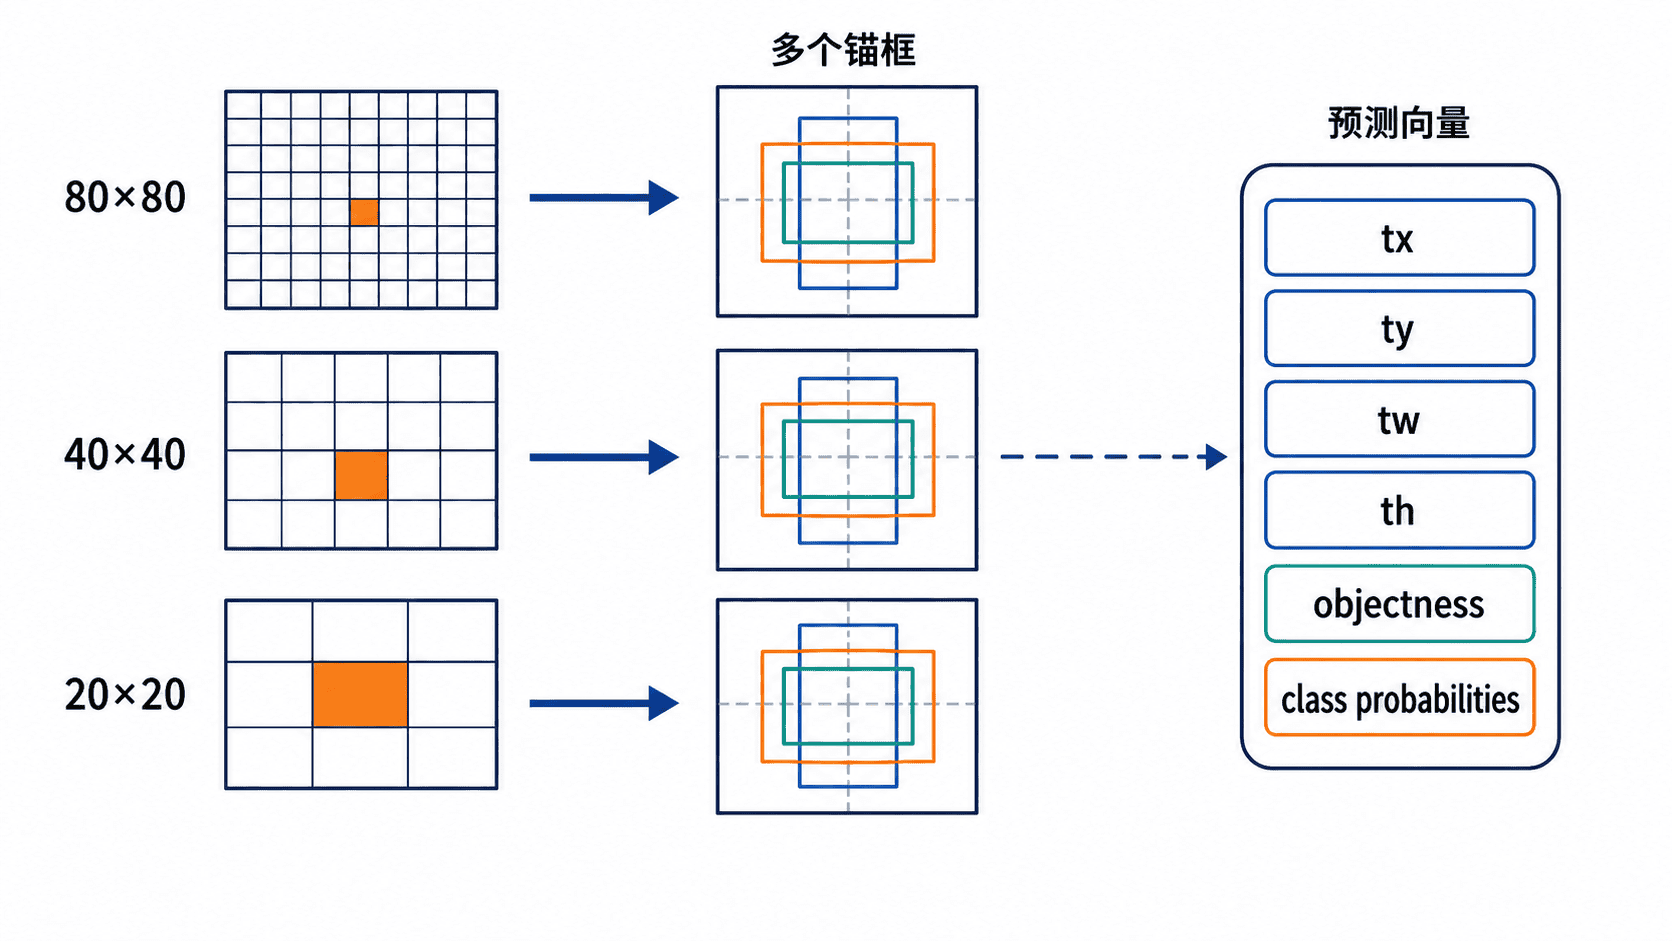
三个尺度分别更擅长处理不同大小的目标:高分辨率特征图保留更多位置细节,适合小目标;低分辨率特征图感受野更大,适合较大目标。最终推理时,三个尺度的预测会被合并后统一筛选。
单个预测向量的字段
原始输出中的边界框通常不是最终像素坐标,而是相对当前网格和锚框的偏移量。YOLOv5 会先对这些值应用激活函数,再结合网格坐标、步长和锚框尺寸完成解码。
目标置信度表示当前位置存在目标的可能性;类别概率表示在“存在目标”的条件下属于各类别的可能性。实际筛选时,常用的类别置信度为:
因此,一个框即使类别概率较高,只要目标置信度很低,最终得分仍可能不足以通过阈值。
用代码检查预测向量
下面的示例模拟一个包含 3 个类别的预测向量,并计算最高类别及其最终置信度。这里直接使用已经过 Sigmoid 的概率值,便于聚焦字段含义。
def parse_prediction(prediction, class_names):
    if len(prediction) != 5 + len(class_names):
        raise ValueError("预测向量长度与类别数量不匹配")

    center_x, center_y, width, height, objectness = prediction[:5]
    class_probabilities = prediction[5:]

    best_index = max(
        range(len(class_probabilities)),
        key=class_probabilities.__getitem__,
    )
    final_score = objectness * class_probabilities[best_index]

    return {
        "box": [center_x, center_y, width, height],
        "class_name": class_names[best_index],
        "objectness": round(objectness, 4),
        "class_probability": round(class_probabilities[best_index], 4),
        "final_score": round(final_score, 4),
    }


if __name__ == "__main__":
    classes = ["person", "car", "dog"]
    prediction = [0.52, 0.47, 0.30, 0.24, 0.90, 0.10, 0.80, 0.10]
    print(parse_prediction(prediction, classes))
预期输出
{'box': [0.52, 0.47, 0.3, 0.24], 'class_name': 'car', 'objectness': 0.9, 'class_probability': 0.8, 'final_score': 0.72}示例中的边界框仍是归一化或中间表示,实际模型还需结合网格位置、锚框和输入尺寸还原为图像坐标。动态输入尺寸或不同模型配置会改变特征图大小,但不会改变字段的基本语义。
从输出到最终检测结果
模型原始输出不能直接作为最终结果。通常要先解码边界框,再计算类别置信度,接着删除低分框,最后使用非极大值抑制去除同一目标周围的重复框。
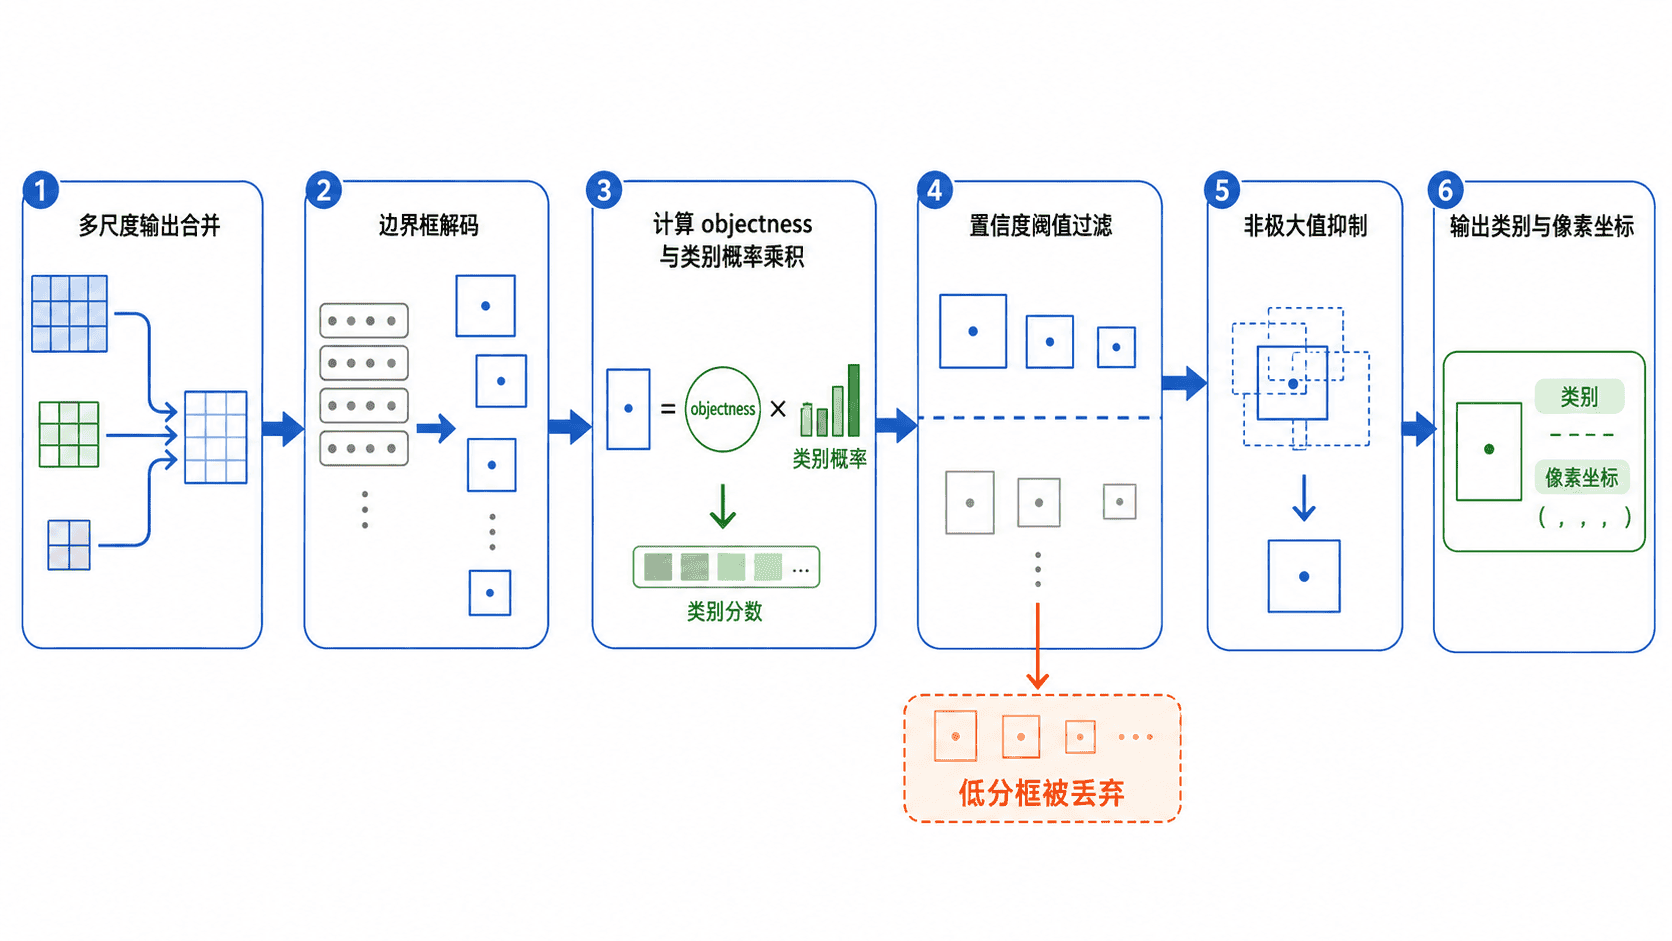
需要特别注意:目标置信度不是最终类别得分,类别概率也不能单独决定是否保留预测框。只有把位置解码、分数计算和重复框抑制连起来,才能得到可用于绘制或业务判断的检测结果。
本课总结
- 检测头最后一维由 4 个框参数、1 个目标置信度和若干类别概率组成
- 最终类别得分通常由目标置信度与对应类别概率相乘得到
- 原始输出必须经过解码、阈值过滤和非极大值抑制才能形成最终结果
下一课预告
下一课将学习锚框如何描述目标尺寸,以及训练阶段如何把真实目标分配给合适的尺度、网格和锚框。