
计算机视觉 / 系统课时
调整批量大小
调整批量大小
批量大小决定一次参数更新要同时处理多少张图像。本课将用一次短训练测出显存可承受范围,并给出兼顾吞吐、梯度稳定性和训练余量的选择方法,让你能为当前设备确定可复现的批量大小。
学习目标
- 说明批量大小对显存、速度和梯度波动的影响
- 用短训练定位当前设备可稳定运行的批量大小
- 在批量大小变化后同步检查学习率和训练曲线
批量大小改变了什么
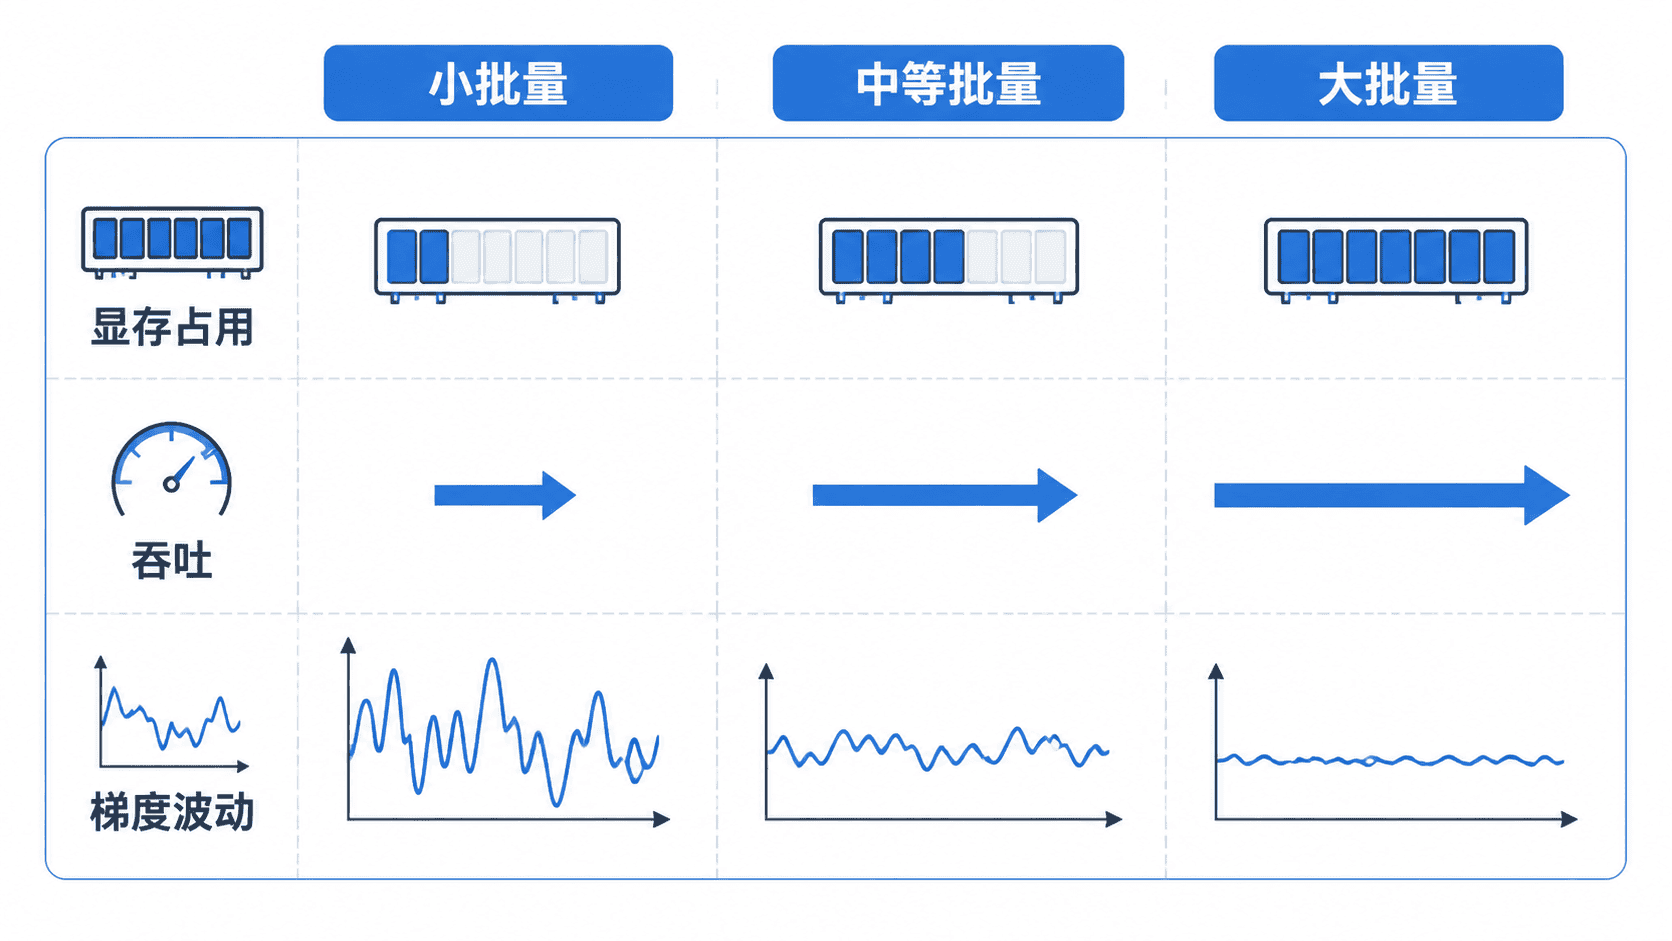
批量大小记为 ,表示每次反向传播前参与损失计算的样本数量。 增大时,激活值和梯度需要占用更多显存,单次迭代通常更慢,但每秒处理的图像数可能提高; 减小时,显存压力下降,梯度波动通常更明显。
多卡或梯度累积场景还要关注有效批量大小:
它决定一次优化器更新实际汇总了多少样本。比较两组实验时,只看单卡参数而忽略 GPU 数量或累积次数,会得到错误结论。
用短训练测出显存上限
先固定图像尺寸、模型权重和数据集,只改变批量大小。下面用 1 个 epoch 做冒烟测试,目的是确认能否完成前向、反向和验证流程,而不是评估最终精度。
python train.py --img 640 --batch-size 16 --epochs 1 --data data/custom.yaml --weights yolov5s.pt --name batch16-smoke预期输出
<YOLOv5 环境与模型摘要>
Starting training for 1 epochs...
<第 1 个 epoch 的训练与验证指标>
1 epochs completed in <TIME>.
Results saved to runs/train/batch16-smoke
实际日志内容会随 YOLOv5 版本和设备变化。若出现 CUDA out of memory,先把 --batch-size 16 改为 8;若训练稳定且显存余量明显,再尝试 24 或 32。每次只改一个变量,才能判断变化来自批量大小。
选择最大稳定值而不是占满显存
训练过程中还会发生验证、数据增强和临时张量分配,显存峰值不一定出现在第一批数据。合适的批量大小应能连续完成多个 epoch,并保留约 10%~20% 的显存余量,而不是刚好让首次迭代通过。
| 现象 | 调整建议 | 原因 |
|---|---|---|
| 首次反向传播就显存不足 | 批量大小减半 | 快速回到可运行区间 |
| 能运行但显存长期接近满载 | 小幅下调 | 为验证和峰值分配留余量 |
| 显存余量较大且 GPU 利用率偏低 | 小幅上调后重测 | 可能提高数据吞吐 |
| 速度提高但验证指标变差 | 回退并检查学习率 | 大批量可能改变优化行为 |
不要只用“每个 epoch 更快”判断优劣。批量增大后,每个 epoch 的参数更新次数会减少,最终收敛速度和泛化效果仍需结合损失曲线与验证指标判断。
批量变化后的联动检查
批量大小明显变化后,至少观察前 10~20 个 epoch 的 box_loss、obj_loss、cls_loss 和验证集 mAP。小批量若出现剧烈波动,可以适当降低初始学习率;大批量若收敛过慢,可以把线性缩放规则作为起点,但必须重新验证。
若仓库支持自动批量探测,可查看 python train.py --help 中是否存在 --batch-size -1。自动结果仍只是显存估算值,正式训练前应再运行短训练,并确认验证阶段不会溢出。
本课总结
- 批量大小同时影响显存占用、吞吐、参数更新次数和梯度波动
- 实际选择应以“连续稳定运行并保留显存余量”为准
- 批量大小发生明显变化后,必须重新检查学习率与验证曲线
下一课预告
下一课将根据损失曲线调整初始学习率和衰减策略,并用小范围对照实验判断学习率是过高、过低还是合适。