
计算机视觉 / 系统课时
模型轻量化策略
模型轻量化策略
本课将比较模型裁剪、量化和知识蒸馏三类轻量化方法,帮助你根据部署瓶颈选择正确方案。完成后,你能区分“参数更少”“数值位宽更低”和“学生模型更强”三种目标,并避开体积下降却没有实际加速的常见误区。
学习目标
- 区分裁剪、量化和知识蒸馏解决的主要问题
- 根据硬件、延迟、模型体积与精度要求选择策略
- 建立轻量化后的微调、导出和回归验证流程
三类方法的本质差异
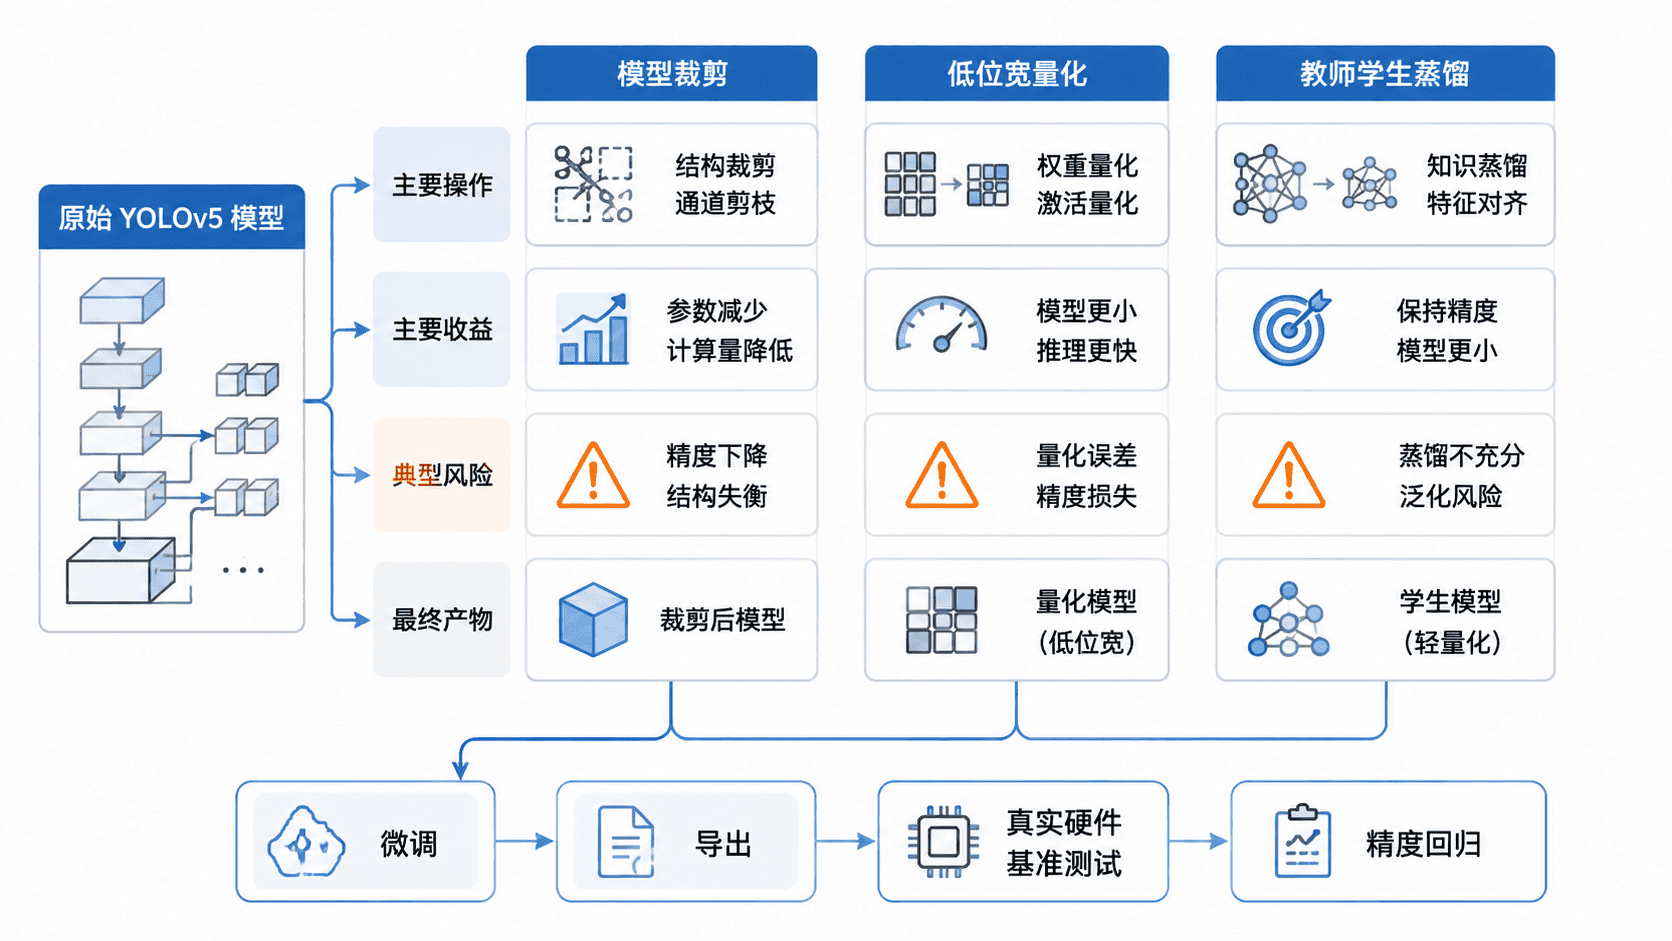
裁剪删除不重要的权重、通道或网络层,目标是减少冗余计算。量化把 FP32 权重和激活转换为 FP16、INT8 等低位宽表示,目标是降低计算与存储成本。知识蒸馏让小模型学习大模型的软标签、特征或中间表示,目标是在更小结构上尽量保留精度。
| 策略 | 主要收益 | 主要风险 | 更适合的场景 |
|---|---|---|---|
| 结构化裁剪 | 降低通道数与 FLOPs,容易形成真实加速 | 需要重建网络并微调,裁剪过度会损失召回率 | 延迟和算力受限 |
| 非结构化裁剪 | 快速制造稀疏权重,便于研究冗余 | 普通 GPU 内核未必利用稀疏性 | 支持稀疏计算的专用后端 |
| FP16/INT8 量化 | 减小模型与显存占用,提高吞吐 | INT8 对校准数据和算子支持敏感 | TensorRT、边缘 GPU、推理服务器 |
| 知识蒸馏 | 小模型在相同规模下获得更高精度 | 训练流程更复杂,教师偏差会传递 | 已有高精度教师模型 |
裁剪:先确认能否变成真实加速
下面的可运行示例对两个卷积层执行 30% 的非结构化 L1 裁剪,并统计卷积权重稀疏率。它能说明“权重被置零”,但不会自动缩短普通稠密卷积的执行时间。
import torch
import torch.nn as nn
import torch.nn.utils.prune as prune

model = nn.Sequential(
    nn.Conv2d(3, 8, kernel_size=3),
    nn.ReLU(),
    nn.Conv2d(8, 16, kernel_size=3),
)

for module in model.modules():
    if isinstance(module, nn.Conv2d):
        # 按权重绝对值裁剪,并移除重参数化钩子以保存普通权重
        prune.l1_unstructured(module, name="weight", amount=0.30)
        prune.remove(module, "weight")

conv_weights = [
    module.weight
    for module in model.modules()
    if isinstance(module, nn.Conv2d)
]
total = sum(weight.numel() for weight in conv_weights)
zeros = sum((weight == 0).sum().item() for weight in conv_weights)

print(f"weight_sparsity={zeros / total:.2%}")
预期输出
weight_sparsity=30.04%要获得通用硬件上的真实加速,通常应采用结构化通道裁剪:删除完整输出通道,并同步修改后续卷积、BatchNorm 与检测头的输入维度。YOLOv5 存在跨层连接和特征融合,不能只删除某一层张量而不更新依赖关系。裁剪后必须用原训练集微调,并重新导出后端模型。
量化:优先从 FP16,再评估 INT8
FP16 通常是风险最低的第一步,尤其适合 TensorRT 和支持半精度的 NVIDIA GPU。它不需要校准集,精度变化通常较小,但模型体积和延迟收益仍取决于算子是否真正使用 FP16 内核。
INT8 的压缩和吞吐收益更大,但需要代表性校准数据覆盖真实亮度、目标尺寸、背景和类别分布。训练后量化适合快速验证;若小目标、低置信度类别或边界框回归明显退化,再考虑量化感知训练。验证时不能只看总体 mAP,还要检查各类别 AP、召回率和不同目标尺度。
蒸馏:让小模型学习大模型
知识蒸馏通常以较大的 YOLOv5 模型作为教师,以较小模型作为学生。训练损失可由真实标签损失、教师分类分布、目标置信度和中间特征对齐共同组成。教师模型只参与训练,不进入最终部署,因此部署成本仍由学生模型决定。
蒸馏适合“直接换小模型会掉点,但部署必须保持小模型结构”的场景。教师必须先在目标数据上达到稳定精度,否则学生会继承错误。蒸馏温度、损失权重和特征对齐层需要通过验证集调节,不能简单复制其他数据集的参数。
推荐实施顺序
先测量真实瓶颈:模型文件过大优先量化,GPU 延迟过高优先 TensorRT FP16 或结构化裁剪,换成小模型后精度不足再加入蒸馏。不要同时一次性叠加三种方法,否则出现精度下降时难以定位原因。
每完成一种优化,都执行“训练或微调、导出、真实硬件基准、精度回归”闭环。只有当延迟、吞吐、峰值显存、模型体积和关键类别精度同时满足验收线时,轻量化才算成功。
本课总结
- 裁剪改变网络冗余,量化改变数值位宽,蒸馏改变小模型的学习方式
- 稀疏率、参数量和文件大小都不能代替真实硬件上的延迟测试
- 轻量化应逐项实施,并在每一步完成微调、导出与精度回归
下一课预告
下一阶段可以把 TensorRT 与轻量化结果组合到实际部署流程中,建立固定输入、批量策略和性能验收基线。