
计算机视觉 / 系统课时
使用 TensorRT 加速
使用 TensorRT 加速
本课将把训练得到的 YOLOv5 权重导出为 TensorRT 引擎,并说明 FP16 加速真正生效的前提、验证方法与常见限制。完成后,你能得到可直接用于 NVIDIA GPU 推理的 .engine 文件,并用同一输入尺寸比较加速前后的延迟。
学习目标
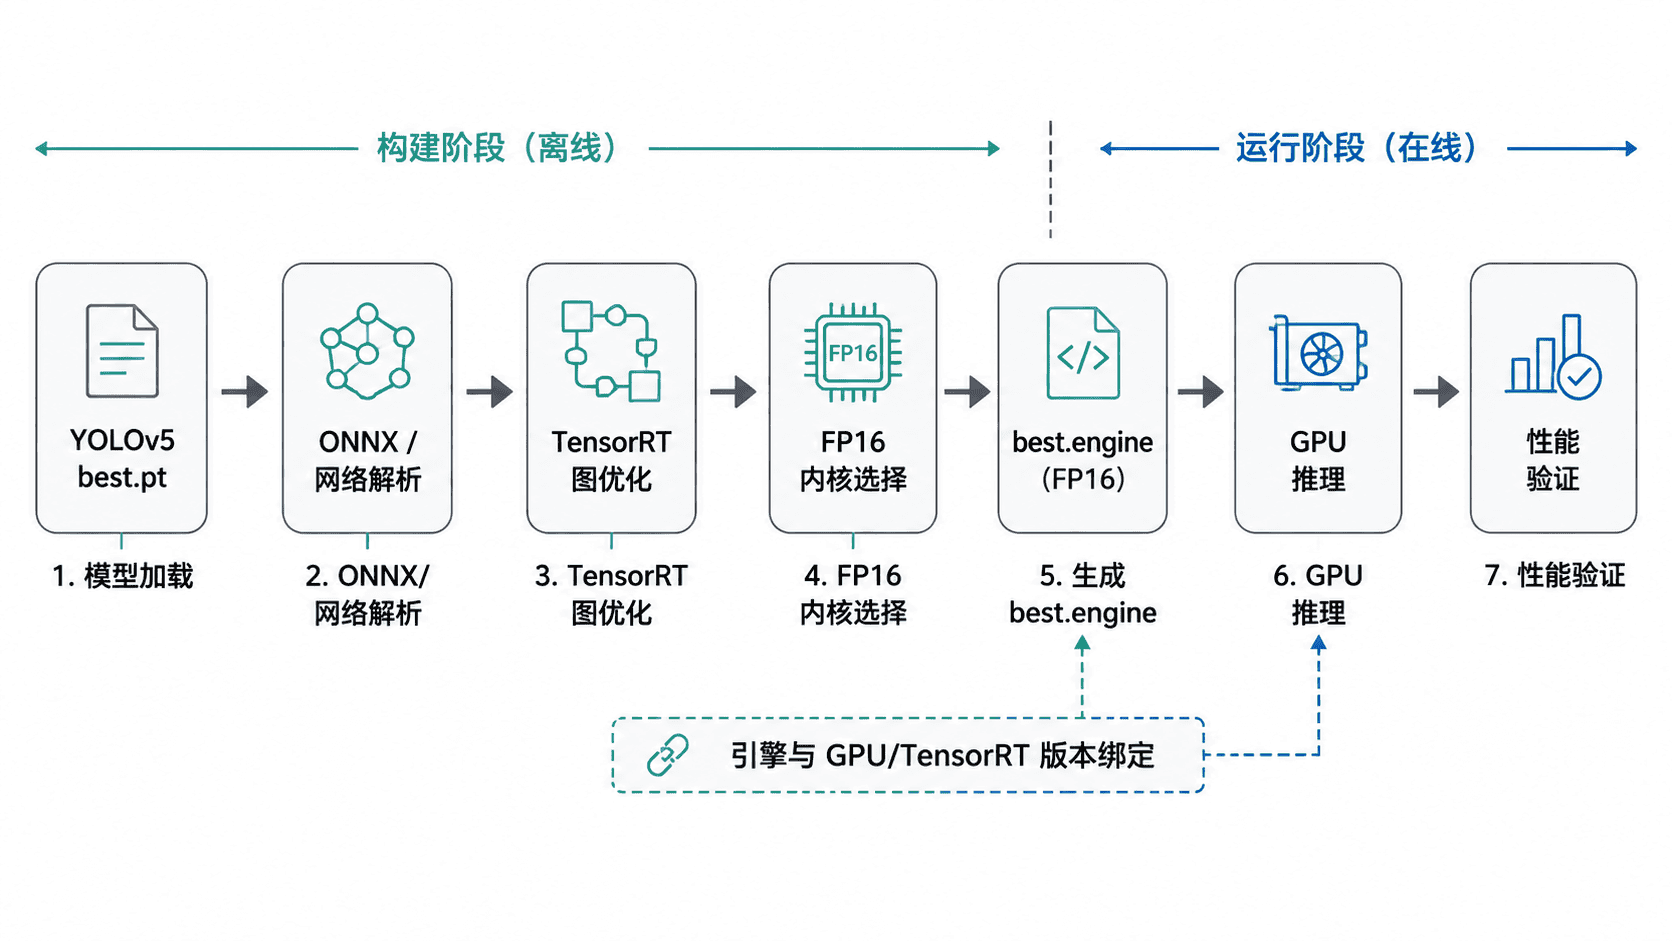
- 说清楚 PyTorch 权重到 TensorRT 引擎的构建链路
- 使用 YOLOv5 导出脚本生成 FP16 TensorRT 引擎
- 判断 FP16 是否适合当前显卡、输入尺寸与部署环境
TensorRT 为什么能加速
TensorRT 会在导出阶段解析网络,执行算子融合、常量折叠、内存复用和精度选择,再针对指定 GPU 生成优化后的执行计划。运行时不再经过完整的 PyTorch 调度链路,因此通常能降低延迟并提高吞吐量。
FP16 的核心收益是减少计算与显存带宽压力。只有 GPU 具备较好的半精度计算能力、模型算子可被 TensorRT 高效支持,并且推理批量与输入尺寸稳定时,收益才明显。小模型、低端显卡或频繁变化的动态尺寸,可能让构建成本和数据搬运开销抵消加速效果。
导出前置条件
导出必须在带 NVIDIA GPU 的环境中执行,并确保 CUDA、PyTorch、TensorRT 与显卡驱动彼此兼容。先进入 YOLOv5 项目目录,安装项目依赖,再确认 python -c "import tensorrt" 能成功导入。
FP16 还要求使用 GPU 构建引擎,不能在 CPU 上通过 --half 获得实际半精度加速。部署机器最好与构建机器使用相同 GPU 型号或至少相同计算能力;TensorRT 引擎通常不能跨显卡架构、TensorRT 主版本或 CUDA 环境直接复用。
构建 FP16 引擎
下面命令使用 YOLOv5 自带的 export.py,将训练权重直接导出为 TensorRT 引擎。命令以单张、固定 640×640 输入为例,适合实时摄像头或单图低延迟场景。
cd <PATH>/yolov5
python export.py --weights <PATH>/best.pt --include engine --imgsz 640 640 --batch-size 1 --device 0 --half
预期输出
TensorRT: starting export with TensorRT <VERSION>...
TensorRT: export success, saved as <PATH>/best.engine
Export complete (<TIME>s)<PATH>、<VERSION> 与 <TIME> 会随本机环境变化。生成的 best.engine 是部署产物,不应再交给训练代码继续更新;权重变化、输入规格变化或 TensorRT 环境升级后,都应重新构建引擎。
运行并验证加速
使用相同输入尺寸运行 TensorRT 引擎,观察日志中的预处理、推理和 NMS 耗时。第一次推理通常包含初始化与内存分配,不能直接作为稳定延迟,应先预热多次,再统计后续样本。
cd <PATH>/yolov5
python detect.py --weights <PATH>/best.engine --source <PATH>/images --imgsz 640 640 --device 0
预期输出
image 1/1 <PATH>/images/<ID>.jpg: 640x640 <ID> detections
Speed: <TIME>ms pre-process, <TIME>ms inference, <TIME>ms NMS per image
Results saved to <PATH>/runs/detect/<ID>
比较性能时,PyTorch 与 TensorRT 必须使用相同 GPU、批量、输入尺寸、预热次数和后处理设置。除延迟外,还要抽样核对检测框、类别和置信度,避免只看速度而忽略导出算子差异造成的精度偏移。
适用边界与常见失败
固定输入尺寸通常能得到更稳定的优化结果;需要动态批量或动态分辨率时,应显式配置动态 profile,并接受更长的构建时间和可能略低的峰值性能。显存不足时可减小批量或输入尺寸,而不是盲目增大 TensorRT 工作空间。
若导出时报算子不支持,先确认当前 YOLOv5 提交版本、onnx、onnxruntime 和 TensorRT 的兼容性,再尝试关闭不必要的动态选项。若 FP16 输出异常,应先用 FP32 引擎验证模型链路,随后检查显卡是否具备可靠的 FP16 支持以及自定义算子是否被正确转换。
本课总结
- TensorRT 的收益来自图优化、算子融合和面向目标 GPU 的执行计划
- FP16 适合支持半精度计算的 NVIDIA GPU,但必须用同条件基准测试确认收益
.engine与构建环境和输入规格强绑定,环境或模型变化后应重新导出
下一课预告
下一课将从模型裁剪、量化和知识蒸馏三个方向选择轻量化方案,并分析速度、体积与精度之间的取舍。