
计算机视觉 / 系统课时
输入尺寸与图像缩放
输入尺寸与图像缩放
YOLOv5 不能直接把任意尺寸图片组成批量张量,因此推理前需要完成等比例缩放、边缘填充和维度整理。本课将解释 imgsz、Letterbox 和批量输入之间的关系,并通过可运行示例验证坐标与形状变化。
学习目标
- 理解输入尺寸对精度、显存和速度的影响
- 掌握 Letterbox 等比例缩放与填充过程
- 能够构造尺寸一致的批量输入并验证结果
为什么输入尺寸必须统一
神经网络按张量计算,同一批次中的图片必须具有相同的高和宽。若直接把一张 1280×720 图片拉伸成 640×640,目标会发生形变;若只做等比例缩放,缩放后可能得到 640×360,又无法直接与其他尺寸图片堆叠。
YOLOv5 常用 Letterbox:先按同一比例缩放,再在较短边两侧补边,使最终尺寸满足模型要求。这样既保留原始宽高比,又能得到规则张量。
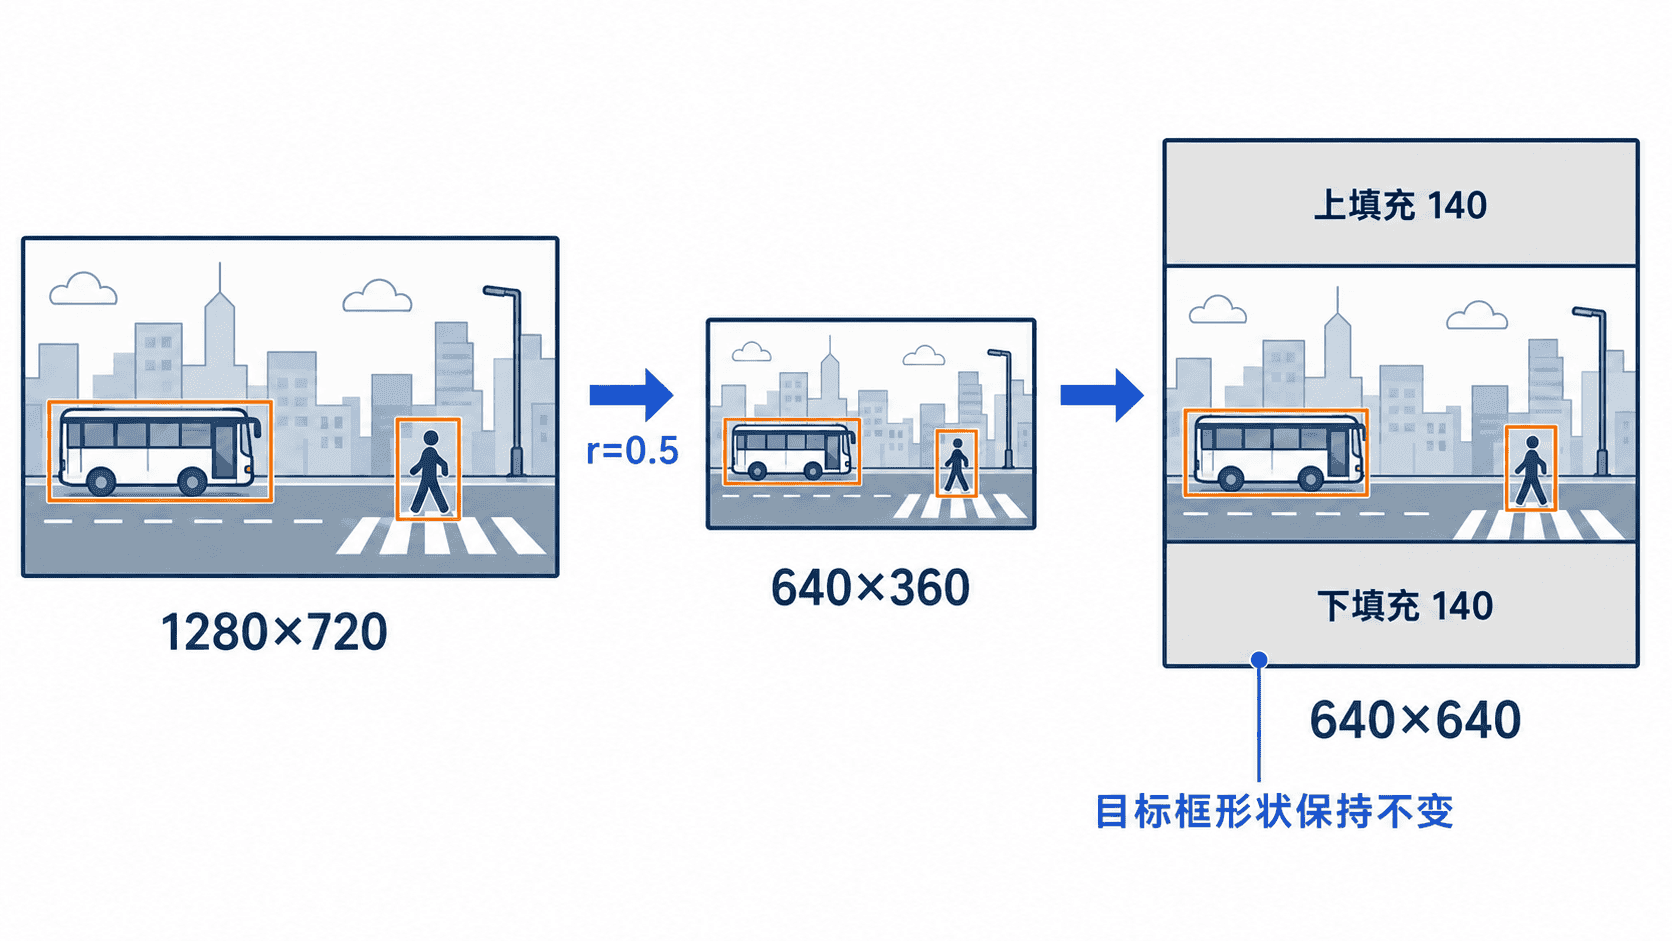
Letterbox 的计算过程
设原图尺寸为 ,目标尺寸为 。等比例缩放系数取两个方向比例中的较小值:
缩放后尺寸为 、。剩余宽高分别用于左右和上下填充。以 1280×720 输入到 640×640 为例,缩放系数是 0.5,缩放后为 640×360,因此只需在上下方向共填充 280 像素。
YOLOv5 的实际实现还可能让最终尺寸对最大步长 stride 对齐。常见模型最大步长为 32,因此输入尺寸通常选择 320、640、960 等 32 的倍数,避免特征图尺寸出现额外取整。
用代码验证缩放和填充
下面示例使用 OpenCV 实现一个简化版 Letterbox。它返回处理后的图片、缩放比例和左右上下填充值,后续还原检测框坐标时会用到这些信息。
from __future__ import annotations

import cv2
import numpy as np

def letterbox(
    image: np.ndarray,
    target_size: tuple[int, int] = (640, 640),
    fill_value: tuple[int, int, int] = (114, 114, 114),
) -> tuple[np.ndarray, float, tuple[int, int, int, int]]:
    target_width, target_height = target_size
    height, width = image.shape[:2]

    # 使用较小缩放比例,避免任何一边超过目标尺寸。
    ratio = min(target_width / width, target_height / height)
    new_width = round(width * ratio)
    new_height = round(height * ratio)

    resized = cv2.resize(image, (new_width, new_height), interpolation=cv2.INTER_LINEAR)

    pad_width = target_width - new_width
    pad_height = target_height - new_height
    left = pad_width // 2
    right = pad_width - left
    top = pad_height // 2
    bottom = pad_height - top

    padded = cv2.copyMakeBorder(
        resized,
        top,
        bottom,
        left,
        right,
        borderType=cv2.BORDER_CONSTANT,
        value=fill_value,
    )
    return padded, ratio, (left, top, right, bottom)

if __name__ == "__main__":
    # 构造一张 1280×720 的测试图片,避免依赖外部文件。
    image = np.zeros((720, 1280, 3), dtype=np.uint8)
    output, ratio, padding = letterbox(image)

    batch = np.stack([output, output], axis=0)
    print(f"缩放比例: {ratio:.2f}")
    print(f"填充 left, top, right, bottom: {padding}")
    print(f"单张输出形状: {output.shape}")
    print(f"批量输入形状: {batch.shape}")
预期输出:
缩放比例: 0.50
填充 left, top, right, bottom: (0, 140, 0, 140)
单张输出形状: (640, 640, 3)
批量输入形状: (2, 640, 640, 3)
模型实际输入通常还要把 OpenCV 的 BGR 转成 RGB,将维度从 NHWC 调整为 NCHW,再归一化到 0~1。不同框架对数据类型和维度顺序的要求不同,应以当前推理代码为准。
输入尺寸如何影响精度与效率
更大的输入尺寸保留更多细节,对小目标通常更友好,但计算量、显存占用和推理时间也会增加。卷积计算量大致随像素数量增长:从 640×640 提升到 1280×1280,像素数量变为 4 倍,实际耗时通常也会明显增加。
过小尺寸会让小目标在缩放后只剩几个像素,特征难以保留。过大尺寸则可能超过显存,并降低批量大小。选择 imgsz 时应在目标最小尺寸、部署延迟和硬件资源之间权衡,而不是默认越大越好。
训练与推理尺寸可以不同,但差异过大时,目标尺度分布也会变化。生产环境应使用真实图片做基准测试,记录精度、单张延迟、吞吐量和显存峰值,再确定最终尺寸。
批量输入的边界
批量推理能提高 GPU 吞吐量,但批次中的每张图片都必须经过相同的尺寸整理。原图尺寸可以不同,只要 Letterbox 后的张量形状一致即可。还原检测框时,每张图片必须保存自己的缩放比例和填充值,不能共用第一张图的参数。
动态批次适合请求量波动的服务,固定批次更容易获得稳定性能。若在线接口强调单请求低延迟,批量过大反而会增加排队时间;若离线处理大量图片,则可以在显存允许范围内提高批量大小。
本课总结
- Letterbox 通过等比例缩放和边缘填充统一输入尺寸,同时减少目标形变
- 较大输入尺寸有利于保留小目标细节,但会增加计算量、显存和延迟
- 批量输入必须形状一致,并为每张图片单独保存缩放与填充参数
下一课预告
下一课将继续拆解 YOLOv5 的模型结构,理解主干网络如何把输入图像逐层转换为不同尺度的特征图。