
计算机视觉 / 系统课时
验证导出模型
验证导出模型
本课建立一套可重复的 ONNX 验证流程:先用相同图片直观看检测框,再比较两种后端的原始输出误差,最后在预热后统计推理耗时。完成后,你能判断差异来自模型导出、后处理阈值,还是不公平的测试条件。
学习目标
- 使用同一输入对比 PyTorch 与 ONNX 检测结果
- 计算原始预测张量的最大误差与平均误差
- 在统一设备和预处理条件下测量推理延迟
建立公平对比基线
验证时必须固定输入图片、图像尺寸、归一化方式、置信度阈值、IoU 阈值和运行设备。若 PyTorch 使用 GPU、ONNX 使用 CPU,或者两次推理采用不同的 Letterbox 参数,速度和检测框都没有直接可比性。
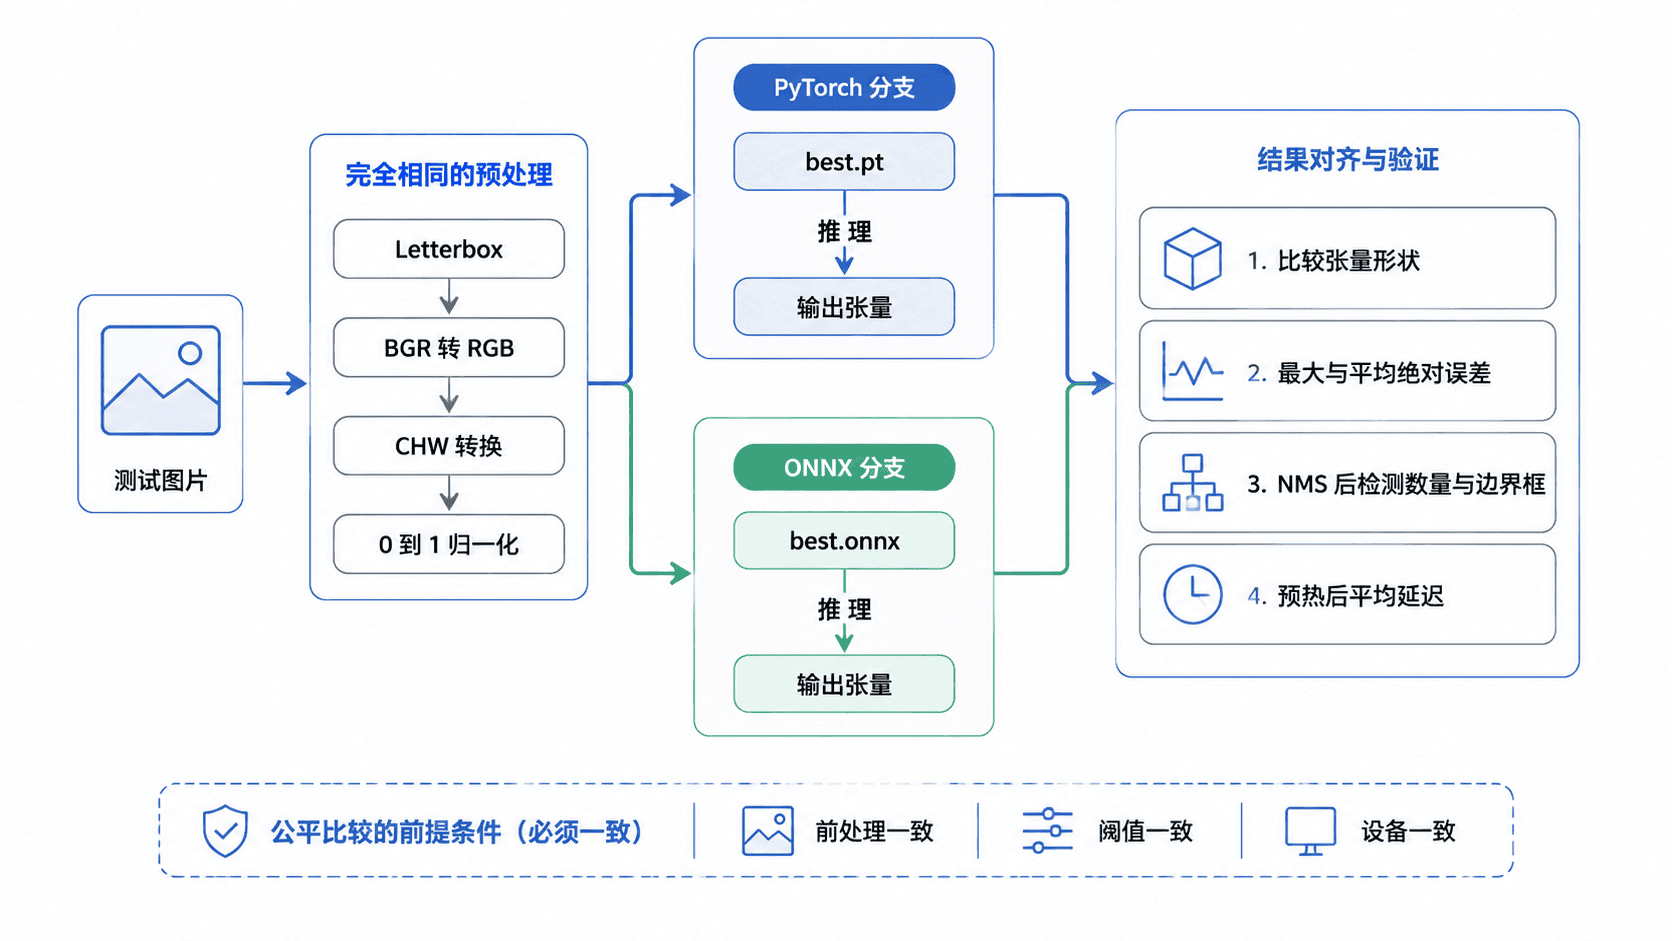
先比较可视化结果
YOLOv5 的 detect.py 可以直接加载 .pt 和 .onnx 权重;ONNX 默认由 ONNX Runtime 执行,添加 --dnn 时则使用 OpenCV DNN。:contentReference[oaicite:1]{index=1} 下面两次命令只改变权重和输出目录名称,其余参数保持一致。
python detect.py --weights runs/train/exp/weights/best.pt --source data/images/bus.jpg --imgsz 640 --conf-thres 0.25 --iou-thres 0.45 --device cpu --project runs/verify --name pytorch --exist-ok
python detect.py --weights runs/train/exp/weights/best.onnx --source data/images/bus.jpg --imgsz 640 --conf-thres 0.25 --iou-thres 0.45 --device cpu --project runs/verify --name onnx --exist-ok
预期结果
Results saved to runs/verify/pytorch
Results saved to runs/verify/onnx
打开两个目录中的同名结果图,重点检查类别、漏检与误检、框的位置以及置信度。靠近阈值的候选框可能因极小数值差异出现或消失,因此视觉结果只能作为第一层验证,不能替代原始张量比较。
比较数值误差与速度
将下面脚本保存为 YOLOv5 根目录下的 compare_backends.py。它复用同一份预处理张量,分别加载 PyTorch 和 ONNX 模型,在 CPU 上预热后比较形状、绝对误差、NMS 后检测数量和平均延迟。
from pathlib import Path
import time

import cv2
import numpy as np
import torch

from models.common import DetectMultiBackend
from utils.augmentations import letterbox
from utils.general import non_max_suppression
from utils.torch_utils import select_device

PT_PATH = Path("runs/train/exp/weights/best.pt")
ONNX_PATH = Path("runs/train/exp/weights/best.onnx")
IMAGE_PATH = Path("data/images/bus.jpg")
IMAGE_SIZE = (640, 640)
WARMUP_RUNS = 5
TEST_RUNS = 30

def preprocess(path: Path, device: torch.device) -> torch.Tensor:
    image = cv2.imread(str(path))
    if image is None:
        raise FileNotFoundError(f"无法读取图片:{path}")

    # 两个后端必须复用完全相同的 Letterbox 与归一化结果
    image = letterbox(image, IMAGE_SIZE, stride=32, auto=False)[0]
    image = image.transpose((2, 0, 1))[::-1]
    image = np.ascontiguousarray(image)
    tensor = torch.from_numpy(image).to(device).float() / 255.0
    return tensor.unsqueeze(0)

def infer(model: DetectMultiBackend, image: torch.Tensor) -> torch.Tensor:
    output = model(image, augment=False, visualize=False)
    return output[0] if isinstance(output, (list, tuple)) else output

def benchmark(model: DetectMultiBackend, image: torch.Tensor) -> float:
    for _ in range(WARMUP_RUNS):
        infer(model, image)

    start = time.perf_counter()
    for _ in range(TEST_RUNS):
        infer(model, image)
    elapsed = time.perf_counter() - start
    return elapsed * 1000 / TEST_RUNS

def main() -> None:
    device = select_device("cpu")
    image = preprocess(IMAGE_PATH, device)

    pt_model = DetectMultiBackend(PT_PATH, device=device, fp16=False)
    onnx_model = DetectMultiBackend(ONNX_PATH, device=device, fp16=False)

    pt_raw = infer(pt_model, image).float().cpu()
    onnx_raw = infer(onnx_model, image).float().cpu()
    if pt_raw.shape != onnx_raw.shape:
        raise ValueError(f"输出形状不一致:{pt_raw.shape} != {onnx_raw.shape}")

    diff = (pt_raw - onnx_raw).abs()
    pt_det = non_max_suppression(pt_raw.clone(), 0.25, 0.45)[0]
    onnx_det = non_max_suppression(onnx_raw.clone(), 0.25, 0.45)[0]

    print(f"shape: {tuple(pt_raw.shape)}")
    print(f"max_abs_error: {diff.max().item():.8f}")
    print(f"mean_abs_error: {diff.mean().item():.8f}")
    print(f"detections: pytorch={len(pt_det)}, onnx={len(onnx_det)}")
    print(f"latency_ms: pytorch={benchmark(pt_model, image):.2f}")
    print(f"latency_ms: onnx={benchmark(onnx_model, image):.2f}")

if __name__ == "__main__":
    main()
预期输出
shape: (1, <PREDICTIONS>, <5+CLASS_COUNT>)
max_abs_error: <VALUE>
mean_abs_error: <VALUE>
detections: pytorch=<COUNT>, onnx=<COUNT>
latency_ms: pytorch=<TIME>
latency_ms: onnx=<TIME><VALUE>、<COUNT> 与 <TIME> 由模型、图片和硬件决定。验证重点不是追求固定数字,而是确认输出形状相同、结果全部为有限值、误差没有异常放大,并且 NMS 后的主要目标保持一致。
判断差异是否可接受
FP32 后端之间允许存在小量浮点误差,但不能只凭一个通用阈值判定通过。应先观察最大误差与平均误差,再确认误差是否改变类别、置信度排序或边界框位置。靠近 conf-thres 的候选框最容易因微小差异跨过阈值。
速度测试至少要预热,并连续运行多次。首次加载时间、模型解析时间和图片读取时间不应计入纯推理延迟;比较 GPU 时还要执行同步,并确认 ONNX Runtime 实际启用了对应硬件执行提供程序。
建议把验收标准写进项目:固定一组代表性测试图片,要求模型输出形状一致、无 NaN 或无穷值、关键目标类别一致,并记录允许的框坐标、置信度与延迟变化范围。这样模型重新导出后可以重复回归,而不是依赖人工印象。
常见异常定位
若 ONNX 完全没有检测结果,先检查输入是否为 RGB、是否除以 255、张量是否为 NCHW,再检查输出是否遗漏 NMS。若结果图相似但原始误差很大,应确认加载的是同一份权重导出的文件,并关闭半精度或量化后重新比较。
若 ONNX 明显更慢,先确认测试设备、线程配置和运行时执行提供程序一致。小模型或单张图片中,数据转换和调度开销可能占比较高,不能仅凭一次耗时判断后端优劣。
本课总结
- 公平验证要求两个后端共享输入、预处理、阈值和运行设备
- 应同时比较可视化结果、原始张量误差和 NMS 后检测结果
- 性能测试必须预热并重复运行,首次加载时间不能混入推理延迟
下一课预告
下一步可以根据目标设备继续导出 TensorRT、OpenVINO 或其他格式,并使用本课的回归方法验证精度与性能变化。