
计算机视觉 / 系统课时
管理数据与模型版本
管理数据与模型版本
模型效果发生变化时,只有保存一个 best.pt 无法回答“用了哪批数据、哪份配置和哪次代码”。本课建立数据、配置、代码、环境与权重的绑定方式,让每次训练都可追溯、可复现、可比较并可回滚。
学习目标
- 能为一次训练定义唯一且稳定的版本标识
- 能记录数据、配置、代码、环境和权重之间的对应关系
- 能通过校验和与发布清单验证模型是否被替换或混用
把一次训练视为完整发布单元
一个可追踪模型至少包含五类信息:数据集版本、训练配置、代码提交、运行环境和输出权重。任意一项缺失,都可能出现“文件名相同但结果不同”的情况。
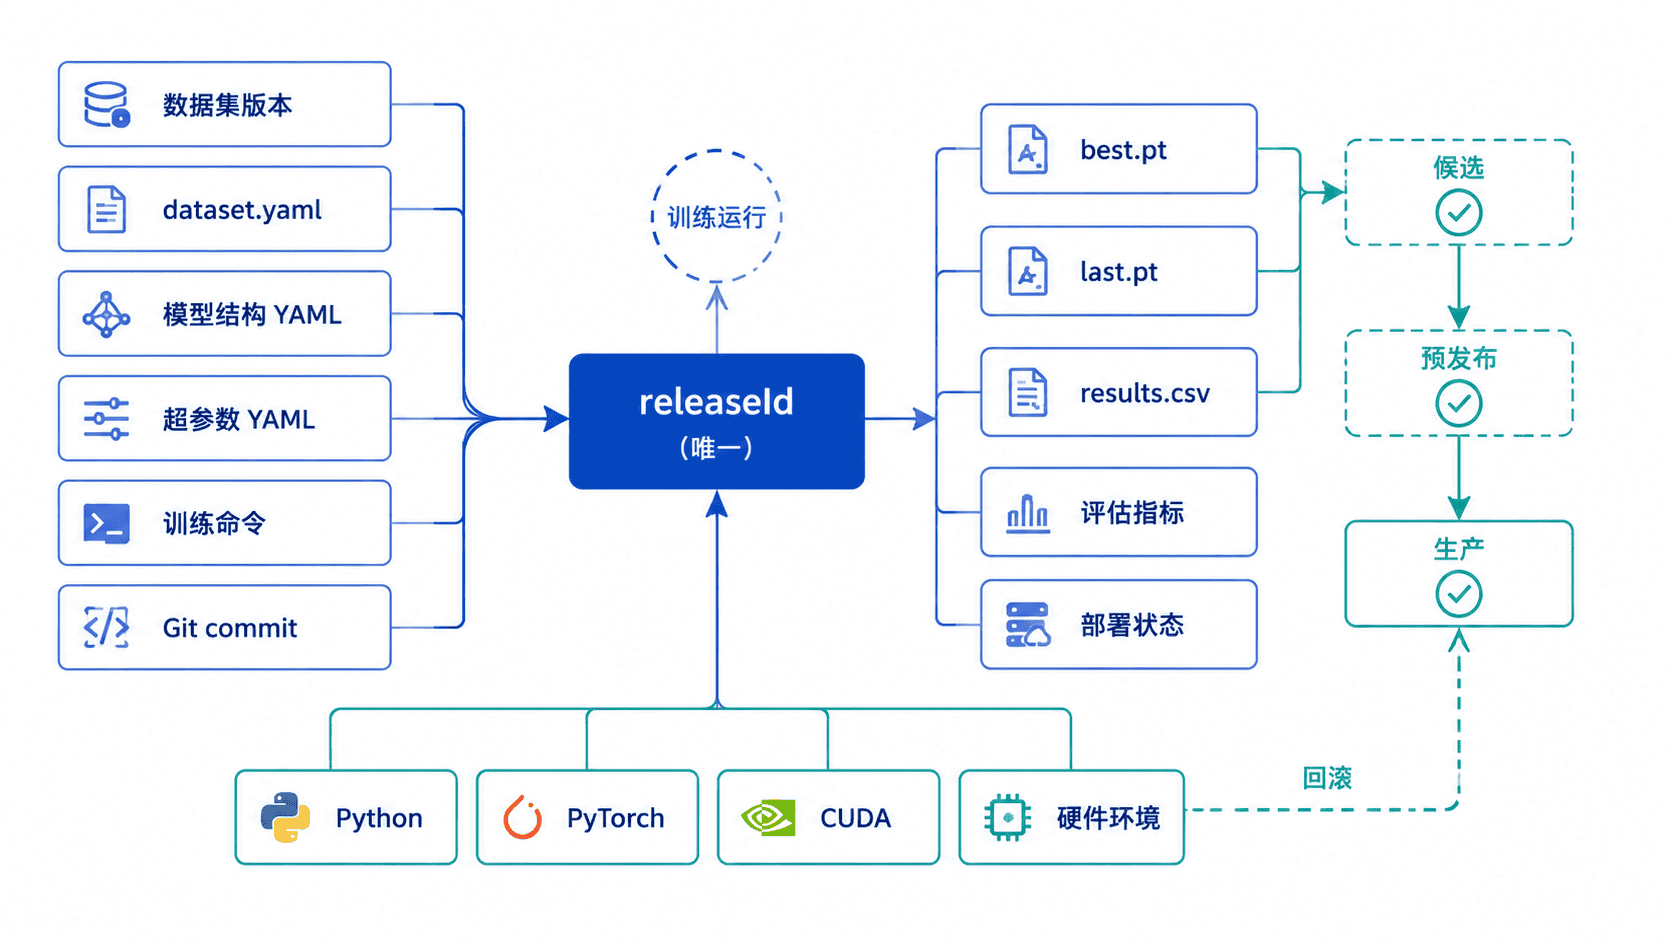
建议使用不可重复的 releaseId,例如 yolov5-20260803-001。它应出现在训练目录、发布清单、对象存储路径、评估记录和部署配置中,而不是仅写在聊天记录或人工备注里。
固定目录与命名规则
代码和小型配置适合使用 Git 管理;原始数据与大型权重不宜直接塞进普通 Git 仓库,可放在对象存储、制品库或数据版本工具中,但必须记录稳定地址和 SHA-256 校验值。
export RELEASE_ID="yolov5-20260803-001"
export RELEASE_DIR="artifacts/releases/${RELEASE_ID}"

# 保存不可变的代码提交号
mkdir -p "${RELEASE_DIR}"
git rev-parse HEAD > "${RELEASE_DIR}/code.commit"

# 对关键配置和权重生成内容校验值
sha256sum \
  data/dataset.yaml \
  data/hyps/hyp.scratch-low.yaml \
  runs/train/exp/weights/best.pt \
  > "${RELEASE_DIR}/checksums.sha256"

find "${RELEASE_DIR}" -maxdepth 1 -type f -printf "%f\n" | sort
预期输出
checksums.sha256
code.commit
code.commit 保存精确提交号,checksums.sha256 证明配置和权重内容未被替换。路径中的训练目录可按实际项目调整,动态提交号会因仓库而不同。
编写发布清单
发布清单是版本关系的唯一入口。下面是一个 YAML 配置示例,其中动态值使用占位符,正式发布时必须替换为真实内容。
releaseId: yolov5-20260803-001
createdAt: "<TIME>"
code:
  commit: "<GIT_COMMIT>"
  repository: "<REPOSITORY_URL>"
data:
  version: dataset-v1.4.0
  manifest: data/manifests/dataset-v1.4.0.txt
  sha256: "<DATA_MANIFEST_SHA256>"
config:
  datasetYaml: data/dataset.yaml
  modelYaml: models/yolov5s.yaml
  hypYaml: data/hyps/hyp.scratch-low.yaml
  imageSize: 640
  batchSize: 16
  epochs: 100
environment:
  python: "<PYTHON_VERSION>"
  pytorch: "<PYTORCH_VERSION>"
  cuda: "<CUDA_VERSION>"
weights:
  best:
    uri: "<ARTIFACT_URI>/best.pt"
    sha256: "<BEST_PT_SHA256>"
metrics:
  map50: "<MAP50>"
  map5095: "<MAP50_95>"
deployment:
  status: candidate
清单不应手工猜测指标或环境版本。训练结束后从实际运行目录和环境命令中采集,再由发布流程写入。验证时先读取清单,再校验文件哈希和 Git 提交是否一致。
让训练输出绑定版本号
训练目录名应直接使用 releaseId,这样 opt.yaml、结果曲线、日志和权重天然归属于同一次运行。下面命令假设相关数据与配置文件已经存在。
# 版本号直接作为训练运行目录名
python train.py \
  --img 640 \
  --batch 16 \
  --epochs 100 \
  --data data/dataset.yaml \
  --cfg models/yolov5s.yaml \
  --hyp data/hyps/hyp.scratch-low.yaml \
  --weights yolov5s.pt \
  --project runs/train \
  --name yolov5-20260803-001 \
  --exist-ok
预期结果
runs/train/yolov5-20260803-001/
├── opt.yaml
├── results.csv
└── weights/
    ├── best.pt
    └── last.pt
不同 YOLOv5 版本生成的附加图片或日志可能不同,但训练参数、指标记录和权重必须保存在同一版本目录。正式流程中不建议对已发布目录再次使用 --exist-ok 覆盖内容,可改为在启动前检查目录不存在。
校验、发布与回滚
制品上传后,在部署前执行校验,确保下载到本机的文件与发布清单一致。校验失败时必须停止发布,而不是继续加载“看起来能用”的权重。
sha256sum -c artifacts/releases/yolov5-20260803-001/checksums.sha256预期输出
data/dataset.yaml: OK
data/hyps/hyp.scratch-low.yaml: OK
runs/train/exp/weights/best.pt: OK
生产环境只引用一个明确的 releaseId,不要直接引用会变化的 latest/best.pt。发布状态可以按 candidate、staging、production 管理;回滚时切回上一条已验证的发布清单,而不是临时寻找旧权重文件。
建立最小审计记录
每次发布至少记录发布时间、操作人、目标环境、旧版本、新版本、校验结果和评估结论。数据集新增、删除或修正样本时,也要生成新的数据清单,保留文件相对路径、大小和哈希,避免只修改 dataset.yaml 的版本文字。
当模型出现线上异常时,应能从部署配置找到 releaseId,再由清单定位权重哈希、训练目录、Git 提交和数据版本。能完成这条反向链路,版本管理才真正生效。
本课总结
- 模型版本不是一个权重文件,而是数据、配置、代码、环境、指标和制品的完整绑定
releaseId、Git 提交和 SHA-256 校验值共同保证训练结果可追踪且不被混用- 生产部署应引用不可变版本,并通过发布清单完成校验、晋级和回滚
下一课预告
完成版本管理后,可以把误检样本、线上反馈和新数据持续回流到训练流程,形成可度量的模型迭代闭环。