
计算机视觉 / 系统课时
划分训练验证测试集
划分训练验证测试集
数据集划分决定了训练结果是否可信。本课将按来源分组后再划分训练集、验证集和测试集,保证同一视频或连拍产生的相似图片不会跨集合泄漏,并给出可直接运行的复制脚本。
学习目标
- 理解训练集、验证集和测试集的职责
- 按来源分组并使用固定随机种子划分
- 检查图片、标签数量及样本泄漏问题
三个子集分别做什么
训练集用于更新模型参数,通常占全部数据的 70%~85%。验证集用于选择超参数、观察过拟合和挑选最佳权重,一般占 10%~20%。测试集只在模型方案确定后进行最终评估,不能反复用于调参。
常见起点是 8:1:1。数据量较小时,可以使用 8:2 只划分训练集和验证集;但准备对外报告最终指标时,仍应保留独立测试集。
为什么不能只随机打散图片
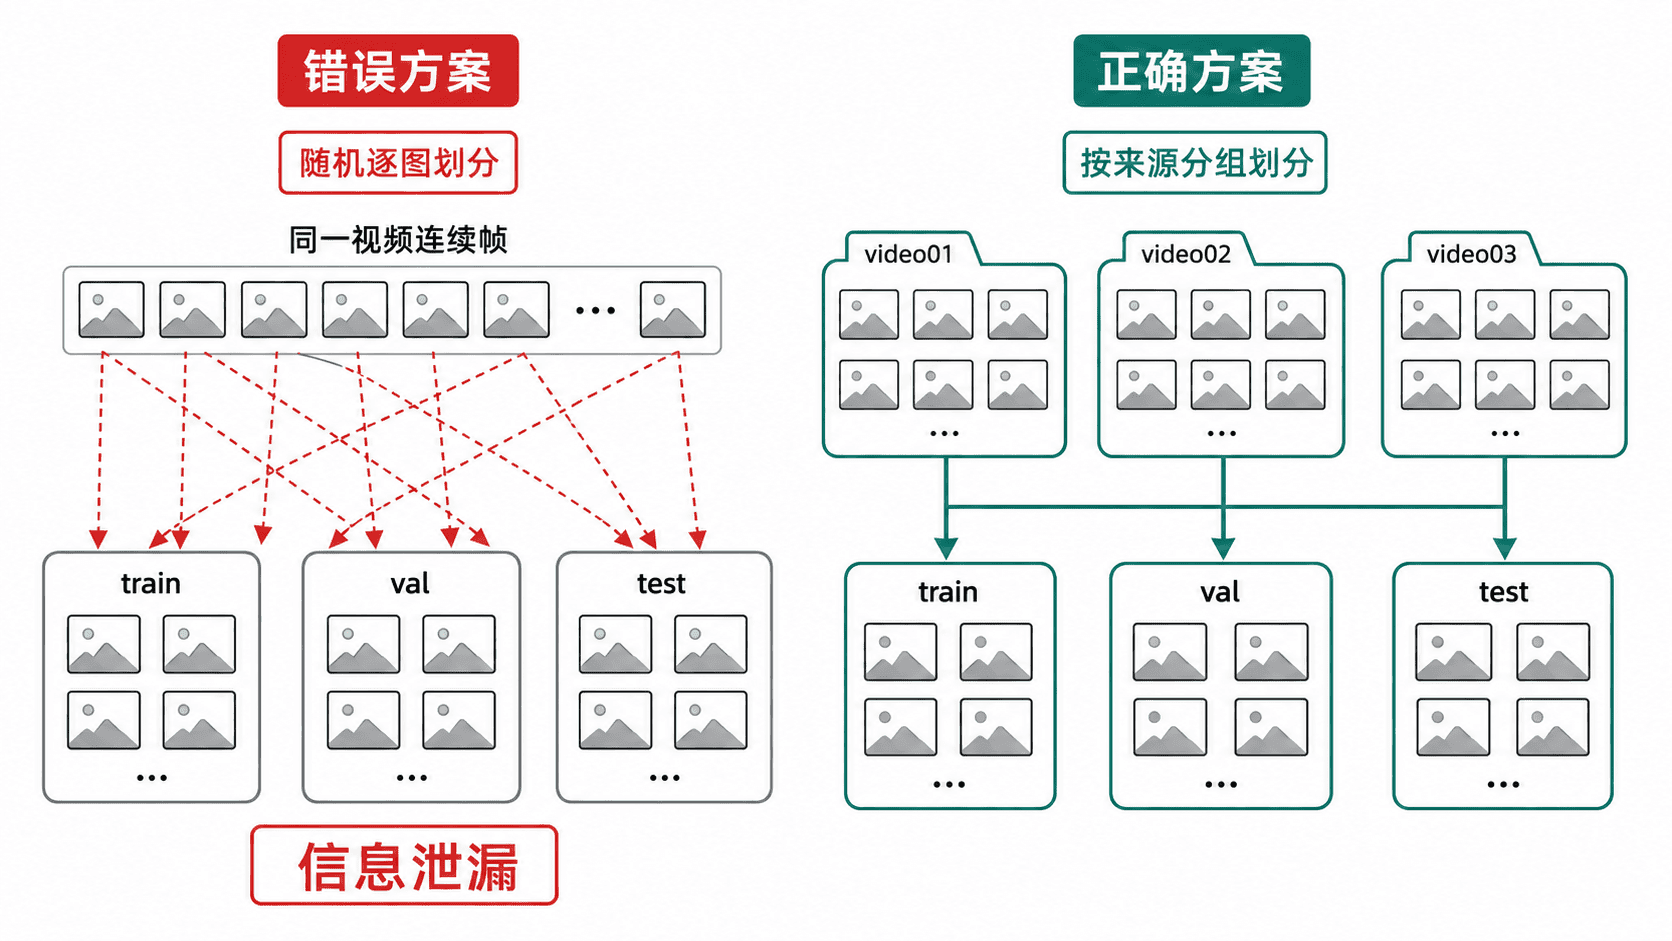
若数据来自视频抽帧、连拍、同一设备或同一对象,相邻图片往往高度相似。逐张随机划分会让几乎相同的画面同时出现在训练集和验证集中,模型可能只是“见过相似画面”,指标却被误认为泛化能力。
正确做法是先确定分组键,再按组划分。例如文件名 video03__000125.jpg 中,video03 可作为来源组;同一组的全部图片必须进入同一个子集。
使用脚本完成分组划分
下面脚本假设原始目录为 dataset_raw/images 和 dataset_raw/labels,图片名采用 <来源组>__<帧编号> 形式。脚本会按来源组打乱,按照 8:1:1 分配,并复制到 YOLO 常用目录结构。
from __future__ import annotations

import random
import shutil
from collections import defaultdict
from pathlib import Path

IMAGE_SUFFIXES = {".jpg", ".jpeg", ".png", ".bmp"}
RATIOS = (0.8, 0.1, 0.1)
SEED = 42

def group_key(image_path: Path) -> str:
    # video03__000125.jpg 会归入 video03 组
    return image_path.stem.split("__", maxsplit=1)[0]

def copy_pair(image_path: Path, label_dir: Path, output_dir: Path, split: str) -> None:
    label_path = label_dir / f"{image_path.stem}.txt"
    if not label_path.exists():
        raise FileNotFoundError(f"缺少标签文件: {label_path}")

    image_target = output_dir / "images" / split / image_path.name
    label_target = output_dir / "labels" / split / label_path.name
    image_target.parent.mkdir(parents=True, exist_ok=True)
    label_target.parent.mkdir(parents=True, exist_ok=True)

    shutil.copy2(image_path, image_target)
    shutil.copy2(label_path, label_target)

def main() -> None:
    source_dir = Path("dataset_raw")
    output_dir = Path("dataset_yolo")
    image_dir = source_dir / "images"
    label_dir = source_dir / "labels"

    groups: dict[str, list[Path]] = defaultdict(list)
    for image_path in sorted(image_dir.iterdir()):
        if image_path.suffix.lower() in IMAGE_SUFFIXES:
            groups[group_key(image_path)].append(image_path)

    group_names = list(groups)
    random.Random(SEED).shuffle(group_names)

    total_groups = len(group_names)
    train_end = int(total_groups * RATIOS[0])
    val_end = train_end + int(total_groups * RATIOS[1])

    assignments = {
        "train": group_names[:train_end],
        "val": group_names[train_end:val_end],
        "test": group_names[val_end:],
    }

    for split, names in assignments.items():
        for name in names:
            for image_path in groups[name]:
                copy_pair(image_path, label_dir, output_dir, split)
        image_count = sum(len(groups[name]) for name in names)
        print(f"{split}: {image_count} images, {len(names)} groups")

if __name__ == "__main__":
    main()
预期输出:
train: <TRAIN_COUNT> images, <TRAIN_GROUP_COUNT> groups
val: <VAL_COUNT> images, <VAL_GROUP_COUNT> groups
test: <TEST_COUNT> images, <TEST_GROUP_COUNT> groups
实际数量由原始数据和分组大小决定,因此会与占位符不同。脚本使用固定种子 42,只要输入文件和代码不变,多次运行的划分结果就保持一致。
验证划分结果
先确认三个子集的图片都存在同名标签,并检查总图片数是否与原始目录一致。然后提取每个文件名中的来源组,确认任意组只出现在一个子集中。
还要比较各子集的类别分布。若某个稀有类别只出现在测试集,训练阶段无法学到该类别;此时应调整分组分配,而不是把同一来源拆开。目标检测数据还应关注小目标、遮挡、光照和场景分布,不能只看总数量比例。
Tips:先固定测试集,再迭代训练集和验证集。测试集一旦参与模型选择,就不再是严格意义上的最终测试集。
常见错误
直接按文件排序后截取前 80% 会受到拍摄时间、设备或场景顺序影响。每次运行都使用不同随机种子,则难以公平比较两次训练。只复制图片而遗漏标签,会导致训练时出现缺失标注或样本数量不一致。
对于视频抽帧数据,分组键应使用视频编号;对于同一商品多角度拍摄,可使用商品编号;对于多人采集的数据,可按人员或采集批次分组。分组依据应与真实部署中可能遇到的新来源保持一致。
本课总结
- 训练集用于学习,验证集用于选择方案,测试集用于最终评估
- 相似样本必须按来源整组划分,避免验证指标被数据泄漏抬高
- 固定随机种子并检查数量、类别分布和组间交集,才能保证结果可复现
下一课预告
下一课将把图片与标签整理成 YOLOv5 可识别的目录和数据集配置文件,并验证训练程序能否正确加载类别与样本路径。