
计算机视觉 / 系统课时
选择合适模型规模
选择合适模型规模
模型规模不是越大越好。本课将把精度、端到端延迟和设备资源转成可验证的约束,再用同一环境下的实测数据筛选 YOLOv5n、s、m、l、x,得到可部署且留有余量的型号。
学习目标
- 理解不同模型规模在精度、速度和资源占用上的基本取舍
- 建立统一的验证与推理基准,避免无效比较
- 根据硬约束和实测结果选择最终模型
把需求写成选择标准
选择模型前,先把“效果好、速度快”改成可测量的条件。精度可使用验证集上的 mAP@0.5:0.95,速度应记录完整推理链路的 P95 延迟,资源则关注峰值显存、内存和模型文件大小。
| 维度 | 推荐记录项 | 约束示例 |
|---|---|---|
| 精度 | mAP、Precision、Recall | mAP@0.5:0.95 >= 0.50 |
| 延迟 | 预处理、模型推理、NMS、总耗时 | P95 总延迟不超过 8 ms |
| 资源 | 峰值显存、内存、模型大小 | 峰值显存不超过 3 GB |
YOLOv5n、s、m、l、x 的容量依次增大。更大的模型通常具有更强的特征表达能力,但参数量、计算量、显存占用和推理时间也会增加。实际收益还会受到数据量、目标尺寸、输入分辨率和设备算力影响。
| 规格 | 常见定位 | 适合优先验证的场景 |
|---|---|---|
| n | 极轻量 | 移动端、低功耗设备、快速原型 |
| s | 轻量均衡 | 普通边缘设备、实时业务基线 |
| m | 中等容量 | 有一定算力且更看重精度 |
| l | 大模型 | GPU 服务、低并发高精度任务 |
| x | 最大容量 | 离线处理或充足算力环境 |
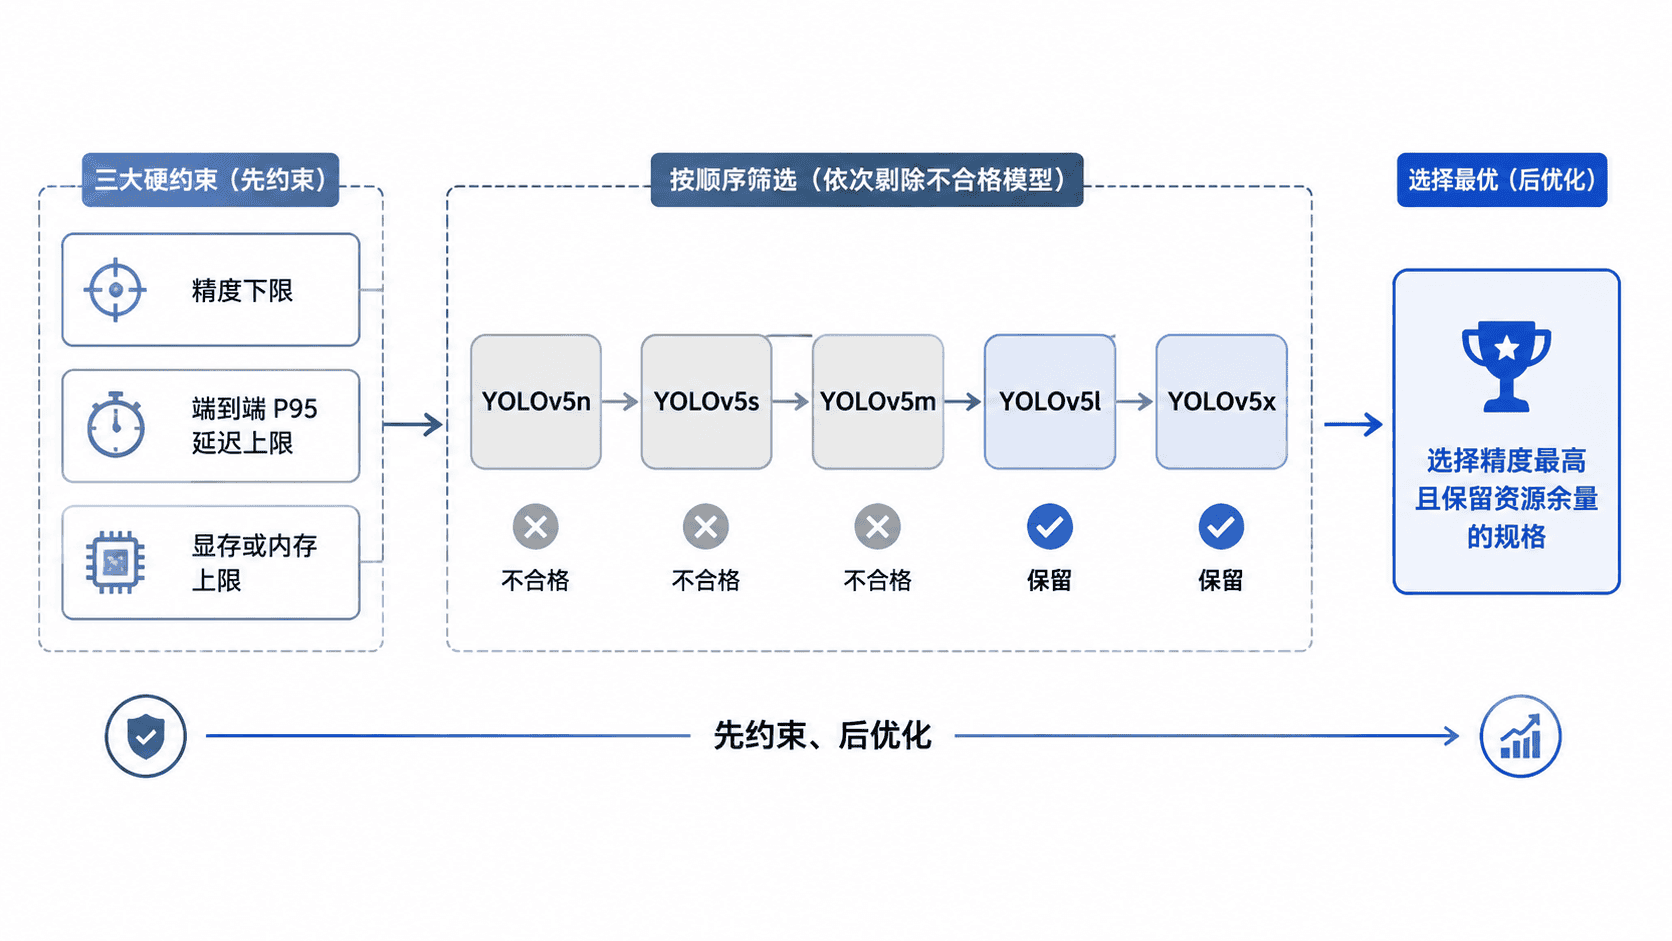
硬约束用于淘汰不可用方案,而不是计算平均分。例如模型精度最高,但延迟超过线上上限,就不应进入最终候选。
用同一环境建立基准
所有候选模型必须使用相同的数据集划分、输入尺寸、批大小、精度模式、设备和预热次数。公开表格只能用于初筛,最终决策必须以目标设备上的实测结果为准。
下面的脚本演示“先过滤硬约束,再从候选中选择精度最高者”。数据是示例,使用时应替换为自己的验证和压测结果。
from dataclasses import dataclass

@dataclass(frozen=True)
class ModelResult:
    name: str
    map_50_95: float
    p95_latency_ms: float
    peak_memory_gb: float

results = [
    ModelResult("yolov5n", 0.492, 4.8, 1.6),
    ModelResult("yolov5s", 0.534, 6.5, 2.1),
    ModelResult("yolov5m", 0.565, 7.9, 2.8),
    ModelResult("yolov5l", 0.584, 10.6, 3.9),
]

min_map = 0.50
max_latency_ms = 8.0
max_memory_gb = 3.0

candidates = [
    item
    for item in results
    if item.map_50_95 >= min_map
    and item.p95_latency_ms <= max_latency_ms
    and item.peak_memory_gb <= max_memory_gb
]

if not candidates:
    raise RuntimeError("没有模型同时满足全部硬约束")

best = max(candidates, key=lambda item: item.map_50_95)
print("候选模型:", ", ".join(item.name for item in candidates))
print(
    f"推荐模型: {best.name}, "
    f"mAP={best.map_50_95:.3f}, "
    f"P95={best.p95_latency_ms:.1f} ms, "
    f"显存={best.peak_memory_gb:.1f} GB"
)
预期输出:
候选模型: yolov5s, yolov5m
推荐模型: yolov5m, mAP=0.565, P95=7.9 ms, 显存=2.8 GB
这个结果不是说明 m 永远优于 s,而是说明在当前约束和样例数据下,m 是剩余候选中精度最高的方案。
做出最终选择
压测通过后,不要把资源使用推到设备极限。线上还会受到并发、温度、后台进程、输入尺寸波动和冷启动影响,应在延迟、显存和内存上保留安全余量。
最终验收时至少检查连续运行是否稳定、P95 或 P99 延迟是否达标、峰值资源是否仍低于上限。若两种模型精度差距很小,优先选择更轻、更稳定、部署成本更低的规格。
常见误区包括直接比较不同输入尺寸或设备的结果、只看模型前向耗时而忽略预处理与 NMS、只跑一次短测试,以及默认选择最大模型却不验证精度收益是否值得增加的成本。
本课总结
- 模型选择应先满足精度、延迟和资源硬约束,再比较候选方案
- n、s、m、l、x 只表示相对规模,最终结论必须来自同环境实测
- 精度接近时,优先选择资源余量更大、部署更稳定的模型
下一课预告
下一课将建立控制变量的对照实验流程,统一记录训练配置、代码版本和评估结果,让每一次调优都可以复现和比较。