
计算机视觉 / 系统课时
排查训练指标异常
排查训练指标异常
当损失不下降、Precision 或 mAP 长期为零、训练出现 nan,或验证结果大幅波动时,应先排除数据与配置错误,再讨论模型和超参数,避免在错误标签上反复调参。
学习目标
- 根据异常表现判断最可能的数据、配置或优化问题
- 使用脚本检查 YOLO 标签格式、类别编号和归一化范围
- 通过最小基线和单变量修改验证修复是否有效
先按现象分类
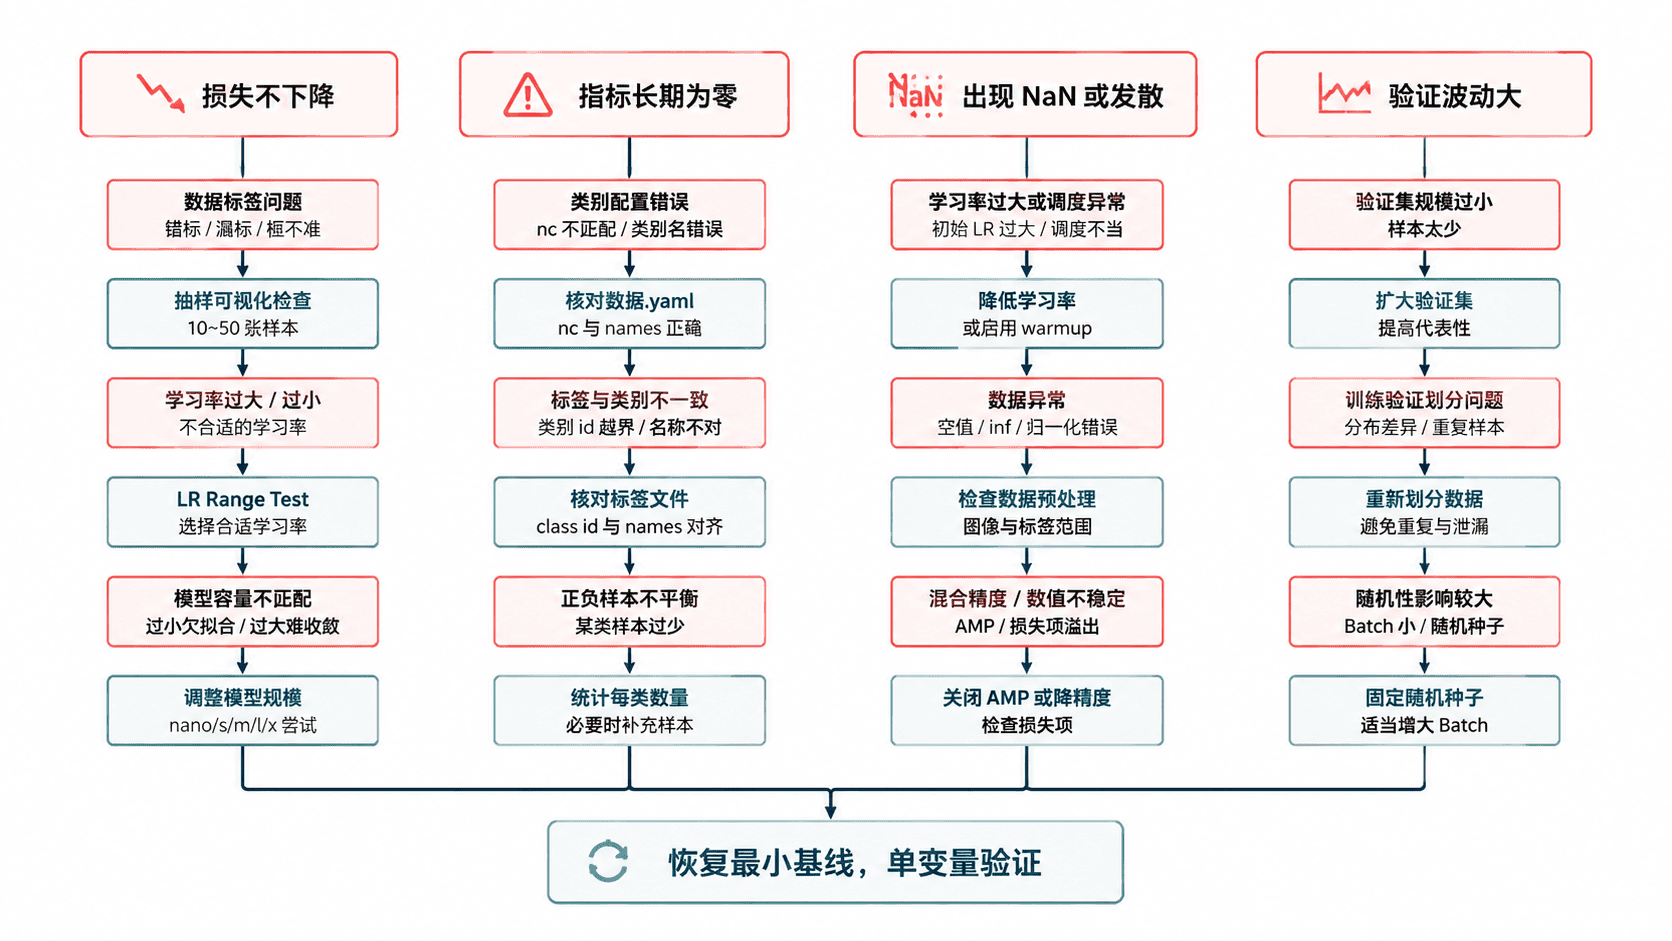
损失完全不下降,常见原因是标签未被读取、类别编号越界、图像与标签错配,或学习率与自定义超参数不合理。指标长期为零,还要检查验证集是否有目标、类别数是否一致,以及训练是否刚开始。
训练出现 nan 或损失突然爆炸,应优先检查非法框、损坏图像、过高学习率和自定义损失代码。验证指标上下波动很大,通常与验证集过小、类别极不均衡或少量难例占比过高有关。
单类别任务中的 cls_loss 接近或等于零可能是正常现象,因为没有多类别分类压力。不能只盯一个数字,应同时观察 box_loss、obj_loss、Precision、Recall 和 mAP 的整体趋势。
先检查标签而不是调参
YOLO 标签每行应为 class_id x_center y_center width height,其中类别编号必须位于 0 到 nc-1,四个坐标应归一化到 0~1,宽高还必须大于 0。下面的完整脚本会扫描标签目录并报告格式错误。
from pathlib import Path
import argparse

def check_labels(label_dir: Path, class_count: int) -> int:
    errors = 0
    files = sorted(label_dir.rglob("*.txt"))

    for file in files:
        for line_no, raw in enumerate(file.read_text(encoding="utf-8").splitlines(), 1):
            if not raw.strip():
                continue

            parts = raw.split()
            if len(parts) != 5:
                print(f"{file}:{line_no} fields={len(parts)}")
                errors += 1
                continue

            try:
                class_id = int(parts[0])
                x, y, width, height = map(float, parts[1:])
            except ValueError:
                print(f"{file}:{line_no} contains non-numeric values")
                errors += 1
                continue

            valid_class = 0 <= class_id < class_count
            valid_box = all(0.0 <= value <= 1.0 for value in (x, y, width, height))
            valid_size = width > 0.0 and height > 0.0

            if not (valid_class and valid_box and valid_size):
                print(f"{file}:{line_no} invalid class or box")
                errors += 1

    print(f"checked_files={len(files)} errors={errors}")
    return errors

if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--labels", type=Path, required=True)
    parser.add_argument("--nc", type=int, required=True)
    args = parser.parse_args()
    raise SystemExit(1 if check_labels(args.labels, args.nc) else 0)
将脚本保存为 check_yolo_labels.py 后运行:
python check_yolo_labels.py --labels datasets/custom/labels/train --nc 3预期输出
checked_files=<COUNT> errors=0<COUNT> 取决于实际标签文件数。若输出了具体文件和行号,应先修复这些标签,再重新训练;错误未清零前,不应继续通过学习率或模型规模掩盖问题。
核对配置与数据划分
确认数据集 YAML 中的 nc 与类别名称数量一致,标签类别从 0 连续编号。训练集和验证集路径必须真实存在,验证集不能为空,也不应与训练集大量重复,否则指标可能为零、剧烈波动或虚高。
再随机抽取若干图像,把标签框可视化检查。纯格式校验无法发现“框画在错误对象上”“图像与同名标签错配”或“类别语义标反”等问题,这些问题必须通过可视化样本确认。
如果前几轮指标为零但损失持续下降,不要立即判定失败。小数据集、随机初始化或难目标可能需要更多轮次才出现有效检测;真正异常的是长时间没有趋势,且预测可视化也没有任何合理框。
恢复最小基线再逐项修改
先回到可解释基线:使用官方预训练权重、默认超参数、较小模型和稳定的数据划分。只保留必要的数据增强,并固定随机种子,记录每次实验的权重、数据版本和配置。
每次只改一个变量,例如只调整学习率、只更换模型规模或只修改一种增强。若同时改动多项,即使指标恢复,也无法确认真正原因。
修复后应检查三个结果:损失曲线整体趋于下降;验证指标不再长期为零或出现 nan;随机样本上的预测框与目标位置、类别基本一致。三项同时成立,才算完成定位。
本课总结
- 指标异常优先排查标签、类别配置和训练验证划分,调参应放在数据正确之后
- 单类别任务的
cls_loss为零可能正常,必须结合其他损失与验证指标判断 - 恢复最小基线并一次只改一个变量,才能确认修复与异常根因之间的关系
下一课预告
下一课将把误检、漏检和难例整理为可持续迭代的数据闭环,用新样本验证模型是否真正改善。