
计算机视觉 / 系统课时
管理模型加载生命周期
管理模型加载生命周期
本课解决检测服务中最常见的资源管理问题:模型何时加载、如何复用、何时释放,以及并发请求如何安全访问。完成后,模型只在进程启动时初始化一次,请求阶段直接复用,并在服务关闭时清理 CPU 或 GPU 资源。
学习目标
- 使用 FastAPI 生命周期管理模型初始化与释放
- 根据运行环境选择 CPU 或 CUDA,并执行一次模型预热
- 使用并发闸门限制同时推理数量,避免显存峰值失控
识别错误的加载方式
把 torch.hub.load() 写进接口函数会导致每个请求都重新解析仓库、构建网络并读取权重。这样不仅延迟高,还会反复申请内存或显存,压力稍大就可能出现进程抖动、显存不足或文件句柄堆积。
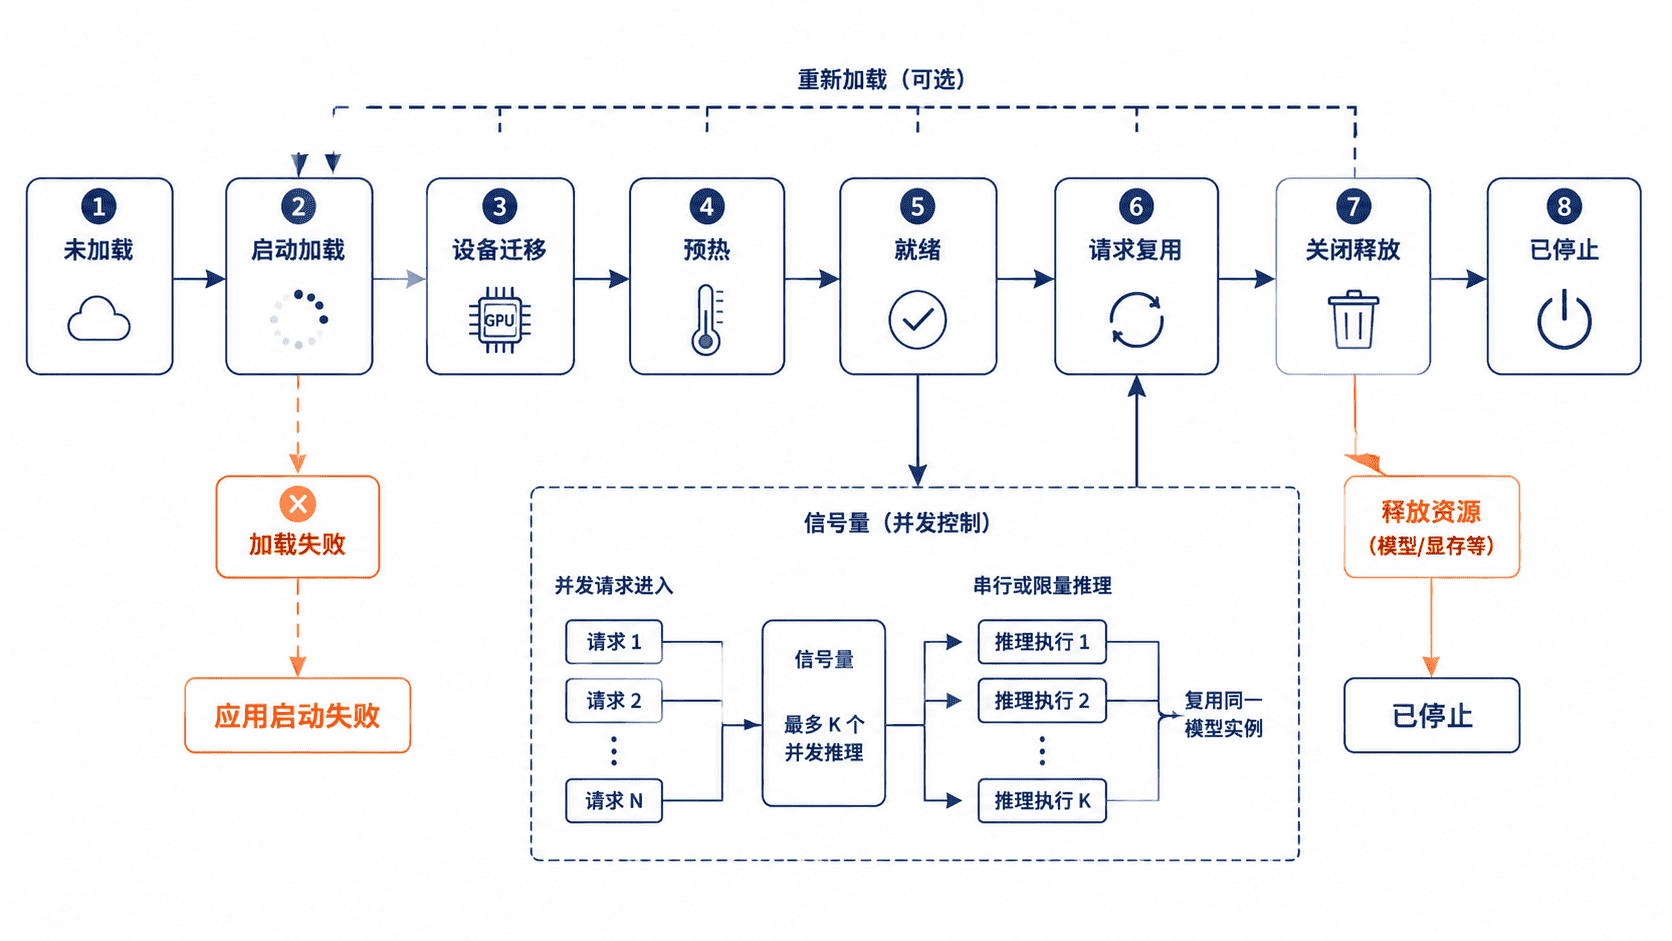
正确做法是让模型生命周期与 Web 进程一致:进程启动时加载并预热,进入就绪状态后处理请求,关闭时删除引用并清理缓存。需要注意,一个 Uvicorn worker 就是一个独立进程,因此 --workers 4 通常意味着加载四份模型。
使用 lifespan 加载与释放模型
下面示例使用 lifespan 管理资源,把模型保存在 app.state。asyncio.Semaphore(1) 表示单进程内同一时间只允许一个推理任务;若经过压测确认显存和模型实现可以承受更高并发,再逐步增大。
import asyncio
from contextlib import asynccontextmanager
from io import BytesIO
from pathlib import Path

import torch
from fastapi import FastAPI, File, HTTPException, Request, UploadFile
from PIL import Image, UnidentifiedImageError

BASE_DIR = Path(__file__).resolve().parent
YOLOV5_DIR = BASE_DIR / "yolov5"
WEIGHTS_PATH = BASE_DIR / "weights" / "best.pt"

def load_model() -> tuple[object, torch.device]:
    device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
    model = torch.hub.load(
        str(YOLOV5_DIR),
        "custom",
        path=str(WEIGHTS_PATH),
        source="local",
    )
    model.to(device)
    model.conf = 0.25
    model.iou = 0.45

    # 预热提前触发首次图构建和显存分配,避免首个真实请求异常缓慢。
    warmup = Image.new("RGB", (640, 640), color=(0, 0, 0))
    with torch.inference_mode():
        model(warmup, size=640)

    return model, device

def run_inference(model: object, image: Image.Image):
    with torch.inference_mode():
        return model(image, size=640)

@asynccontextmanager
async def lifespan(app: FastAPI):
    model, device = load_model()
    app.state.model = model
    app.state.device = device
    app.state.inference_gate = asyncio.Semaphore(1)
    yield

    del app.state.model
    if device.type == "cuda":
        torch.cuda.empty_cache()

app = FastAPI(
    title="YOLOv5 Lifecycle Service",
    version="1.0.0",
    lifespan=lifespan,
)

@app.get("/health")
def health(request: Request) -> dict:
    return {
        "status": "ready",
        "device": str(request.app.state.device),
    }

@app.post("/detect")
async def detect(request: Request, file: UploadFile = File(...)) -> dict:
    if file.content_type not in {"image/jpeg", "image/png"}:
        raise HTTPException(status_code=400, detail="仅支持 JPEG 或 PNG 图片")

    try:
        image = Image.open(BytesIO(await file.read())).convert("RGB")
    except UnidentifiedImageError as exc:
        raise HTTPException(status_code=400, detail="无法解析图片内容") from exc

    gate = request.app.state.inference_gate
    model = request.app.state.model

    # PyTorch 推理是阻塞任务,放入线程可避免直接阻塞事件循环。
    async with gate:
        try:
            results = await asyncio.to_thread(run_inference, model, image)
        except Exception as exc:
            raise HTTPException(status_code=500, detail="模型推理失败") from exc

    detections = []
    for x1, y1, x2, y2, confidence, class_id in results.xyxy[0].cpu().tolist():
        class_index = int(class_id)
        detections.append(
            {
                "box": [round(x1, 2), round(y1, 2), round(x2, 2), round(y2, 2)],
                "confidence": round(confidence, 4),
                "class_id": class_index,
                "class_name": results.names[class_index],
            }
        )

    return {"detection_count": len(detections), "detections": detections}
预期结果
应用启动时完成模型加载与预热;运行期间复用 app.state.model;关闭时删除模型引用并清理可回收的 CUDA 缓存。yield 之前是启动阶段,任何异常都会阻止应用进入就绪状态;yield 之后是关闭阶段。这样可以避免“端口已经监听,但模型其实没有加载成功”的假健康状态。
启动并观察生命周期
使用单 worker 启动,先确认设备与模型状态。GPU 部署时不要直接增加 worker 数量,因为每个进程都会拥有独立 CUDA 上下文和模型副本。
uvicorn app_lifecycle:app --host 0.0.0.0 --port 8000 --workers 1预期输出
INFO:     Started server process [<ID>]
INFO:     Waiting for application startup.
INFO:     Application startup complete.
INFO:     Uvicorn running on http://0.0.0.0:8000
启动完成后调用健康检查。
curl http://127.0.0.1:8000/health预期输出
{"status":"ready","device":"cuda:0"}没有可用 CUDA 时,device 会返回 cpu。首次启动时间通常比普通接口更长,因为模型加载和预热都发生在应用进入就绪状态之前。
设计并发与多进程策略
信号量控制的是单进程内并发,不会跨 worker 共享。单 GPU 场景通常先采用“一个 worker、一份模型、有限推理并发”,再通过队列、批处理或横向扩容提升吞吐,而不是盲目增加 Web worker。
当推理占用大量显存时,将信号量设为 1 最稳妥;若模型较小,可通过压测把值调整为 2 或更高。判断依据应同时包含吞吐、P95 延迟、GPU 利用率和显存峰值,不能只看单请求速度。
关闭阶段的 torch.cuda.empty_cache() 只释放 PyTorch 缓存中可回收的显存,并不能替代删除模型引用。进程异常退出时,操作系统和 CUDA 驱动会回收进程资源,因此不应依赖复杂的退出钩子完成关键业务写入。
验证是否只加载一次
最直接的验证方法是在 load_model() 开始和结束处记录日志,然后连续请求多次。正常情况下,加载日志只在进程启动时出现一次;若每次请求都出现,说明模型仍被放在接口函数或请求级依赖中。
还要分别验证优雅关闭和启动失败:停止服务时应进入清理阶段;故意改错权重路径时,应用必须停留在启动失败状态,而不是继续提供一个无法推理的接口。
本课总结
- 模型应与 Web 进程同生命周期,启动时加载并预热,请求期间只复用
- GPU 服务优先控制单进程推理并发,增加 worker 会复制模型与显存占用
- 健康状态应在模型加载成功后才变为 ready,关闭时先删除引用再清理缓存
下一课预告
下一课将继续完善检测服务的工程化部署,重点处理容器镜像、依赖固化、健康检查与运行参数,使本地可用的接口能够稳定运行在服务器环境中。