
计算机视觉 / 系统课时
认识项目目录结构
认识项目目录结构
本课带你建立 YOLOv5 项目的目录地图,弄清训练、验证、推理、模型定义、数据配置和工具脚本分别放在哪里。完成后,你能从任务入口快速定位代码,而不是在仓库中盲目搜索。
学习目标
- 识别训练、验证和推理入口脚本的职责。
- 找到模型结构、数据配置与通用工具所在位置。
- 根据修改目标判断应查看哪个目录或文件。
先建立目录地图
YOLOv5 仓库可以按“入口脚本、模型定义、数据配置、通用工具”四层理解。入口脚本负责组织任务,models 描述网络,data 保存数据集与超参数配置,utils 提供加载、评估、日志和可视化等共享能力。
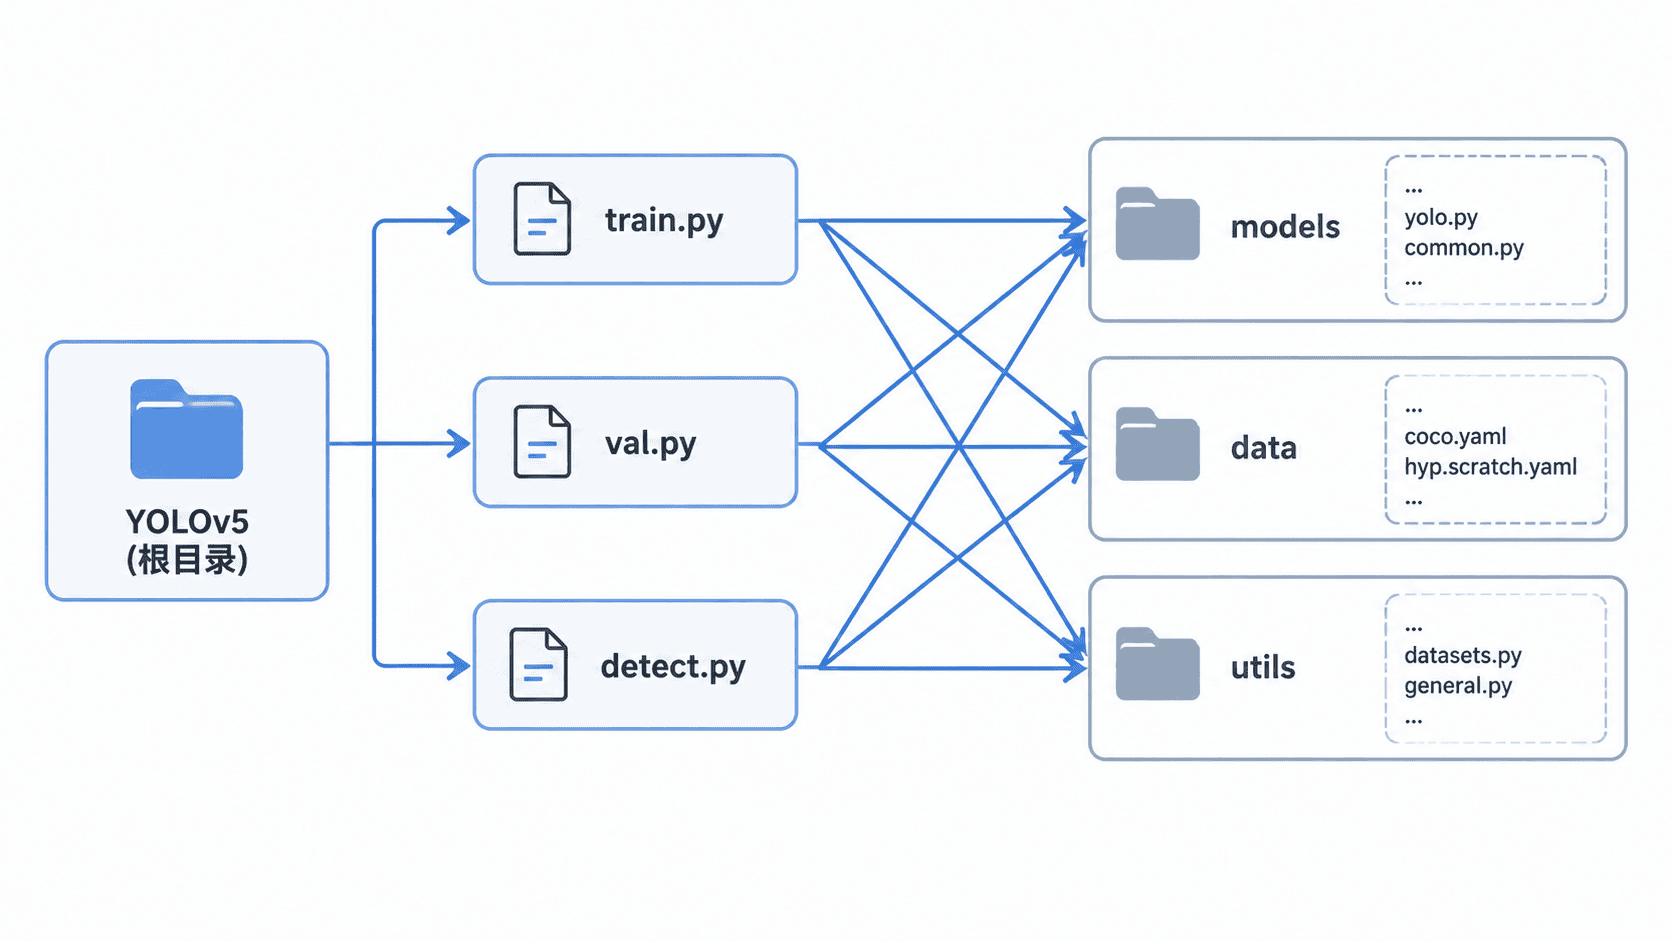
根目录中的脚本是最常用的任务入口。先从入口确认“正在做什么”,再沿导入关系进入模型或工具代码,通常比从底层文件反向追踪更高效。
认识三个主要入口
| 文件 | 主要职责 | 常见输入 | 主要结果 |
|---|---|---|---|
train.py |
组织训练循环、优化器、保存权重 | 数据配置、模型配置、预训练权重 | best.pt、last.pt、训练指标 |
val.py |
计算精确率、召回率和 mAP | 权重、验证集配置 | 指标与评估图表 |
detect.py |
对图片、视频或摄像头执行推理 | 权重、数据源、阈值 | 标注后的媒体与检测结果 |
这些脚本不是彼此替代的关系。训练过程中可以触发验证,但单独运行 val.py 更适合复测某个权重;detect.py 关注实际预测,不负责反向传播或更新参数。
找到模型、数据与工具代码
models 目录包含网络模块和模型配置解析逻辑。修改 Backbone、Neck、检测头或 YAML 网络结构时,应优先查看这里,而不是直接改训练循环。
data 目录通常保存数据集 YAML、类别名称、训练集与验证集路径,以及部分超参数配置。自定义数据集最常修改的是数据 YAML,而不是仓库中的 Python 源码。
utils 目录集中放置数据加载、通用计算、指标、绘图、日志和设备选择等功能。多个入口都可能调用这里,因此修改公共函数前要确认是否会同时影响训练、验证和推理。
下面的脚本可在仓库根目录运行,用于检查关键路径是否齐全。
from pathlib import Path

required = [
    "train.py",
    "val.py",
    "detect.py",
    "models",
    "data",
    "utils",
]

root = Path(".")
for item in required:
    status = "OK" if (root / item).exists() else "MISSING"
    print(f"{item:<12} {status}")
预期输出
train.py     OK
val.py       OK
detect.py    OK
models       OK
data         OK
utils        OK
若某项显示 MISSING,先确认当前目录是否真的是 YOLOv5 仓库根目录。不同版本可能增加其他文件,但这些核心入口和目录通常应存在。
按修改目标定位文件
准备训练自定义数据集时,先修改数据 YAML,再通过 train.py 传入配置。需要改变网络规模或层结构时,查看模型 YAML 与 models 中的解析代码。出现指标异常时,沿 val.py 进入指标计算;出现图片读取、坐标缩放或 NMS 问题时,再定位 utils 中对应函数。
不要直接在 utils 中大范围修改公共逻辑来“快速修复”单个问题。公共函数被多个入口复用,局部改动可能导致训练正常但推理异常,或不同图像尺寸下出现新的偏差。
本课总结
- 根目录入口脚本决定任务类型,
models、data、utils分别承担模型、配置和公共能力。 - 定位问题时应先确认入口,再沿调用关系查找底层实现。
- 修改共享工具前要评估它对训练、验证和推理的连带影响。
下一课预告
下一课将进入数据集制作流程,从业务目标出发定义检测类别,并明确类别边界与容易混淆的标注情况。