
大模型原理与训练 / 系统课时
从单头扩展到多头注意力
从单头扩展到多头注意力
单头注意力只能用一张注意力分布决定“当前词该看谁”。多头注意力把表示空间切成多个较小子空间,每个头独立计算注意力,再把结果拼回统一表示,使同一位置可以并行建立多种关系,而不是被一张概率图限制。
学习目标
- 说清多头注意力的投影、切分、并行计算与拼接流程
- 用张量形状追踪每个头如何处理不同表示子空间
- 理解多头为何比单个更宽的注意力拥有更多关系建模方式
多头不是把一张注意力矩阵切几块
输入隐藏状态记为 ,形状是 。标准多头注意力先通过三组线性投影得到 、、,再把最后一维重排为 个头。若每个头维度为 ,通常满足 。
真正被“切分”的主要是特征维度,而不是序列位置。每个头仍能看到全部 个位置,只是使用不同的投影参数和较小的特征子空间,因此会得到自己独立的注意力分数矩阵。
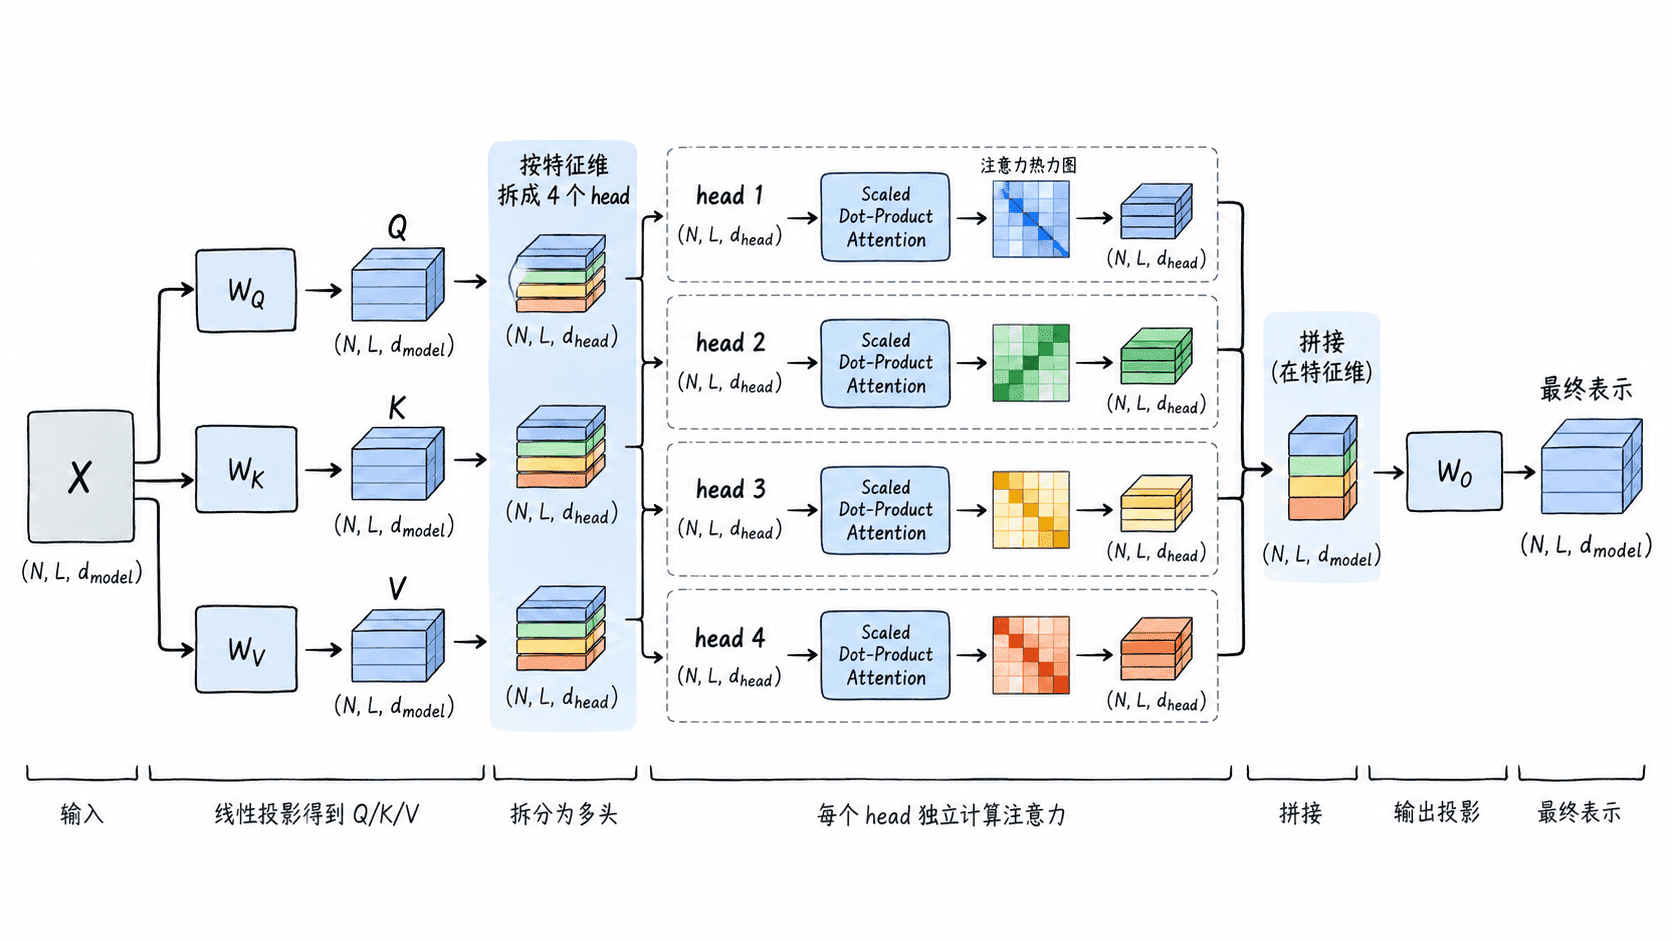
用形状追踪切分与拼接
设批量大小 、序列长度 、模型维度 ,使用 个头,则每个头的维度 。形状变化可以按下面的顺序理解:
| 阶段 | 张量形状 | 含义 |
|---|---|---|
| 输入 | 每个词元有 8 维表示 | |
| 投影后的 | 各为 | 为注意力生成三类表示 |
| 切成 2 个头 | 各为 | 头维被单独拿出来 |
| 每头分数矩阵 | 每个头都有自己的 关系图 | |
| 拼接各头输出 | 恢复模型维度 | |
| 输出投影后 | 混合各头信息供后续层使用 |
每个头内部仍使用缩放点积注意力:先计算 ,再经过 Softmax 得到权重,并对 加权求和。自回归模型中,各头通常共享同一种因果可见范围,但因为 、 的投影不同,最终注意力图仍可能完全不同。
为什么多个头能学习不同关系
如果只有一个头,某个 Query 对所有 Key 只能产生一组归一化概率。它可以同时给多个位置分配权重,但这些关系都被压在同一张注意力图里。
多头机制则让每个头拥有独立的投影和 Softmax。一个头可能更偏向局部相邻词,另一个头可能跨越较长距离,还有的头会围绕特定语法或指代模式形成稳定关注。这里的“可能”很重要:模型并没有预先规定某个头必须负责语法、实体或位置关系,这些分工是在训练中涌现出来的,而且不同头之间也可能存在冗余。
多头的价值因此不是简单增加“看得更远”的能力,而是提供多套彼此独立的匹配空间。它让同一个词元可以同时依据不同相似性标准,从序列中收集多种证据。
参数量与计算并不会按头数直接翻倍
在标准设计里,、、 的总体输出维度仍然是 ,只是之后被重排为多个头。因此固定 时,把 1 个头改成 8 个头,并不意味着 Q、K、V 投影参数变成 8 倍。
变化主要发生在计算组织方式:每个头的特征维度更小,但会生成独立的注意力矩阵。总注意力计算量的主阶仍与 同级,所以增加头数本身通常不会改变注意力关于序列长度的平方复杂度。
判断自己是否真正理解多头
可以用一句话检验:每个头都看完整序列,但在不同投影子空间里独立决定该关注谁,最后再把各头结果合并。 如果把多头理解成“把句子切成几段分别处理”,或“把同一张注意力矩阵复制多份”,就抓错了核心。
从结构上看,多头注意力的完整链路就是投影、按头重排、并行注意力、拼接、输出投影。理解这条信息流后,再阅读任何 Transformer 实现中的 num_heads、head_dim、reshape、transpose 与 concat 操作,都会更容易对上它们各自承担的角色。