
大模型原理与训练 / 系统课时
用 MoE 扩展容量控制计算
用 MoE 扩展容量控制计算
如果把稠密 Transformer 的前馈网络不断做大,每个词元都会经过全部参数,模型容量和计算量会一起上涨。MoE 把一层前馈网络拆成多个“专家”,再让路由器只为当前词元选择少数专家,从而让总参数量大幅增加,而单个词元只激活其中一小部分。
学习目标
- 理解路由器、专家、Top-k 选择和加权合并之间的工作关系。
- 区分模型的总参数量、激活参数量与单词元计算量。
- 识别专家负载不均、容量限制和通信开销这些关键工程边界。
从稠密前馈层到专家集合
普通 Transformer 中,注意力层之后通常接一个前馈网络 FFN。稠密 FFN 的特点是:无论输入词元是什么,它都会经过同一套参数。想扩大容量时,增加隐藏维度就会让每个词元都承担更多乘加计算。
MoE 把这一套 FFN 替换为多个结构相同但参数独立的专家。例如一层有 64 个专家,每个专家都可以看作一个独立 FFN。模型因此拥有更多可学习参数,但关键变化在于:每个词元不需要访问全部 64 个专家。
路由器怎样选择专家
词元进入 MoE 层后,先经过一个很小的路由器。路由器根据当前词元表示,为每个专家产生一个分数,然后执行 Top-k 选择。若采用 Top-2 路由,每个词元只送往得分最高的两个专家。
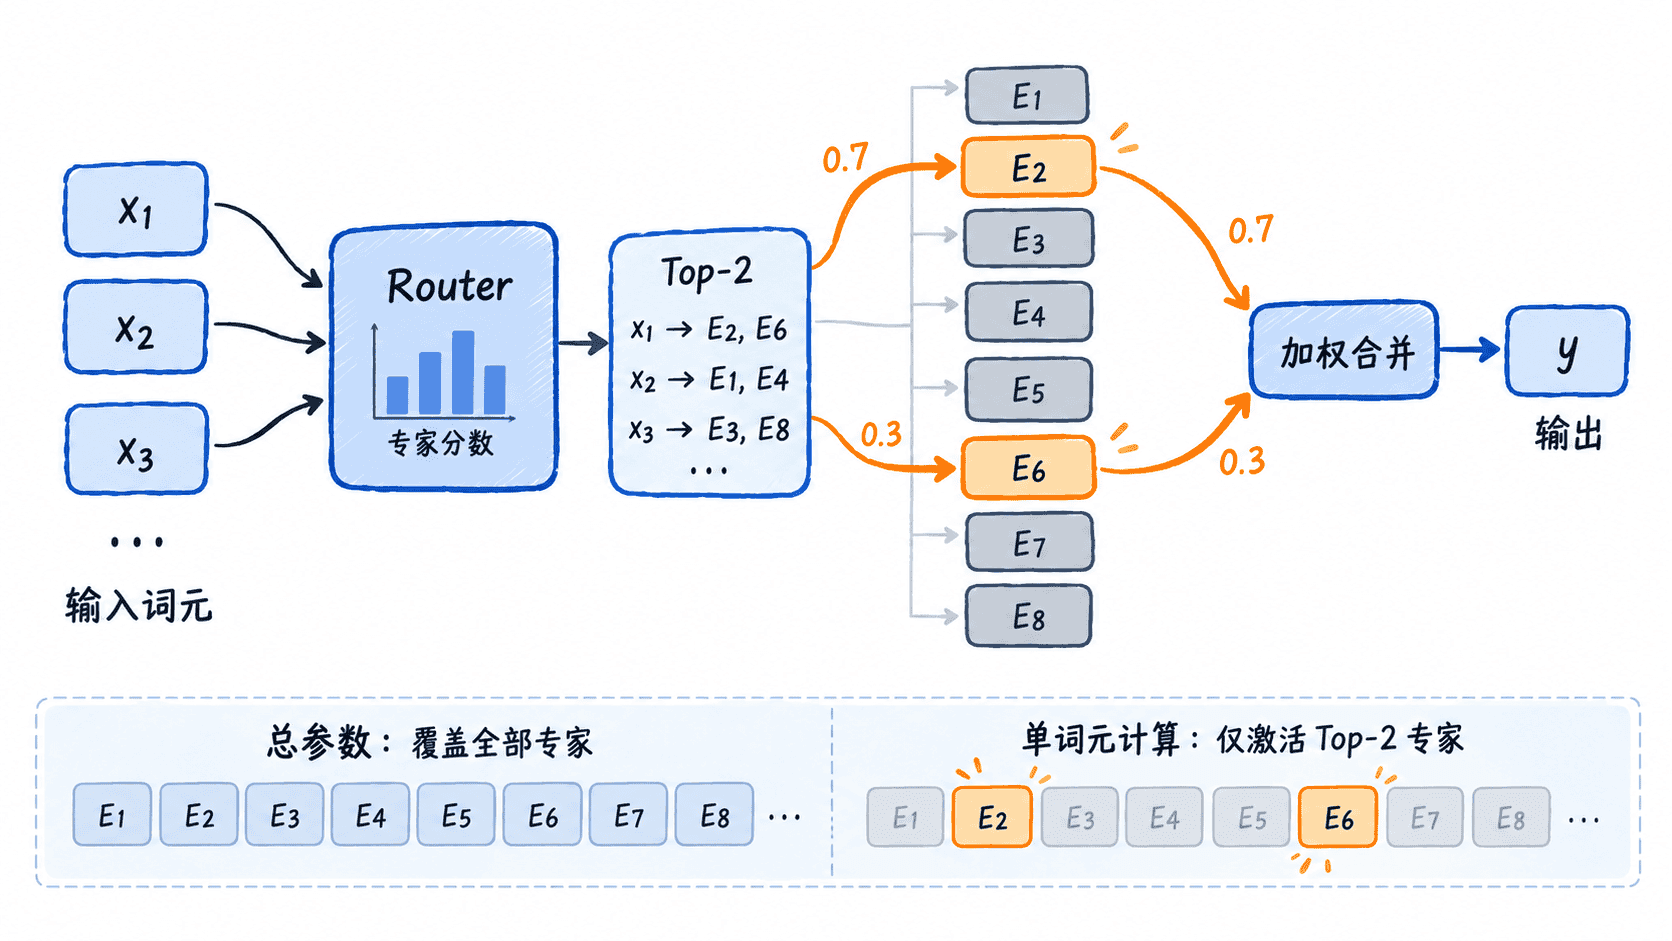
设路由器给某个词元选中了专家 3 和专家 7,并得到权重 0.7 与 0.3。两个专家分别处理同一个词元表示,最后将输出按路由权重合并。其他专家对这个词元不参与前向计算,但它们可能会处理同一批次中的其他词元。
因此,MoE 的“稀疏”发生在专家激活层面,而不是说整个模型只有少量参数参与工作。注意力层、归一化层等通常仍是稠密计算。
总参数量和实际计算量要分开看
假设一个 MoE 层有 64 个专家,采用 Top-2 路由。这个层的专家参数总量大约是单个专家的 64 倍,但单个词元只调用 2 个专家,所以专家部分的激活参数只是总专家参数的一小部分。
| 维度 | 稠密 FFN | Top-2 MoE |
|---|---|---|
| 可学习容量 | 一套 FFN 参数 | 多套专家参数 |
| 单词元激活 | 全部 FFN 参数 | 仅 2 个专家 |
| 扩大总参数后的计算增长 | 通常同步增长 | 可明显慢于总参数增长 |
| 主要新成本 | 大矩阵计算 | 路由、通信与负载均衡 |
为什么还需要负载均衡
如果路由器总把大量词元送到少数几个专家,热门专家会拥塞,其他专家却几乎学不到东西。训练系统因此通常会加入负载均衡目标或路由约束,让词元更均匀地分散到不同专家。
分布式训练时,专家还常被放到不同设备上。一个词元被路由到远端专家,就需要发生跨设备数据交换。此时 MoE 的瓶颈不只在算力,还会落到网络带宽、专家并行布局和批次中词元分布上。
有些实现还会设置专家容量:单个专家在一个批次内最多接收一定数量的词元。超过容量后,系统可能丢弃、改派或采用无丢弃策略,不同实现行为并不完全相同。
什么时候 MoE 最有价值
MoE 适合“希望模型记住和表达更多模式,但又不能让每个词元都付出等比例计算”的场景。它用稀疏激活把参数容量和单词元计算部分解耦,因此可以把模型做得很大,同时控制每次前向传播实际启用的专家数量。
代价是系统复杂度明显提高:路由器必须学会分工,专家负载要保持平衡,多设备之间还要高效交换词元。理解 MoE 时应始终分开看三个量:总参数量决定容量上限,激活专家数决定专家部分的单词元计算,通信与路由效率决定这些理论收益能否真正兑现。