
大模型原理与训练 / 系统课时
看懂参数如何被反向更新
看懂参数如何被反向更新
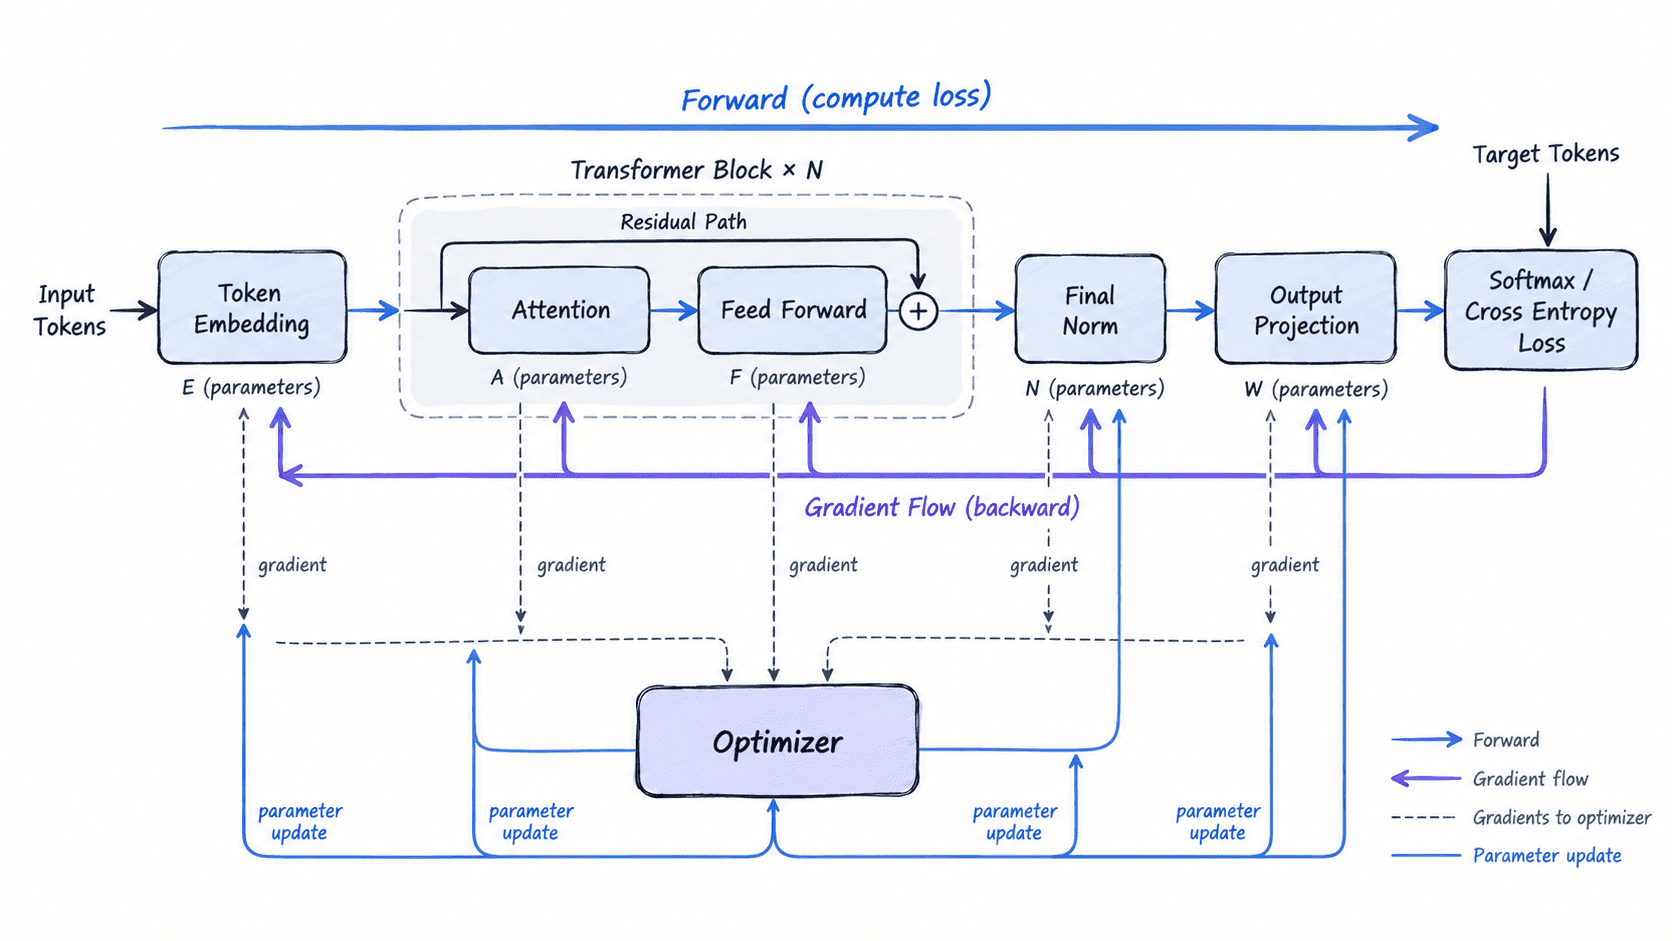
训练 GPT 时,损失并不是只改最后一层。一次反向传播会把“预测错了多少”逐层传回输出投影、前馈层、注意力层和词嵌入,让所有参与当前计算图的参数按各自梯度共同更新。理解这条链路,就能把损失下降与模型内部参数变化对应起来。
学习目标
- 说清损失、梯度与参数更新之间的关系
- 沿 GPT 的计算链路判断梯度会流向哪些参数
- 区分“梯度被计算”与“参数已经更新”两个阶段
从一个 token 的损失开始
假设输入前缀经过 GPT 后得到下一 token 的 logits,再经 softmax 形成概率分布。训练标签指出真实 token,交叉熵损失会对“真实 token 概率过低”施加惩罚。
这里的损失只是一个标量,但它依赖整条前向计算链:输出 logits 依赖最后一层隐藏状态,隐藏状态依赖多层注意力和前馈网络,而最初的隐藏状态又来自 token embedding 与 position information。只要某个参数参与了这次前向计算,损失就可能对它产生梯度。
梯度如何穿过整套模型
反向传播本质上是链式法则。若损失 L 依赖中间量 h,而 h 又依赖参数 w,那么框架会把“损失对 h 的敏感度”和“h 对 w 的敏感度”相乘,得到 w 的梯度。
在 Transformer Block 中,梯度会沿残差连接分流:一部分直接穿过残差路径,另一部分进入 Attention 或 Feed Forward 子层。进入注意力后,它还会继续影响生成 Q、K、V 的投影矩阵以及输出投影;进入前馈层后,则会影响其中的线性层参数。
因此,不要把“某层离损失更远”理解成“它不会被更新”。距离更远只意味着梯度需要经过更多运算。真正决定某参数是否得到梯度的是:它是否处在当前损失对应的计算图中,以及中间运算是否允许梯度继续传播。
梯度不是参数更新
一次训练迭代通常有两个明确阶段。先执行反向传播,计算并累积每个参数的 grad;再由优化器读取这些梯度,根据学习率和优化算法修改参数值。
最简单的梯度下降可以理解为:new_parameter = old_parameter - learning_rate * gradient。若某参数梯度为正,更新会把参数向更小方向移动;若梯度为负,则向更大方向移动。AdamW 等优化器会额外维护动量和二阶统计量,但仍然是利用梯度决定更新方向和步幅。
例如某权重当前为 0.50,梯度为 0.20,学习率为 0.01,最简单的更新后得到 0.498。这说明梯度描述“往哪个方向改、局部变化有多敏感”,学习率控制这次实际走多远。
为什么嵌入、注意力和前馈层会一起变
同一个 token 的损失会同时依赖多类参数。Embedding 决定输入表示,Attention 决定当前位置从上下文取什么信息,Feed Forward 负责对每个位置的表示做非线性变换,输出投影则把最终隐藏状态映射回词表空间。
训练不是轮流只调一层,而是一次反向传播为所有相关参数计算梯度,一次优化器步骤再共同更新它们。不同参数收到的梯度大小可能差异很大,因此“共同更新”并不意味着“改变量相同”。
用三步检查一次训练迭代
观察训练代码时,可以按固定顺序判断参数究竟发生了什么:先确认前向计算产生损失,再确认反向传播后目标参数出现梯度,最后确认优化器步骤后参数值改变。若只看到损失下降,不能直接证明每一层都在正常更新。
把这条证据链建立起来后,就能把 GPT 训练理解成一个闭环:前向计算产生预测,损失衡量误差,反向传播把误差信号分配给整套参数,优化器再把这些梯度转换为实际参数变化。