
大模型原理与训练 / 系统课时
从损失曲线识别训练问题
从损失曲线识别训练问题
损失曲线不是“越低越好”的单一指标,而是一条训练诊断信号。把训练损失与验证损失放在一起看,可以快速区分欠拟合、过拟合、震荡和发散,并据此决定该继续训练、改学习率,还是先检查数据与数值稳定性。
学习目标
- 根据训练损失与验证损失的相对走势识别四类常见问题。
- 按“先看趋势、再看间隙、最后看波动”的顺序完成诊断。
- 为不同异常选择优先级明确的修复动作,并用下一轮曲线验证是否生效。
先建立可比较的诊断基线
单看某个 step 的 loss 没有意义。训练损失反映模型对训练样本的拟合程度,验证损失反映这种能力能否迁移到未参与梯度更新的数据。真正有诊断价值的是两条曲线随时间的趋势、二者之间的间隙,以及短周期波动是否持续放大。
开始训练前先固定三件事:验证集切分不变、loss 统计口径一致、横轴统一为 step 或消耗的 token 数。若训练曲线按每个 step 记录,而验证曲线按不规则间隔记录,也应在图上明确验证点的位置,避免把采样频率差异误判成震荡。
用三步顺序读曲线
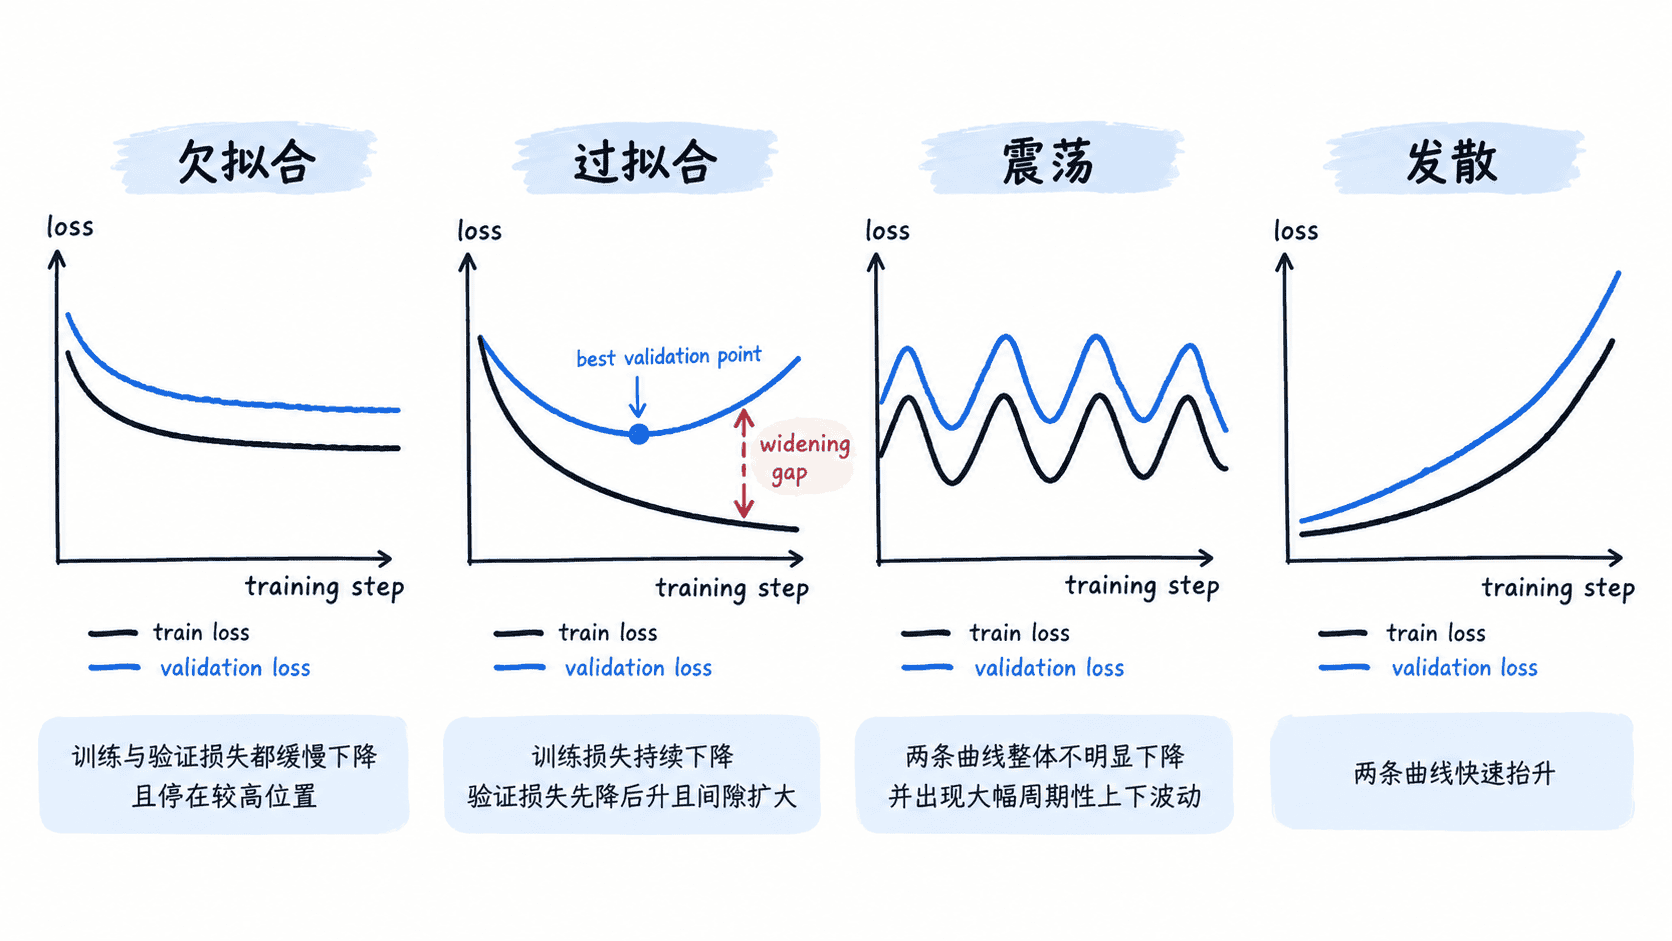
先看长期趋势。如果训练损失和验证损失都下降,优化至少在工作;如果二者长期都停在高位,优先怀疑欠拟合;如果二者一起快速上升,优先按发散处理。
再看泛化间隙。训练损失继续下降而验证损失反弹,且二者差距持续扩大,是过拟合的典型信号。验证损失的最低点往往比训练结束点更有价值,它可作为早停或选择 checkpoint 的候选位置。
最后看短周期波动。训练损失上下剧烈摆动、验证损失也不稳定,但长期没有改善,通常属于震荡。高学习率、过小 batch、梯度异常或数据批次差异都可能造成这种形态,不能只凭一次尖峰下结论。
| 形态 | 训练损失 | 验证损失 | 优先检查 |
|---|---|---|---|
| 欠拟合 | 下降有限或较早进入高位平台 | 同样较高,且与训练曲线接近 | 训练步数、模型容量、学习率是否过小、数据是否过难 |
| 过拟合 | 持续下降 | 先下降后回升,间隙扩大 | 训练时长、数据量与质量、正则化、早停 |
| 震荡 | 大幅上下波动 | 通常也不稳定 | 学习率、batch、梯度范数、异常样本 |
| 发散 | 快速升高,可能出现非有限值 | 同步恶化或失去参考意义 | 学习率、数值溢出、数据异常、实现错误 |
用最小脚本复现诊断逻辑
下面的脚本用几组人为构造的曲线演示诊断顺序。阈值只是教学用启发式规则,真实训练应结合模型规模、平滑窗口、历史实验和梯度指标设定。
cases = {
    "case_a": ([3.0, 2.9, 2.8, 2.75, 2.7], [3.1, 3.0, 2.9, 2.85, 2.8]),
    "case_b": ([3.0, 2.4, 1.9, 1.5, 1.2], [3.1, 2.5, 2.1, 2.2, 2.4]),
    "case_c": ([3.0, 2.2, 2.9, 2.1, 2.8], [3.1, 2.4, 3.0, 2.3, 2.9]),
    "case_d": ([3.0, 3.3, 3.8, 4.6, 5.7], [3.1, 3.4, 4.0, 4.9, 6.2]),
}

def classify(train, valid):
    if train[-1] > train[0] and valid[-1] > valid[0]:
        return "发散"

    train_progress = (train[0] - train[-1]) / train[0]
    gap = valid[-1] - train[-1]

    if valid[-1] > min(valid) and gap > 0.8:
        return "过拟合"

    train_range = max(train[-4:]) - min(train[-4:])
    if train_range > 0.6:
        return "震荡"
    if train_progress < 0.15:
        return "欠拟合"

    return "正常收敛"

for name, (train, valid) in cases.items():
    print(f"{name}: {classify(train, valid)}")
预期输出
case_a: 欠拟合
case_b: 过拟合
case_c: 震荡
case_d: 发散
这段代码的价值不是替代人工读图,而是把诊断顺序显式化:先排除发散,再判断训练进展,再观察泛化间隙,最后检查波动。生产监控中可以把同样的思路扩展成滑动平均、斜率和告警阈值。
把曲线形态映射到修复动作
欠拟合时不要先加正则化。应先确认训练是否足够、学习率是否过小、模型容量是否明显不足;如果训练和验证损失都在稳定下降,只是还没到平台,最简单的动作可能只是继续训练。
过拟合时应优先保留验证损失最低附近的 checkpoint,再决定是否增加高质量数据、减少训练轮次或加强正则化。若训练数据本身含有重复、泄漏或分布偏差,单纯提高 dropout 往往治标不治本。
震荡首先检查学习率与梯度范数。若降低学习率后波动明显收敛,说明优化步长可能过激;如果只有特定 batch 触发尖峰,则应回看样本长度、异常 token、数据清洗和 batch 组成。
发散要优先保护实验,而不是继续“观察几百步”。应立即检查非有限 loss、混合精度溢出、梯度爆炸、错误的 loss 缩放以及学习率调度。修复后重新运行时,至少要验证前若干百个 step 的曲线重新出现稳定下降趋势。
用下一轮实验验证诊断
任何诊断都要通过“只改一个主要变量”的对照实验确认。例如怀疑学习率过高,就先降低峰值学习率,其余配置尽量保持不变;若震荡幅度明显缩小且验证损失继续下降,才说明判断获得了实验支持。
最终应把“曲线形态—假设—修复—复跑结果”记录成可重复的诊断基线。这样规模扩大后遇到同类异常时,团队看到的就不只是“loss 不对”,而是一套可以快速缩小问题范围的证据链。