
大模型原理与训练 / 系统课时
拆开 Prefill 与 Decode
拆开 Prefill 与 Decode
一次大模型生成并不是从头到尾都以同一种方式计算。提示词进入模型时会被成批处理,生成开始后却必须按词元逐步推进。把 Prefill 与 Decode 拆开,就能解释为什么首词延迟和后续单词元延迟呈现出完全不同的性能特征。
学习目标
- 区分 Prefill 与 Decode 各自在一次生成请求中的职责
- 理解 TTFT 与 TPOT 分别受哪些计算特征影响
- 能根据提示词长度和输出长度判断延迟主要来自哪一阶段
一次生成为什么有两种速度
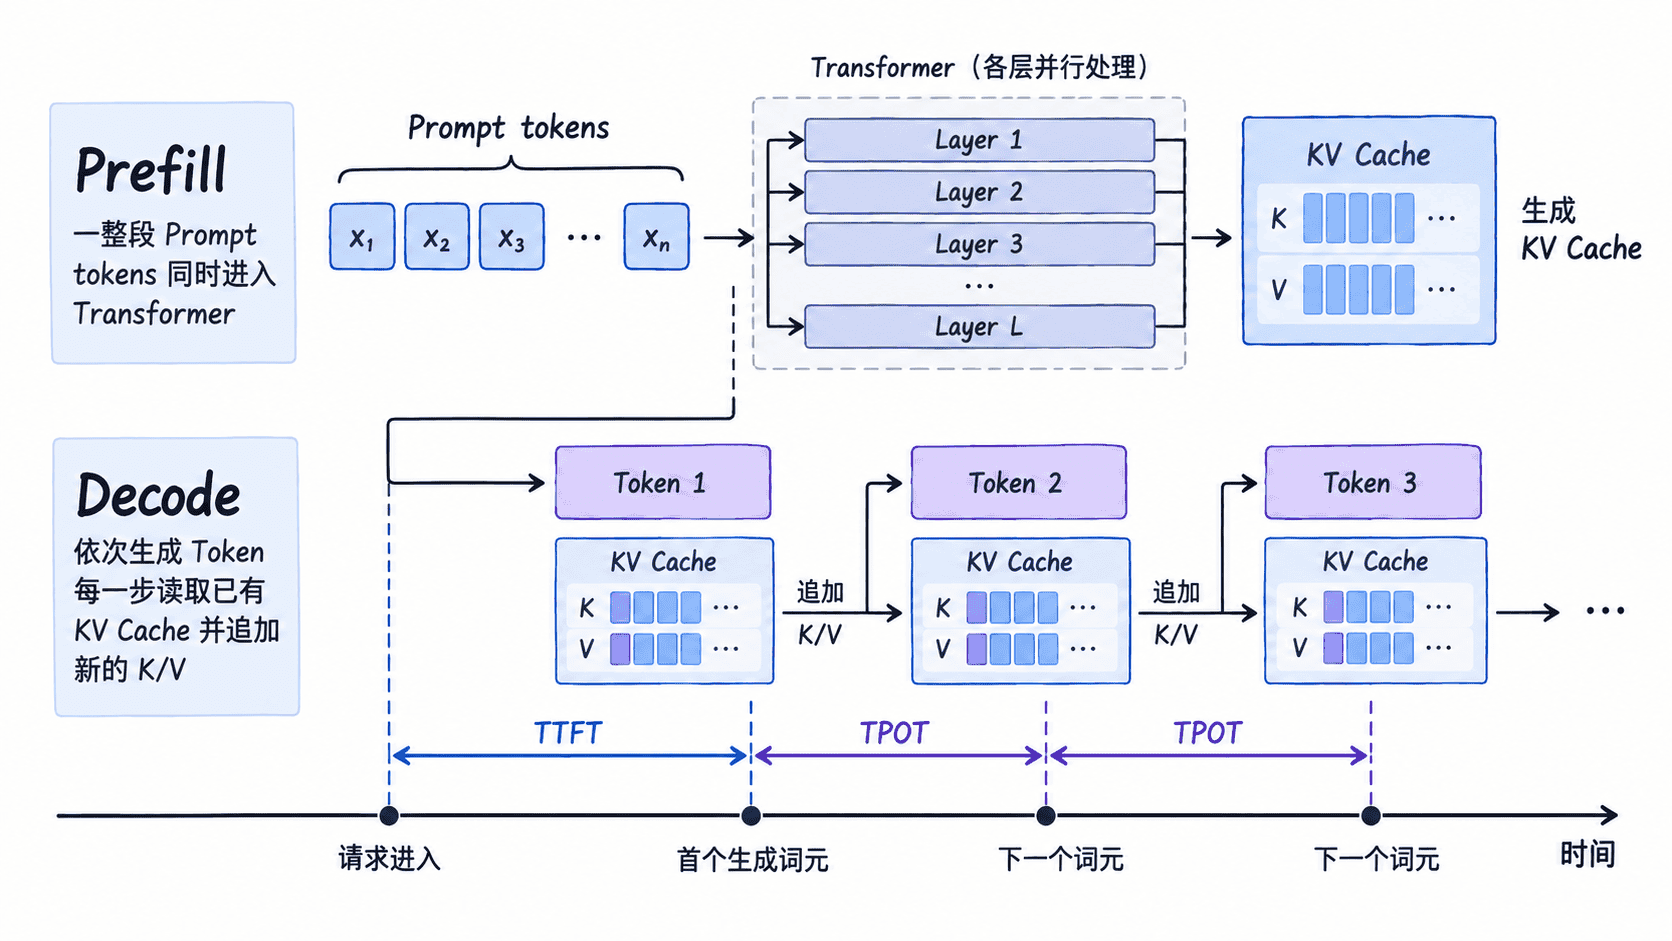
假设提示词已经有 2000 个词元,模型准备再生成 100 个词元。前 2000 个词元是已知输入,可以一次送入各层 Transformer;而第 2001 个词元生成出来之前,第 2002 个词元并不存在,因此后续输出天然具有串行依赖。
这就把一次请求分成两个阶段:Prefill 负责消化整段提示词并建立后续生成需要的中间状态;Decode 从第一个待生成词元开始,每轮只向前推进一个词元,直到遇到停止条件。
Prefill 更像大批量矩阵计算
在 Prefill 中,提示词的所有位置都已知。以一层自注意力为例,模型可以同时为整段输入计算 Q、K、V,并完成大量矩阵乘法。虽然因果掩码仍要求每个位置只能看见自己及之前的词元,但这不会阻止硬件对不同位置进行并行计算。
提示词越长,Prefill 需要处理的词元越多,注意力相关计算也会迅速增加。它通常具有较高的并行度和算术强度,GPU 更容易把大量计算单元持续喂满。因此,Prefill 的主要感受体现在首词延迟:在首个输出词元出现前,整段提示词必须先被处理。
Decode 为什么更容易受访存限制
Decode 的第一个输出词元产生后,下一轮只能处理这个新词元。模型不再重新计算全部历史位置,而是让当前词元的 Query 与历史缓存中的 Key、Value 做注意力计算,再得到下一个词元的概率分布。
单轮 Decode 的计算规模比一次完整 Prefill 小得多,但每一轮都要读取多层历史 KV Cache,而且轮与轮之间不能完全并行。因此硬件往往不是缺少算力,而是频繁等待显存中的权重和缓存数据搬运。输出越长,这种逐词元迭代就会重复越多次。
| 阶段 | 每轮处理对象 | 并行特征 | 常见性能关注点 |
|---|---|---|---|
| Prefill | 整段提示词 | 同一请求内可高度并行 | TTFT、长提示词吞吐 |
| Decode | 当前新增的 1 个词元 | 时间步之间串行 | TPOT、显存带宽、KV Cache 读取 |
用 TTFT 与 TPOT 看请求
TTFT(Time To First Token)描述从请求开始到首个输出词元可用的时间。它不仅包含模型的 Prefill,还可能包含排队、调度和采样等服务开销;在其他条件相近时,提示词变长通常会让 Prefill 占比上升。
TPOT(Time Per Output Token)描述进入稳定生成阶段后,相邻输出词元之间的平均时间,更直接反映 Decode 的单步效率。一个系统可能 TTFT 很低但 TPOT 偏高,也可能长提示词导致 TTFT 较高而短回答的总时延仍可接受。
判断优化方向时,应先看请求究竟是“长输入、短输出”还是“短输入、长输出”。前者更值得关注 Prefill 吞吐和首词延迟,后者则更依赖 Decode 的单词元效率、显存带宽以及 KV Cache 的管理。