
大模型原理与训练 / 系统课时
用采样参数控制生成风格
用采样参数控制生成风格
语言模型每一步都会得到一组“下一个词元”的候选概率,采样参数决定这组概率是更集中、更截断,还是保留更多低概率候选。本篇用同一组 logits 观察 temperature、top-k 与 top-p 的作用,并把参数变化与稳定性、多样性和随机性对应起来。
学习目标
- 解释 temperature 如何改变概率分布的尖锐程度
- 区分 top-k 的固定候选数与 top-p 的动态概率质量截断
- 根据生成目标判断参数变化会让输出更稳定还是更多样
参数控制的是下一个词元分布
自回归模型先输出每个候选词元的 logits,再把它们转换成概率并选择下一个词元。采样参数不会改变模型已经学到的知识,它们改变的是从当前候选中如何选择,因此主要影响重复性、发散程度和低概率词元被选中的机会。
可以把三类参数理解为两步:temperature 先重塑概率差距,top-k 与 top-p 再限制允许进入抽样池的候选集合。不同推理框架的具体执行顺序可能略有差异,但这种“重塑分布,再筛候选”的心智模型足以解释主要现象。
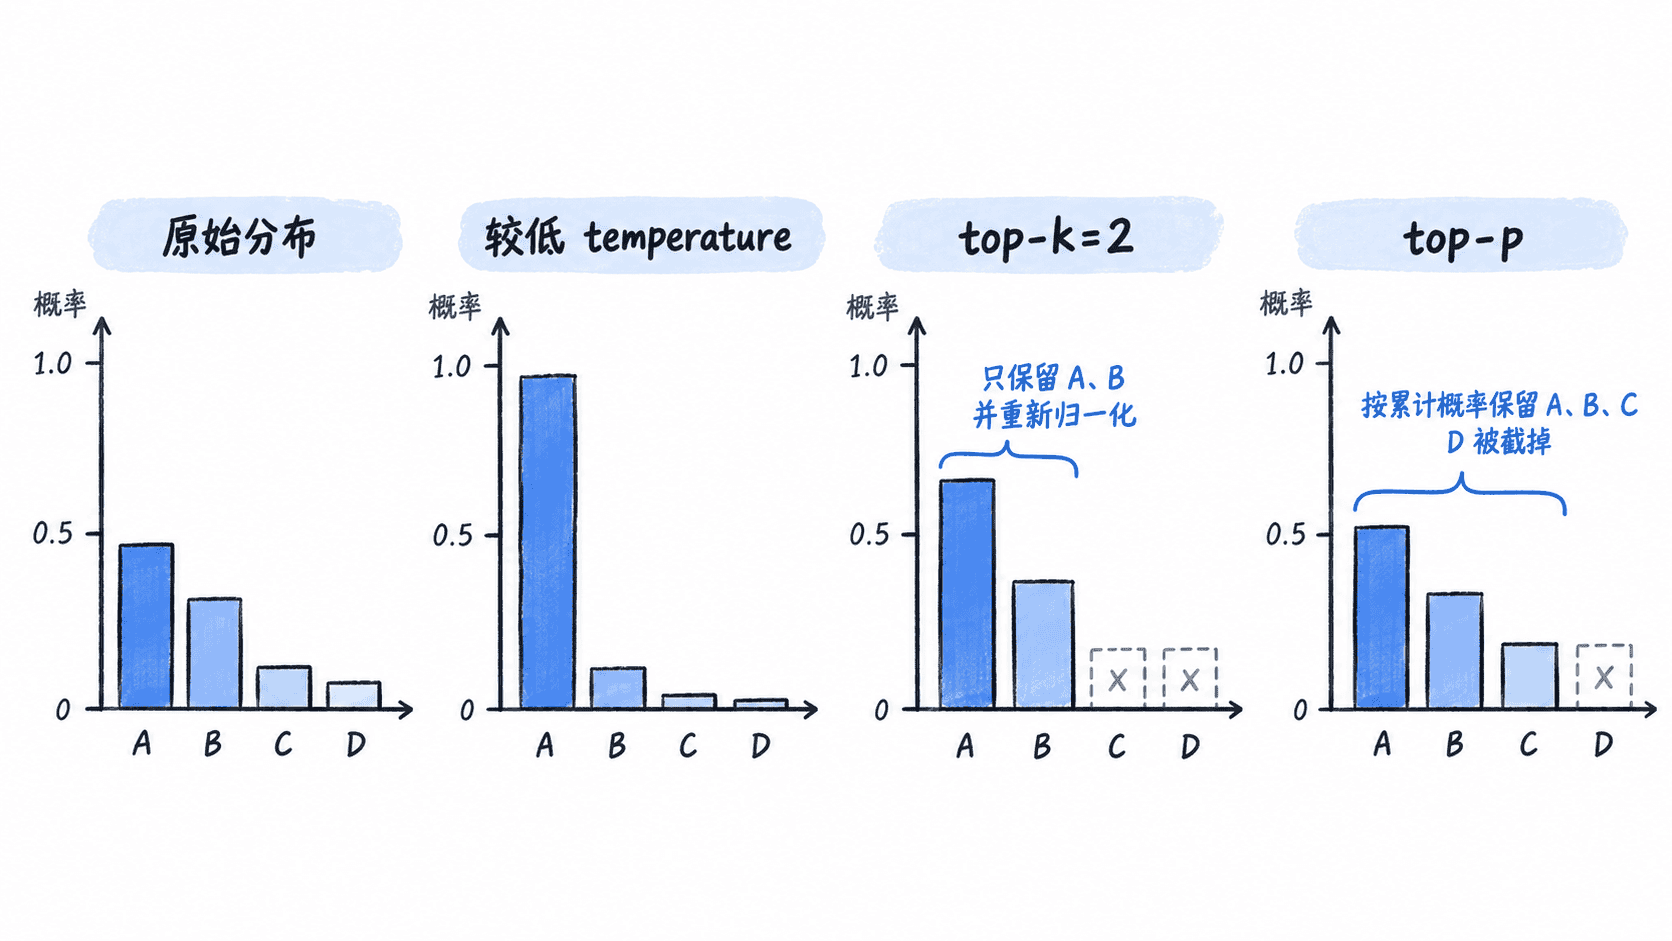
temperature 调整分布尖锐程度
当 temperature 为 1 时,概率比例保持原样。小于 1 时,高 logit 会被进一步放大,分布变尖,模型更常选择高概率候选;大于 1 时,概率差距被压平,低概率候选获得更多机会,输出通常更有变化,但也更容易偏离最可能的续写。
temperature 不能简单理解成“创造力旋钮”。它只改变当前分布的相对差距;如果模型本来就对某个候选极度确定,即使升高 temperature,也不一定产生明显多样性。数学公式中的 temperature 不能直接取 0,一些 API 会把 0 作为贪心或近确定性解码的特殊配置,具体语义要看实现。
top-k 与 top-p 剪掉候选
top-k 每一步只保留概率最高的 k 个候选,所以候选数固定。k 越小,随机性通常越低;但当概率分布很平时,固定的 k 可能裁掉仍然合理的词元。
top-p 又称 nucleus sampling。它从高概率词元开始累加,保留累计概率首次达到阈值 p 所需的最小集合,因此候选数会随上下文变化。分布很尖时可能只留下少数候选,分布较平时则会自动保留更多候选。
如果同时启用 top-k 和 top-p,最终候选通常需要同时通过两类过滤;具体先后顺序、最少保留词元数等细节由推理实现决定。
用代码观察同一分布的变化
下面的可运行 Python 示例固定四个词元的 logits,不进行随机抽样,只计算不同参数下的最终概率,因此每次运行结果一致。
import math

tokens = ["A", "B", "C", "D"]
logits = [3.0, 2.0, 1.0, 0.0]

def normalize(values):
    total = sum(values)
    return [v / total for v in values]

def softmax(values, temperature=1.0):
    # temperature 只重缩放 logits,不改变候选的排序。
    scaled = [v / temperature for v in values]
    peak = max(scaled)
    # 减去最大值可避免指数运算出现不必要的数值溢出。
    return normalize([math.exp(v - peak) for v in scaled])

def top_k(probs, k):
    keep = set(
        sorted(range(len(probs)), key=probs.__getitem__, reverse=True)[:k]
    )
    return normalize([p if i in keep else 0.0 for i, p in enumerate(probs)])

def top_p(probs, threshold):
    # top-p 按概率从高到低累加,因此保留的候选数不是固定值。
    order = sorted(range(len(probs)), key=probs.__getitem__, reverse=True)
    keep = set()
    cumulative = 0.0
    for i in order:
        keep.add(i)
        cumulative += probs[i]
        if cumulative >= threshold:
            break
    return normalize([p if i in keep else 0.0 for i, p in enumerate(probs)])

def show(name, probs):
    values = " ".join(f"{t}:{p:.3f}" for t, p in zip(tokens, probs))
    print(f"{name:<10} {values}")

base = softmax(logits)
show("base", base)
show("T=0.7", softmax(logits, 0.7))
show("T=1.5", softmax(logits, 1.5))
show("top-k=2", top_k(base, 2))
show("top-p=0.9", top_p(base, 0.9))
预期输出
base       A:0.644 B:0.237 C:0.087 D:0.032
T=0.7      A:0.763 B:0.183 C:0.044 D:0.010
T=1.5      A:0.523 B:0.268 C:0.138 D:0.071
top-k=2    A:0.731 B:0.269 C:0.000 D:0.000
top-p=0.9  A:0.665 B:0.245 C:0.090 D:0.000
结果里,较低 temperature 把概率进一步集中到 A;较高 temperature 让 B、C、D 获得更多概率。top-k=2 固定只留下 A、B,而 top-p=0.9 根据累计概率保留 A、B、C,展示了两种截断方式的关键差异。
根据目标组合参数
| 目标 | temperature 倾向 | top-k / top-p 倾向 | 主要取舍 |
|---|---|---|---|
| 稳定、低随机性的事实型输出 | 较低 | 更严格过滤 | 多样性下降,重复性提高 |
| 一般对话与解释 | 中等 | 保留适度候选 | 在稳定性与变化之间平衡 |
| 头脑风暴或开放式创作 | 较高 | 放宽候选集合 | 多样性增加,也更可能跑偏 |
调参时最好一次只改变一个维度并观察结果,否则很难判断变化来自哪里。先用 temperature 控制分布尖锐程度,再用 top-k 或 top-p 管理候选集合,通常比同时大幅调整三个参数更容易获得可解释的生成行为。