
大模型原理与训练 / 系统课时
把文本切成模型可读的词元
把文本切成模型可读的词元
语言模型不能直接计算一串自然语言字符。真正送入模型的是有限词表中的整数 ID。本篇从同一段文本的不同切分方式出发,弄清字符、子词、词元和词元 ID 的关系,并判断分词粒度为什么会同时改变序列长度与词表规模。
学习目标
- 区分字符、子词、词元与词元 ID,理解文本变成整数序列的过程。
- 解释分词粒度对序列长度、词表规模和未知文本处理能力的影响。
- 能根据一组词元表手工完成从文本切分到 ID 序列的转换。
从文本到整数序列
模型处理的基本单位通常称为 token(词元)。词元不一定等于一个汉字或一个完整单词,它可以是字符、常见单词、单词片段,甚至特殊控制符。Tokenizer 的职责就是先把文本切成词元,再通过词表把每个词元映射成整数 ID。
例如,文本 learning 可以按字符切成 l、e、a 等多个词元,也可以被某个子词词表切成 learn 和 ing。两种结果表达的是同一段文字,但送入模型的序列长度已经不同。
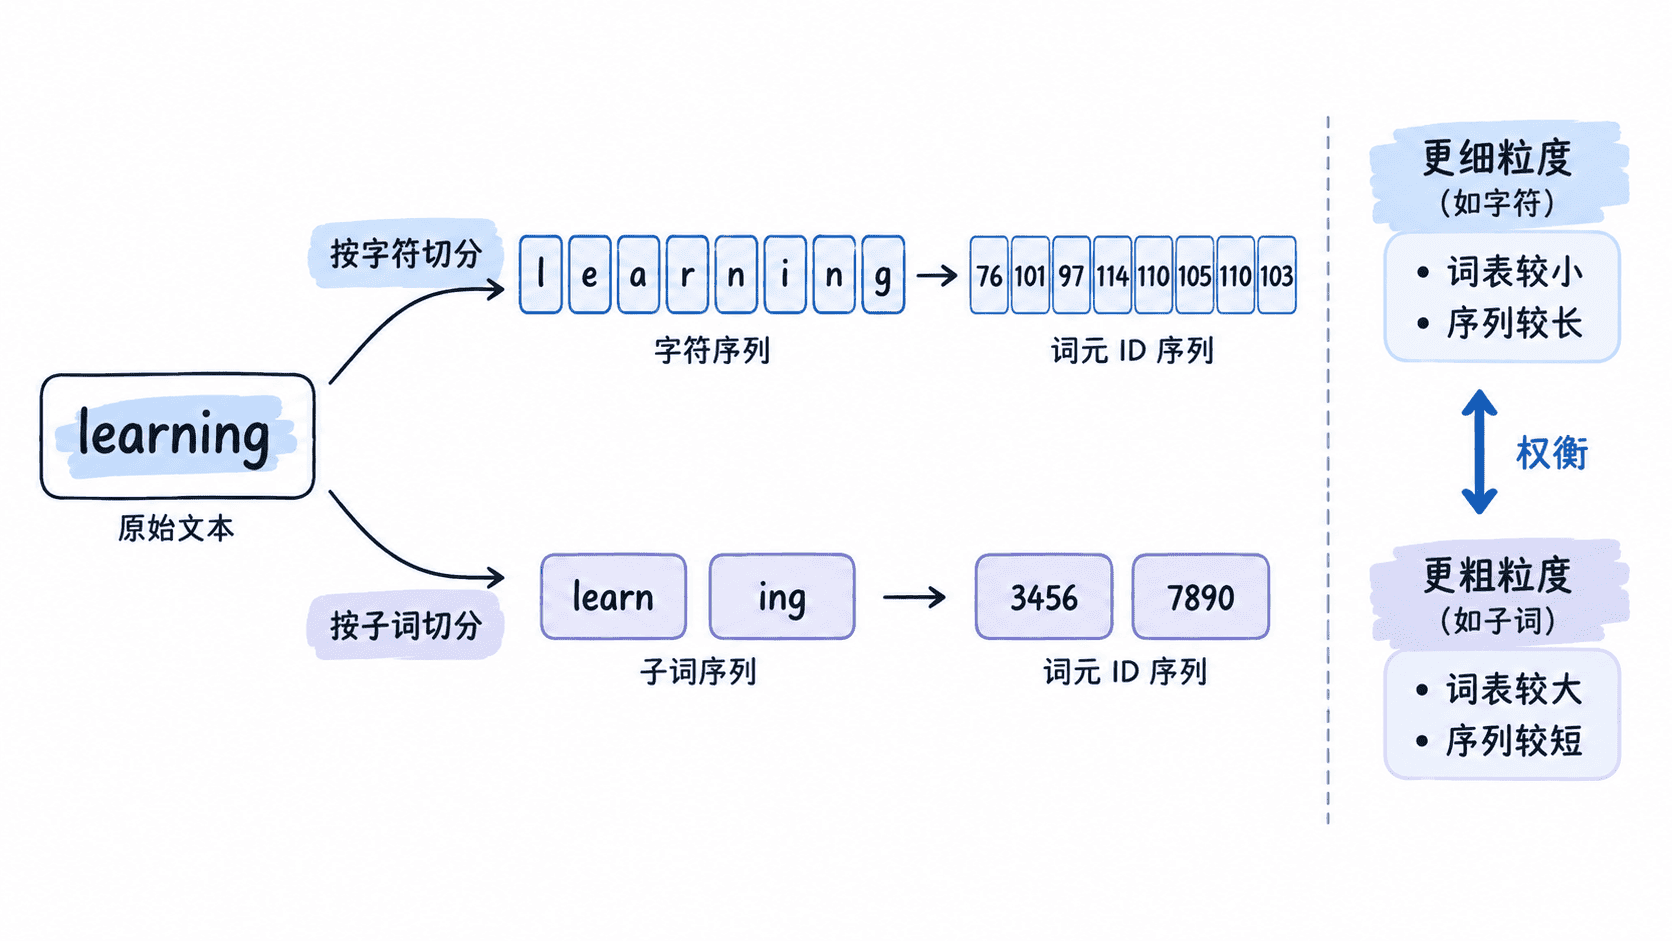
整数 ID 本身没有语言含义。learn 被编号为 42,只是因为它位于词表的某个位置;换一套 tokenizer,同一个片段完全可能得到另一个 ID。因此模型权重必须和训练时使用的 tokenizer、词表保持匹配。
为什么通常使用子词
如果把完整单词作为词元,常见单词可以只占一个位置,序列很短,但词表会迅速膨胀,而且新词、拼写变化和罕见词很难覆盖。若只使用字符,词表容易保持很小,却会让同一句话变成更长的序列。
子词方法位于两者之间。高频片段可以保留为较大的词元,低频词则继续拆成更小片段。这样既能限制词表规模,也能通过已有片段组合出训练时没有完整出现过的文本。
| 切分粒度 | 典型词表 | 序列长度 | 主要特点 |
|---|---|---|---|
| 字符 | 较小 | 较长 | 覆盖能力强,但一次输入能容纳的语义内容较少 |
| 完整单词 | 很大 | 较短 | 常见文本紧凑,但罕见词和新词处理困难 |
| 子词 | 中等 | 中等 | 在词表大小、序列长度和覆盖能力之间折中 |
这里的长短是总体趋势,不是固定规则。实际结果由训练语料、词表大小和具体分词算法共同决定。
手工走一遍编码过程
假设一个极小词表包含 我、喜欢、机器、学习 四个词元,它们对应的 ID 分别为 10、21、35、36。文本 我喜欢机器学习 可以先切成四个词元,再查词表得到整数序列。
vocab = {
    "我": 10,
    "喜欢": 21,
    "机器": 35,
    "学习": 36,
}

tokens = ["我", "喜欢", "机器", "学习"]
token_ids = [vocab[token] for token in tokens]

print(tokens)
print(token_ids)
预期输出
['我', '喜欢', '机器', '学习']
[10, 21, 35, 36]
这个示例省略了真正 tokenizer 中最复杂的“如何决定切在哪里”,只保留了核心数据形态:文本 → 词元序列 → ID 序列。真实 tokenizer 还会处理标点、空白、特殊符号以及模型定义的特殊词元。
分词粒度会影响模型看到多少内容
Transformer 的上下文窗口通常以词元数量计量,而不是按汉字数、单词数或字节数计量。若同一段文本被切成 100 个词元,它占用的上下文位置就比切成 60 个词元更多,也会带来更多注意力计算。
因此不能把“一个 token”理解成固定数量的字符。评估提示词长度、训练样本截断位置或推理成本时,都应该使用目标模型自己的 tokenizer 统计实际词元数,而不是直接按照字数估算。
只要记住数据链路即可:Tokenizer 决定如何切分,词表决定每个词元对应哪个整数 ID;模型真正接收的是这些 ID,随后再由 Embedding 把离散编号转换成可计算的连续向量。