
大模型原理与训练 / 系统课时
区分编码器与解码器信息流
区分编码器与解码器信息流
Transformer 的“编码器”和“解码器”并不只是两个模块名称,真正的差别在于每个位置能看到哪些信息、注意力从哪里取数据。本篇把双向编码器、带交叉注意力的解码器和 Decoder-only 放在同一张信息流图里比较,建立判断模型结构的统一视角。
学习目标
- 根据注意力可见范围区分双向编码器、经典解码器和 Decoder-only
- 解释自注意力、因果自注意力与交叉注意力各自读取什么信息
- 判断 BERT、原始 Transformer 翻译模型与 GPT 分别属于哪种信息流
先看每个位置能看到什么
注意力结构最关键的问题不是模块叫 Encoder 还是 Decoder,而是当前 token 在计算表示时允许读取哪些位置的信息。
双向编码器中的一个位置通常可以关注同一序列里的所有位置。句子“猫坐在垫子上”中的“坐”既能读取左侧的“猫”,也能读取右侧的“垫子”。因此编码后的表示会综合完整上下文,适合理解、分类和抽取等任务。
自回归解码器必须遵守因果约束。预测当前位置后续内容时,只允许读取当前及此前的位置,不能提前看到未来 token。否则训练时模型会从答案本身泄漏信息。
三种结构的信息流差异
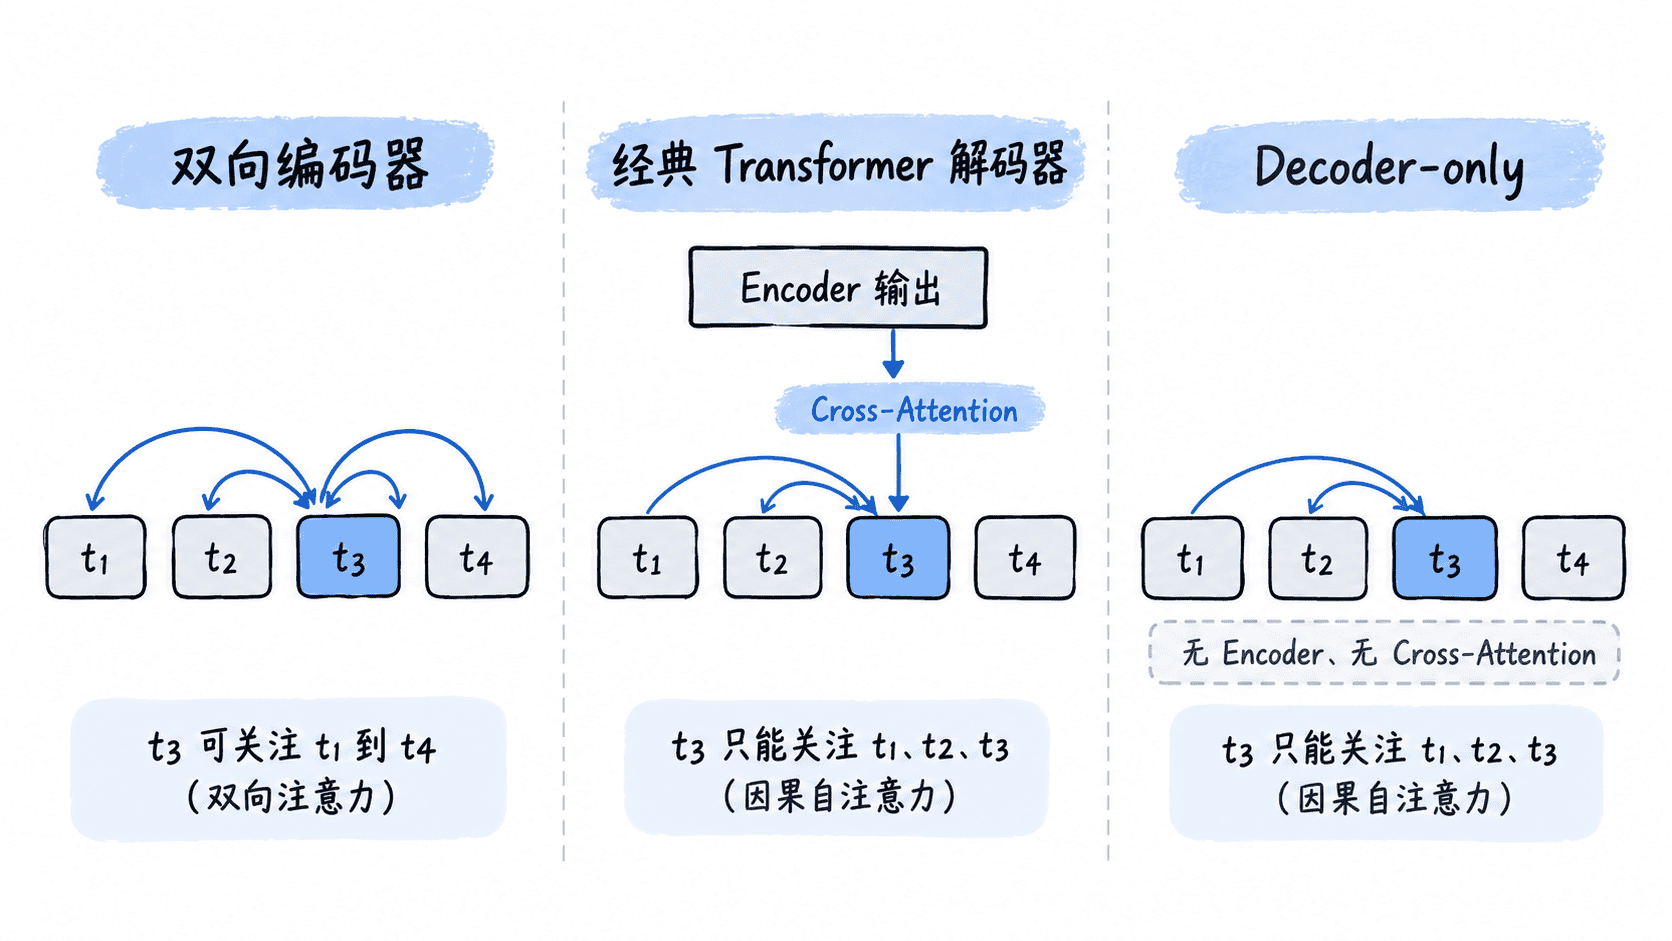
三类结构可以用三个问题快速区分:
| 结构 | 同一序列的可见范围 | 是否读取另一序列 | 典型用途 |
|---|---|---|---|
| 双向编码器 | 左右两侧都可见 | 通常不需要 | 文本理解、表示学习 |
| 经典解码器 | 只能看当前位置及之前 | 通过交叉注意力读取 Encoder 输出 | 翻译等序列到序列任务 |
| Decoder-only | 只能看当前位置及之前 | 没有独立 Encoder | 自回归语言建模 |
这里最容易混淆的是后两种。原始 Transformer 的 Decoder 并不只有因果自注意力:它还包含 Cross-Attention,用当前解码状态作为查询,去读取 Encoder 对源序列产生的表示。例如翻译时,目标端已经生成的词负责形成查询,源语言整句的编码结果负责提供可读取的上下文。
GPT 所说的 Decoder-only 则更彻底:整个模型中没有独立 Encoder,也就没有可供交叉注意力读取的 Encoder 输出。输入提示、上下文和已经生成的 token 全部放进同一条序列,由因果自注意力统一处理。
注意力类型决定信息边界
普通双向自注意力中,Query、Key、Value 都来自同一序列,并且原则上任意位置之间都可以建立注意力关系。它强调的是“整段内容如何互相解释”。
因果自注意力同样让 Query、Key、Value 来自同一序列,但会屏蔽未来位置。例如计算第 3 个位置时,只允许访问第 1、2、3 个位置,第 4 个位置不可见。这个约束让训练时的并行计算仍然满足自回归生成规则。
交叉注意力则连接两条信息流:Query 来自 Decoder 当前状态,Key 和 Value 来自 Encoder 输出。它解决的是“目标序列当前该如何从源序列取信息”,而不是控制目标序列内部能否看到未来。
用典型模型反推结构
BERT 类模型需要根据左右文共同理解一个位置,因此核心是双向编码器式信息流。经典 Transformer 机器翻译模型先把源语言交给 Encoder,再由 Decoder 在因果约束下生成目标语言,同时通过交叉注意力读取源语言表示。
GPT 则把提示词与后续文本视为同一条不断增长的序列,只保留因果自注意力。它虽然沿用了“Decoder”这个名称,但并不等同于原始 Transformer Decoder:最关键的删除项就是 Encoder 以及依赖它的交叉注意力层。
以后看到一个 Transformer 变体时,与其先记它属于哪个家族,不如先问两个问题:当前位置能否看到未来 token,以及模型中是否存在另一条被交叉注意力读取的信息流。回答这两个问题,通常就能准确判断它的核心结构。