
大模型原理与训练 / 系统课时
区分预训练与指令微调
区分预训练与指令微调
预训练让模型学会根据已有文本预测后续内容,指令微调则用成对的任务示范改变模型面对请求时的输出习惯。本篇从数据、训练信号和最终能力三个角度拆开这两个阶段,避免把“语言建模能力”直接等同于“指令遵循能力”。
学习目标
- 区分预训练与指令微调的数据形式和训练目标
- 解释基础模型为什么擅长续写却不一定按要求回答
- 理解指令微调如何在保留语言能力的基础上塑造交互行为
两个阶段解决的问题不同
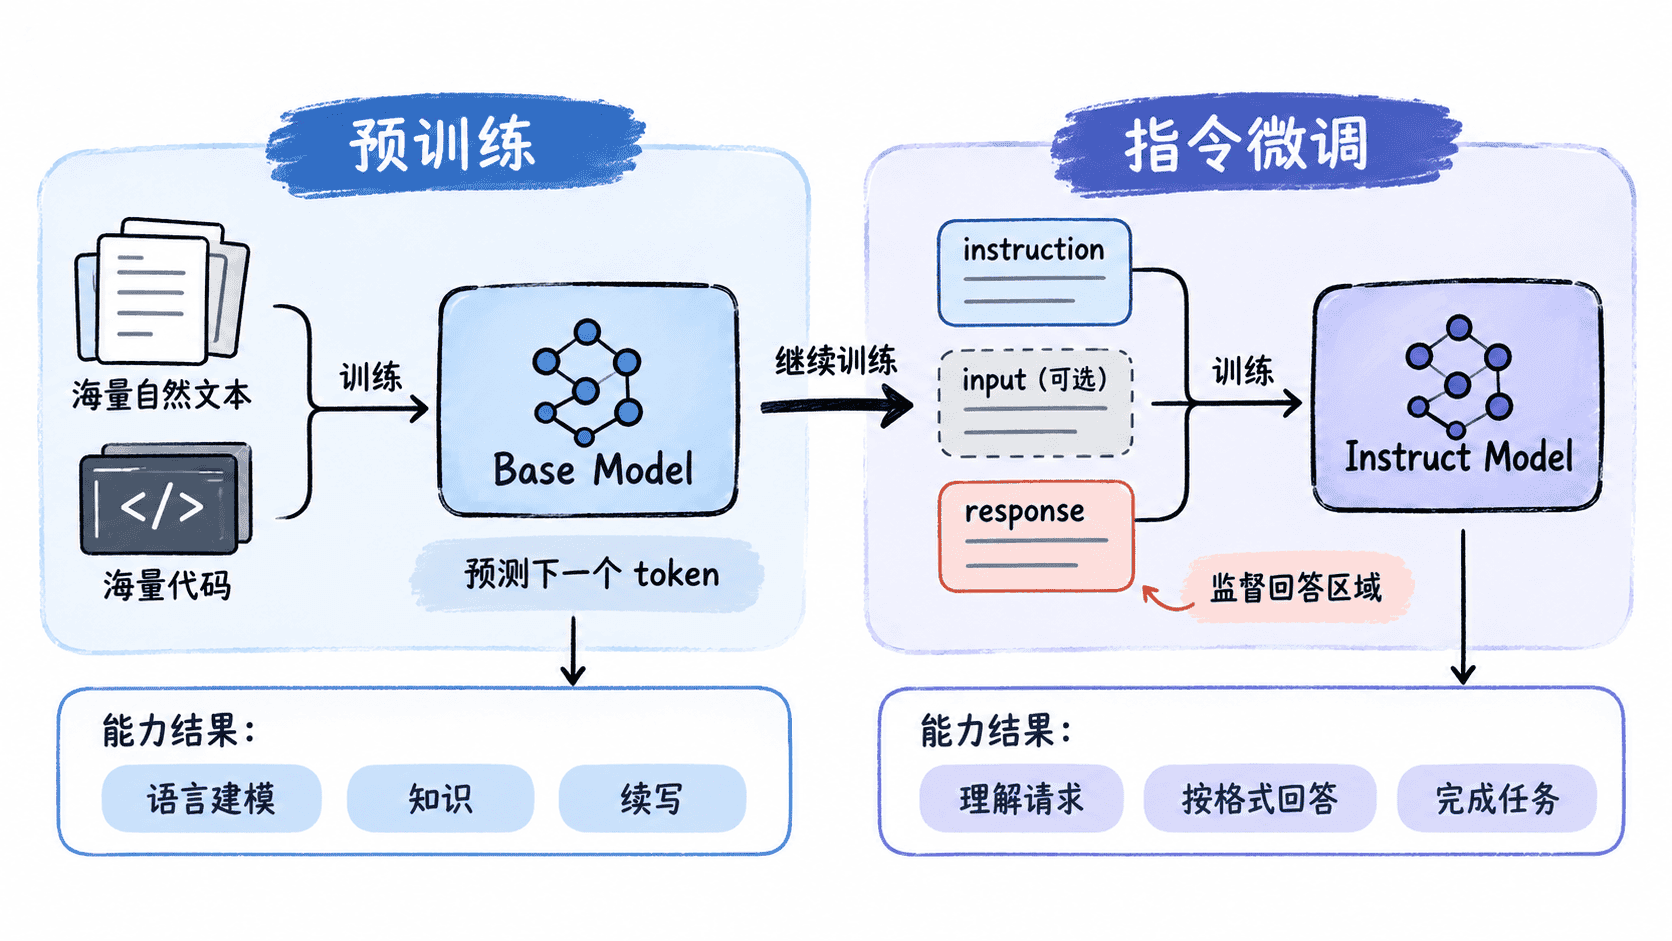
预训练面对的是海量自然文本。训练样本可以来自书籍、网页、代码或其他语料,模型不断根据前面的 token 预测下一个 token。它学到的是语言规律、事实关联、写作模式以及一定程度的推理模式,但训练数据通常没有明确告诉模型“用户提出要求后应该怎样作答”。
指令微调通常从已经完成预训练的模型继续训练。数据被组织成“请求—理想回答”形式,例如要求总结一段文字、解释概念或完成分类任务。此时模型不仅看到语言本身,还反复看到一种稳定模式:收到什么样的请求,应当产生什么样的响应。
目标函数相似不等于能力相同
两阶段常常都建立在自回归语言模型的下一 token 预测上,因此不能简单理解成“预训练使用语言模型目标,指令微调换成了另一种完全不同的目标函数”。真正发生变化的关键是训练数据分布和监督位置。
预训练会在连续文本的大量位置计算预测误差,模型主要学习“什么文本接下来最可能出现”。指令微调则把训练样本组织成对话或任务模板,很多训练方案还会只让回答部分参与损失计算,使优化方向更直接地指向“给定请求时生成期望回答”。具体是否屏蔽提示部分取决于训练实现,但这种差异不会改变核心认识:监督样本在塑造交互行为。
为什么基础模型可能只会继续写
假设输入是“请用一句话解释光合作用”。一个只经过预训练的模型知道这些词之间的语言关系,却未必把它稳定识别为必须执行的命令。它可能直接给出答案,也可能继续补写类似教材、问答列表甚至网页中的后续文本,因为这些形式都可能符合预训练阶段学到的续写概率。
经过高质量指令样本训练后,模型反复观察到“请求后紧跟符合要求的回答”,于是生成概率会更多集中到这种交互模式上。模型原有的语言知识并没有被替换,而是被重新组织到更容易被指令调用的输出行为中。
用三个维度快速判断
| 维度 | 预训练 | 指令微调 |
|---|---|---|
| 典型数据 | 连续自然文本、代码等 | 指令与理想响应样本 |
| 主要作用 | 学习语言、知识与模式 | 塑造请求到回答的行为映射 |
| 典型产物 | Base Model | Instruct 或 Chat Model |
因此,“会续写文本”和“会遵循指令”不是两套彼此独立的模型能力,却也不能画等号。预训练提供广泛的语言与知识基础,指令微调进一步改变模型在特定上下文中的输出分布,让这些基础能力更稳定地表现为面向用户任务的回答。